Myo1e cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

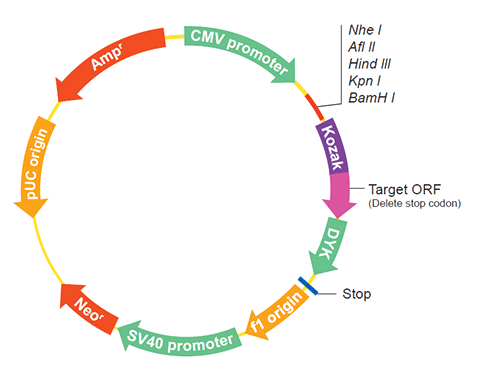
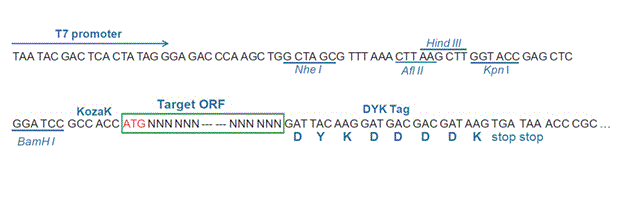
The following Myo1e gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Myo1e cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa20241 XM_008836873.3
Latest version!
Nannospalax galili myosin IE (Myo1e), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
View Old Accession Versions >>
ONa20241 XM_008836873.2 Nannospalax galili myosin IE (Myo1e), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa20241
    Clone ID Related Accession (Same CDS sequence) XM_008836873.3 , XM_008836873.2
    Accession Version XM_008836873.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3327bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product unconventional myosin-Ie
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008341422.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008836873.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGGAAGCA AAGGAGCCTA CCGGTACCAC TGGCAGAGTC ACAATGTCAA GCACAGTGGC 
    GTGGATGACA TGGTGCTGCT CTCGAAGATC ACAGAGAGCT CAATCGTGGA GAACCTCAAG
    AAGAGATACA TGGACGACTA TATCTTTACA TATATAGGAT CCGTGTTAAT CTCCGTCAAC
    CCTTTCAAGC ATATGCCGTA TTTTGGGGAA AAAGAAATTG AAATGTACCA AGGAGCGGCA
    CAGTATGAAA ATCCACCTCA TATTTATGCA CTCGCAGACA GTATGTACCG AAACATGATC
    ATCGACAGGG AGAACCAATG TGTTATCATC AGCGGTGAGA GCGGTGCTGG TAAGACAGTG
    GCTGCAAAAT ACATCATGGG CTACATCTCC AGAGTGTCCG GAGGAGGCCC CAAGGTCCAG
    CACGTCAAGG ATATCATCCT GCAATCTAAC CCACTGCTGG AGGCCTTCGG GAACGCCAAG
    ACTGTACGCA ACAACAACTC CAGCCGATTT GGAAAATACT TTGAAATCCA GTTCAGTCCA
    GGTGGGGAGC CAGATGGTGG AAAGATCTCC AACTTCCTTC TGGAAAAGTC CAGGGTGGTG
    ATGAGGAACC CTGGAGAGAG AAGCTTTCAC ATCTTCTACC AGCTCATTGA GGGGGCCTCT
    CCAGAGCAGA AGCAAAGCCT GGGCATCACC AGCATGGATT ATTATTACTA CCTGAGCCTC
    TCGGGGTCCT ACAAGGTTGA TGACATTGAT GACAAGCGGG AGTTCCAGGA AACCCTGCAC
    GCCATGAATG TGATTGGGAT CTTCGCAGAA GAACAGACAC TAGTGTTGCA GATTGTGGCA
    GGAATTCTCC ATGTGGGAAA CATCAGCTTC AAAGAAGTGG GCAACTATGC GGCGGTGGAG
    AGTGAGGAGT TTTTGGCTTT TCCTGCATAT CTGCTGGGCA TAAACCAAGA CCGGTTAAAA
    GAGAAGCTAA CGAGCCGGCA GATGGACAGC AAGTGGGGGG GTAAATCAGA ATCCATCCAC
    GTGACCCTCA ATGCAGAGCA GGCTTGCTAC AGCAGGGATG CACTTGCCAA GGCCCTGCAC
    GCCCGCCTCT TTGACTTCTT GGTGGATTCC ATCAACAAAG CCATGGAGAA GGACCATGAG
    GAATACAACA TTGGAGTCCT GGACATCTAT GGCTTTGAAA TATTCCAGAA AAATGGCTTT
    GAACAGTTCT GCATCAATTT TGTTAATGAA AAATTACAGC AGATTTTCAT TGAGCTGACA
    TTAAAAGCAG AACAGGAGGA ATACGTTCAA GAGGGAATAA GATGGACTCC CATTGAGTAC
    TTCAATAACA AAATCGTGTG TGACCTCATA GAGAACAAAG TGAACCCTCC GGGGATCATG
    AGCATCCTGG ATGATGTGTG CGCCACCATG CATGCCGTGG GGGAGGGTGC TGACCAGACA
    CTGCTGCAGA AGCTCCAGAT GCAGATTGGG AGCCACGAGC ACTTCAACAG CTGGAACCAA
    GGCTTCATCA TTCATCACTA TGCCGGGAAG GTTTCCTATG ACATGGATGG CTTTTGCGAG
    AGGAATCGGG ATGTACTGTT CACGGATCTG ATTGAACTTA TGCAAAGCAG TGAGCTACCT
    TTTATAAAGT CTTTATTTCC TGAAAATCTG CAAGCTGACA AGAAAGGGCG TCCAACTACT
    GCAGGAAGCA AAATAAAGAA ACAAGCCAAT GACCTTGTGA GCACGCTGAT GAAATGTACA
    CCCCACTACA TCCGCTGCAT AAAACCCAAT GAAACCAAAA AGCCCAAAGA CTGGGAGGAG
    AGCAGGGTAA AGCATCAAGT TGAATACCTG GGTCTGAAAG AAAACATTCG AGTGAGAAGA
    GCTGGCTATG CTTATAGGCG TGTCTTCCAG AAATTTCTAC AGAGGTACGC CATTCTGACC
    AAAGCCACAT GGCCTGTGTG GAGAGGTGAG GAGAAGCAAG GTGTCCTCCA TCTGCTGCAG
    TCTGTCAACA TGGACACTGA CCAGTTCCAG CTTGGGAAGA GCAAAGTGTT CATCAAAGCC
    CCAGAGTCTC TGTTTCTTCT AGAAGAGATG AGAGAAAGAA AGTACGATGG GTATGCCCGA
    GTGATACAGA AAACATGGAG AAAGTTCGTG GCCCGGAAGA AATATGTCCA AATGAGAGAA
    GAAGCCTCAG ACCTGCTGCT GAACAAAAAG GAGAGGAGAA GAAATAGCAT CAACCGGAAC
    TTCATCGGGG ACTACATCGG GATGGAGGAA CATCCGGAGC TGCAGCAGTT TGTGGGCAAG
    AGGGAGAAGA TTGACTTTGC AGACACGGTC ACCAAGTACG ACAGGCGGTT CAAGGGTGTC
    AAGCGAGATC TGCTGCTAAC TCCAAAGTGC ATGTACTTAA TTGGAAGAGA AAAAATCAAG
    CAAGGCCCAG ACAAAGGCCT GGTGAAGGAA GTCCTGAAGC GGAGAATTGA GATGGAGAGG
    ATCCTGTCTG TGTCCCTCAG CACCATGCAG GATGACATCT TCATTCTCCA TGAGCAAGAG
    TATGACAGTT TGCTTGAATC TGTCTTCAAA ACAGAATTCT TAAGCCTCTT AGCAAAGCGT
    TATGAGGAAA AAACTCAGAA GCAACTACCT CTGAAATTCA GCAATACCCT TGAACTGAAG
    TTAAAAAAGG AGAACTGGGG TCCCTGGAGT GCAGGGGGCT CCCGGCAGGT GCAGTTCCAC
    CAAGGCATTG GCGACCTGGC TATCCTCAAG CCCAGTAACA AAGTGCTGCA GGTCAGCATT
    GGACCCGGGC TGCCCAAGAA CTCCCGTCCT ACCAGAAGGA ATACCGTCCA AAGCAGAGGG
    TATTCTGGCA GAACTCAGAA TGCCAATTAC CCAATGAGAG CCGCCCCTGC ACCACCAGGA
    TATCATCAGA ATGGAGTCAT CAGAAACCAG TTTGTGCCAC CTCCCCACAC TCCTGGAAAC
    CAGAGGTCTA ATCAGAAAAG CCTGTATACC TCCATGGCTC GCCCACCCTT GCCACGGCAA
    CAGTCCACAG GCTCAGACCG ATTGTCACAG ACGCCAGAGA GCCTGGATTT CCTCAAGGTC
    CCGGACCAGG GTGCTGCAGG GGTCCGGAGA CAAACAACCA GCAGGCCTCC TCCAGCAGGC
    GGCAGACCAA AGCCCCAGCC CAAGCCCAAG CCTCAGGTGC CACAGTGCAA AGCTTTATAT
    GCTTACGACG CTCAGGACAC AGATGAGCTC AGCTTCAATG CCAACGATGT CATTGATATT
    ATTAAAGAAG ATCCTTCTGG CTGGTGGACG GGTCGACTAC GAGGCAAGCA GGGCCTGTTT
    CCAAACAACT ATGTGACCAA GATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008835095.1
    CDS380..3706
    Translation

    Target ORF information:

    RefSeq Version XM_008836873.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili myosin IE (Myo1e), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008836873.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGGAAGCA AAGGAGCCTA CCGGTACCAC TGGCAGAGTC ACAATGTCAA GCACAGTGGC 
    GTGGATGACA TGGTGCTGCT CTCGAAGATC ACAGAGAGCT CAATCGTGGA GAACCTCAAG
    AAGAGATACA TGGACGACTA TATCTTTACA TATATAGGAT CCGTGTTAAT CTCCGTCAAC
    CCTTTCAAGC ATATGCCGTA TTTTGGGGAA AAAGAAATTG AAATGTACCA AGGAGCGGCA
    CAGTATGAAA ATCCACCTCA TATTTATGCA CTCGCAGACA GTATGTACCG AAACATGATC
    ATCGACAGGG AGAACCAATG TGTTATCATC AGCGGTGAGA GCGGTGCTGG TAAGACAGTG
    GCTGCAAAAT ACATCATGGG CTACATCTCC AGAGTGTCCG GAGGAGGCCC CAAGGTCCAG
    CACGTCAAGG ATATCATCCT GCAATCTAAC CCACTGCTGG AGGCCTTCGG GAACGCCAAG
    ACTGTACGCA ACAACAACTC CAGCCGATTT GGAAAATACT TTGAAATCCA GTTCAGTCCA
    GGTGGGGAGC CAGATGGTGG AAAGATCTCC AACTTCCTTC TGGAAAAGTC CAGGGTGGTG
    ATGAGGAACC CTGGAGAGAG AAGCTTTCAC ATCTTCTACC AGCTCATTGA GGGGGCCTCT
    CCAGAGCAGA AGCAAAGCCT GGGCATCACC AGCATGGATT ATTATTACTA CCTGAGCCTC
    TCGGGGTCCT ACAAGGTTGA TGACATTGAT GACAAGCGGG AGTTCCAGGA AACCCTGCAC
    GCCATGAATG TGATTGGGAT CTTCGCAGAA GAACAGACAC TAGTGTTGCA GATTGTGGCA
    GGAATTCTCC ATGTGGGAAA CATCAGCTTC AAAGAAGTGG GCAACTATGC GGCGGTGGAG
    AGTGAGGAGT TTTTGGCTTT TCCTGCATAT CTGCTGGGCA TAAACCAAGA CCGGTTAAAA
    GAGAAGCTAA CGAGCCGGCA GATGGACAGC AAGTGGGGGG GTAAATCAGA ATCCATCCAC
    GTGACCCTCA ATGCAGAGCA GGCTTGCTAC AGCAGGGATG CACTTGCCAA GGCCCTGCAC
    GCCCGCCTCT TTGACTTCTT GGTGGATTCC ATCAACAAAG CCATGGAGAA GGACCATGAG
    GAATACAACA TTGGAGTCCT GGACATCTAT GGCTTTGAAA TATTCCAGAA AAATGGCTTT
    GAACAGTTCT GCATCAATTT TGTTAATGAA AAATTACAGC AGATTTTCAT TGAGCTGACA
    TTAAAAGCAG AACAGGAGGA ATACGTTCAA GAGGGAATAA GATGGACTCC CATTGAGTAC
    TTCAATAACA AAATCGTGTG TGACCTCATA GAGAACAAAG TGAACCCTCC GGGGATCATG
    AGCATCCTGG ATGATGTGTG CGCCACCATG CATGCCGTGG GGGAGGGTGC TGACCAGACA
    CTGCTGCAGA AGCTCCAGAT GCAGATTGGG AGCCACGAGC ACTTCAACAG CTGGAACCAA
    GGCTTCATCA TTCATCACTA TGCCGGGAAG GTTTCCTATG ACATGGATGG CTTTTGCGAG
    AGGAATCGGG ATGTACTGTT CACGGATCTG ATTGAACTTA TGCAAAGCAG TGAGCTACCT
    TTTATAAAGT CTTTATTTCC TGAAAATCTG CAAGCTGACA AGAAAGGGCG TCCAACTACT
    GCAGGAAGCA AAATAAAGAA ACAAGCCAAT GACCTTGTGA GCACGCTGAT GAAATGTACA
    CCCCACTACA TCCGCTGCAT AAAACCCAAT GAAACCAAAA AGCCCAAAGA CTGGGAGGAG
    AGCAGGGTAA AGCATCAAGT TGAATACCTG GGTCTGAAAG AAAACATTCG AGTGAGAAGA
    GCTGGCTATG CTTATAGGCG TGTCTTCCAG AAATTTCTAC AGAGGTACGC CATTCTGACC
    AAAGCCACAT GGCCTGTGTG GAGAGGTGAG GAGAAGCAAG GTGTCCTCCA TCTGCTGCAG
    TCTGTCAACA TGGACACTGA CCAGTTCCAG CTTGGGAAGA GCAAAGTGTT CATCAAAGCC
    CCAGAGTCTC TGTTTCTTCT AGAAGAGATG AGAGAAAGAA AGTACGATGG GTATGCCCGA
    GTGATACAGA AAACATGGAG AAAGTTCGTG GCCCGGAAGA AATATGTCCA AATGAGAGAA
    GAAGCCTCAG ACCTGCTGCT GAACAAAAAG GAGAGGAGAA GAAATAGCAT CAACCGGAAC
    TTCATCGGGG ACTACATCGG GATGGAGGAA CATCCGGAGC TGCAGCAGTT TGTGGGCAAG
    AGGGAGAAGA TTGACTTTGC AGACACGGTC ACCAAGTACG ACAGGCGGTT CAAGGGTGTC
    AAGCGAGATC TGCTGCTAAC TCCAAAGTGC ATGTACTTAA TTGGAAGAGA AAAAATCAAG
    CAAGGCCCAG ACAAAGGCCT GGTGAAGGAA GTCCTGAAGC GGAGAATTGA GATGGAGAGG
    ATCCTGTCTG TGTCCCTCAG CACCATGCAG GATGACATCT TCATTCTCCA TGAGCAAGAG
    TATGACAGTT TGCTTGAATC TGTCTTCAAA ACAGAATTCT TAAGCCTCTT AGCAAAGCGT
    TATGAGGAAA AAACTCAGAA GCAACTACCT CTGAAATTCA GCAATACCCT TGAACTGAAG
    TTAAAAAAGG AGAACTGGGG TCCCTGGAGT GCAGGGGGCT CCCGGCAGGT GCAGTTCCAC
    CAAGGCATTG GCGACCTGGC TATCCTCAAG CCCAGTAACA AAGTGCTGCA GGTCAGCATT
    GGACCCGGGC TGCCCAAGAA CTCCCGTCCT ACCAGAAGGA ATACCGTCCA AAGCAGAGGG
    TATTCTGGCA GAACTCAGAA TGCCAATTAC CCAATGAGAG CCGCCCCTGC ACCACCAGGA
    TATCATCAGA ATGGAGTCAT CAGAAACCAG TTTGTGCCAC CTCCCCACAC TCCTGGAAAC
    CAGAGGTCTA ATCAGAAAAG CCTGTATACC TCCATGGCTC GCCCACCCTT GCCACGGCAA
    CAGTCCACAG GCTCAGACCG ATTGTCACAG ACGCCAGAGA GCCTGGATTT CCTCAAGGTC
    CCGGACCAGG GTGCTGCAGG GGTCCGGAGA CAAACAACCA GCAGGCCTCC TCCAGCAGGC
    GGCAGACCAA AGCCCCAGCC CAAGCCCAAG CCTCAGGTGC CACAGTGCAA AGCTTTATAT
    GCTTACGACG CTCAGGACAC AGATGAGCTC AGCTTCAATG CCAACGATGT CATTGATATT
    ATTAAAGAAG ATCCTTCTGG CTGGTGGACG GGTCGACTAC GAGGCAAGCA GGGCCTGTTT
    CCAAACAACT ATGTGACCAA GATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa20241
    Clone ID Related Accession (Same CDS sequence) XM_008836873.3 , XM_008836873.2
    Accession Version XM_008836873.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3327bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product unconventional myosin-Ie
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008341422.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008836873.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGGAAGCA AAGGAGCCTA CCGGTACCAC TGGCAGAGTC ACAATGTCAA GCACAGTGGC 
    GTGGATGACA TGGTGCTGCT CTCGAAGATC ACAGAGAGCT CAATCGTGGA GAACCTCAAG
    AAGAGATACA TGGACGACTA TATCTTTACA TATATAGGAT CCGTGTTAAT CTCCGTCAAC
    CCTTTCAAGC ATATGCCGTA TTTTGGGGAA AAAGAAATTG AAATGTACCA AGGAGCGGCA
    CAGTATGAAA ATCCACCTCA TATTTATGCA CTCGCAGACA GTATGTACCG AAACATGATC
    ATCGACAGGG AGAACCAATG TGTTATCATC AGCGGTGAGA GCGGTGCTGG TAAGACAGTG
    GCTGCAAAAT ACATCATGGG CTACATCTCC AGAGTGTCCG GAGGAGGCCC CAAGGTCCAG
    CACGTCAAGG ATATCATCCT GCAATCTAAC CCACTGCTGG AGGCCTTCGG GAACGCCAAG
    ACTGTACGCA ACAACAACTC CAGCCGATTT GGAAAATACT TTGAAATCCA GTTCAGTCCA
    GGTGGGGAGC CAGATGGTGG AAAGATCTCC AACTTCCTTC TGGAAAAGTC CAGGGTGGTG
    ATGAGGAACC CTGGAGAGAG AAGCTTTCAC ATCTTCTACC AGCTCATTGA GGGGGCCTCT
    CCAGAGCAGA AGCAAAGCCT GGGCATCACC AGCATGGATT ATTATTACTA CCTGAGCCTC
    TCGGGGTCCT ACAAGGTTGA TGACATTGAT GACAAGCGGG AGTTCCAGGA AACCCTGCAC
    GCCATGAATG TGATTGGGAT CTTCGCAGAA GAACAGACAC TAGTGTTGCA GATTGTGGCA
    GGAATTCTCC ATGTGGGAAA CATCAGCTTC AAAGAAGTGG GCAACTATGC GGCGGTGGAG
    AGTGAGGAGT TTTTGGCTTT TCCTGCATAT CTGCTGGGCA TAAACCAAGA CCGGTTAAAA
    GAGAAGCTAA CGAGCCGGCA GATGGACAGC AAGTGGGGGG GTAAATCAGA ATCCATCCAC
    GTGACCCTCA ATGCAGAGCA GGCTTGCTAC AGCAGGGATG CACTTGCCAA GGCCCTGCAC
    GCCCGCCTCT TTGACTTCTT GGTGGATTCC ATCAACAAAG CCATGGAGAA GGACCATGAG
    GAATACAACA TTGGAGTCCT GGACATCTAT GGCTTTGAAA TATTCCAGAA AAATGGCTTT
    GAACAGTTCT GCATCAATTT TGTTAATGAA AAATTACAGC AGATTTTCAT TGAGCTGACA
    TTAAAAGCAG AACAGGAGGA ATACGTTCAA GAGGGAATAA GATGGACTCC CATTGAGTAC
    TTCAATAACA AAATCGTGTG TGACCTCATA GAGAACAAAG TGAACCCTCC GGGGATCATG
    AGCATCCTGG ATGATGTGTG CGCCACCATG CATGCCGTGG GGGAGGGTGC TGACCAGACA
    CTGCTGCAGA AGCTCCAGAT GCAGATTGGG AGCCACGAGC ACTTCAACAG CTGGAACCAA
    GGCTTCATCA TTCATCACTA TGCCGGGAAG GTTTCCTATG ACATGGATGG CTTTTGCGAG
    AGGAATCGGG ATGTACTGTT CACGGATCTG ATTGAACTTA TGCAAAGCAG TGAGCTACCT
    TTTATAAAGT CTTTATTTCC TGAAAATCTG CAAGCTGACA AGAAAGGGCG TCCAACTACT
    GCAGGAAGCA AAATAAAGAA ACAAGCCAAT GACCTTGTGA GCACGCTGAT GAAATGTACA
    CCCCACTACA TCCGCTGCAT AAAACCCAAT GAAACCAAAA AGCCCAAAGA CTGGGAGGAG
    AGCAGGGTAA AGCATCAAGT TGAATACCTG GGTCTGAAAG AAAACATTCG AGTGAGAAGA
    GCTGGCTATG CTTATAGGCG TGTCTTCCAG AAATTTCTAC AGAGGTACGC CATTCTGACC
    AAAGCCACAT GGCCTGTGTG GAGAGGTGAG GAGAAGCAAG GTGTCCTCCA TCTGCTGCAG
    TCTGTCAACA TGGACACTGA CCAGTTCCAG CTTGGGAAGA GCAAAGTGTT CATCAAAGCC
    CCAGAGTCTC TGTTTCTTCT AGAAGAGATG AGAGAAAGAA AGTACGATGG GTATGCCCGA
    GTGATACAGA AAACATGGAG AAAGTTCGTG GCCCGGAAGA AATATGTCCA AATGAGAGAA
    GAAGCCTCAG ACCTGCTGCT GAACAAAAAG GAGAGGAGAA GAAATAGCAT CAACCGGAAC
    TTCATCGGGG ACTACATCGG GATGGAGGAA CATCCGGAGC TGCAGCAGTT TGTGGGCAAG
    AGGGAGAAGA TTGACTTTGC AGACACGGTC ACCAAGTACG ACAGGCGGTT CAAGGGTGTC
    AAGCGAGATC TGCTGCTAAC TCCAAAGTGC ATGTACTTAA TTGGAAGAGA AAAAATCAAG
    CAAGGCCCAG ACAAAGGCCT GGTGAAGGAA GTCCTGAAGC GGAGAATTGA GATGGAGAGG
    ATCCTGTCTG TGTCCCTCAG CACCATGCAG GATGACATCT TCATTCTCCA TGAGCAAGAG
    TATGACAGTT TGCTTGAATC TGTCTTCAAA ACAGAATTCT TAAGCCTCTT AGCAAAGCGT
    TATGAGGAAA AAACTCAGAA GCAACTACCT CTGAAATTCA GCAATACCCT TGAACTGAAG
    TTAAAAAAGG AGAACTGGGG TCCCTGGAGT GCAGGGGGCT CCCGGCAGGT GCAGTTCCAC
    CAAGGCATTG GCGACCTGGC TATCCTCAAG CCCAGTAACA AAGTGCTGCA GGTCAGCATT
    GGACCCGGGC TGCCCAAGAA CTCCCGTCCT ACCAGAAGGA ATACCGTCCA AAGCAGAGGG
    TATTCTGGCA GAACTCAGAA TGCCAATTAC CCAATGAGAG CCGCCCCTGC ACCACCAGGA
    TATCATCAGA ATGGAGTCAT CAGAAACCAG TTTGTGCCAC CTCCCCACAC TCCTGGAAAC
    CAGAGGTCTA ATCAGAAAAG CCTGTATACC TCCATGGCTC GCCCACCCTT GCCACGGCAA
    CAGTCCACAG GCTCAGACCG ATTGTCACAG ACGCCAGAGA GCCTGGATTT CCTCAAGGTC
    CCGGACCAGG GTGCTGCAGG GGTCCGGAGA CAAACAACCA GCAGGCCTCC TCCAGCAGGC
    GGCAGACCAA AGCCCCAGCC CAAGCCCAAG CCTCAGGTGC CACAGTGCAA AGCTTTATAT
    GCTTACGACG CTCAGGACAC AGATGAGCTC AGCTTCAATG CCAACGATGT CATTGATATT
    ATTAAAGAAG ATCCTTCTGG CTGGTGGACG GGTCGACTAC GAGGCAAGCA GGGCCTGTTT
    CCAAACAACT ATGTGACCAA GATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008835095.1
    CDS376..3702
    Translation

    Target ORF information:

    RefSeq Version XM_008836873.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili myosin IE (Myo1e), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008836873.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGGGAAGCA AAGGAGCCTA CCGGTACCAC TGGCAGAGTC ACAATGTCAA GCACAGTGGC 
    GTGGATGACA TGGTGCTGCT CTCGAAGATC ACAGAGAGCT CAATCGTGGA GAACCTCAAG
    AAGAGATACA TGGACGACTA TATCTTTACA TATATAGGAT CCGTGTTAAT CTCCGTCAAC
    CCTTTCAAGC ATATGCCGTA TTTTGGGGAA AAAGAAATTG AAATGTACCA AGGAGCGGCA
    CAGTATGAAA ATCCACCTCA TATTTATGCA CTCGCAGACA GTATGTACCG AAACATGATC
    ATCGACAGGG AGAACCAATG TGTTATCATC AGCGGTGAGA GCGGTGCTGG TAAGACAGTG
    GCTGCAAAAT ACATCATGGG CTACATCTCC AGAGTGTCCG GAGGAGGCCC CAAGGTCCAG
    CACGTCAAGG ATATCATCCT GCAATCTAAC CCACTGCTGG AGGCCTTCGG GAACGCCAAG
    ACTGTACGCA ACAACAACTC CAGCCGATTT GGAAAATACT TTGAAATCCA GTTCAGTCCA
    GGTGGGGAGC CAGATGGTGG AAAGATCTCC AACTTCCTTC TGGAAAAGTC CAGGGTGGTG
    ATGAGGAACC CTGGAGAGAG AAGCTTTCAC ATCTTCTACC AGCTCATTGA GGGGGCCTCT
    CCAGAGCAGA AGCAAAGCCT GGGCATCACC AGCATGGATT ATTATTACTA CCTGAGCCTC
    TCGGGGTCCT ACAAGGTTGA TGACATTGAT GACAAGCGGG AGTTCCAGGA AACCCTGCAC
    GCCATGAATG TGATTGGGAT CTTCGCAGAA GAACAGACAC TAGTGTTGCA GATTGTGGCA
    GGAATTCTCC ATGTGGGAAA CATCAGCTTC AAAGAAGTGG GCAACTATGC GGCGGTGGAG
    AGTGAGGAGT TTTTGGCTTT TCCTGCATAT CTGCTGGGCA TAAACCAAGA CCGGTTAAAA
    GAGAAGCTAA CGAGCCGGCA GATGGACAGC AAGTGGGGGG GTAAATCAGA ATCCATCCAC
    GTGACCCTCA ATGCAGAGCA GGCTTGCTAC AGCAGGGATG CACTTGCCAA GGCCCTGCAC
    GCCCGCCTCT TTGACTTCTT GGTGGATTCC ATCAACAAAG CCATGGAGAA GGACCATGAG
    GAATACAACA TTGGAGTCCT GGACATCTAT GGCTTTGAAA TATTCCAGAA AAATGGCTTT
    GAACAGTTCT GCATCAATTT TGTTAATGAA AAATTACAGC AGATTTTCAT TGAGCTGACA
    TTAAAAGCAG AACAGGAGGA ATACGTTCAA GAGGGAATAA GATGGACTCC CATTGAGTAC
    TTCAATAACA AAATCGTGTG TGACCTCATA GAGAACAAAG TGAACCCTCC GGGGATCATG
    AGCATCCTGG ATGATGTGTG CGCCACCATG CATGCCGTGG GGGAGGGTGC TGACCAGACA
    CTGCTGCAGA AGCTCCAGAT GCAGATTGGG AGCCACGAGC ACTTCAACAG CTGGAACCAA
    GGCTTCATCA TTCATCACTA TGCCGGGAAG GTTTCCTATG ACATGGATGG CTTTTGCGAG
    AGGAATCGGG ATGTACTGTT CACGGATCTG ATTGAACTTA TGCAAAGCAG TGAGCTACCT
    TTTATAAAGT CTTTATTTCC TGAAAATCTG CAAGCTGACA AGAAAGGGCG TCCAACTACT
    GCAGGAAGCA AAATAAAGAA ACAAGCCAAT GACCTTGTGA GCACGCTGAT GAAATGTACA
    CCCCACTACA TCCGCTGCAT AAAACCCAAT GAAACCAAAA AGCCCAAAGA CTGGGAGGAG
    AGCAGGGTAA AGCATCAAGT TGAATACCTG GGTCTGAAAG AAAACATTCG AGTGAGAAGA
    GCTGGCTATG CTTATAGGCG TGTCTTCCAG AAATTTCTAC AGAGGTACGC CATTCTGACC
    AAAGCCACAT GGCCTGTGTG GAGAGGTGAG GAGAAGCAAG GTGTCCTCCA TCTGCTGCAG
    TCTGTCAACA TGGACACTGA CCAGTTCCAG CTTGGGAAGA GCAAAGTGTT CATCAAAGCC
    CCAGAGTCTC TGTTTCTTCT AGAAGAGATG AGAGAAAGAA AGTACGATGG GTATGCCCGA
    GTGATACAGA AAACATGGAG AAAGTTCGTG GCCCGGAAGA AATATGTCCA AATGAGAGAA
    GAAGCCTCAG ACCTGCTGCT GAACAAAAAG GAGAGGAGAA GAAATAGCAT CAACCGGAAC
    TTCATCGGGG ACTACATCGG GATGGAGGAA CATCCGGAGC TGCAGCAGTT TGTGGGCAAG
    AGGGAGAAGA TTGACTTTGC AGACACGGTC ACCAAGTACG ACAGGCGGTT CAAGGGTGTC
    AAGCGAGATC TGCTGCTAAC TCCAAAGTGC ATGTACTTAA TTGGAAGAGA AAAAATCAAG
    CAAGGCCCAG ACAAAGGCCT GGTGAAGGAA GTCCTGAAGC GGAGAATTGA GATGGAGAGG
    ATCCTGTCTG TGTCCCTCAG CACCATGCAG GATGACATCT TCATTCTCCA TGAGCAAGAG
    TATGACAGTT TGCTTGAATC TGTCTTCAAA ACAGAATTCT TAAGCCTCTT AGCAAAGCGT
    TATGAGGAAA AAACTCAGAA GCAACTACCT CTGAAATTCA GCAATACCCT TGAACTGAAG
    TTAAAAAAGG AGAACTGGGG TCCCTGGAGT GCAGGGGGCT CCCGGCAGGT GCAGTTCCAC
    CAAGGCATTG GCGACCTGGC TATCCTCAAG CCCAGTAACA AAGTGCTGCA GGTCAGCATT
    GGACCCGGGC TGCCCAAGAA CTCCCGTCCT ACCAGAAGGA ATACCGTCCA AAGCAGAGGG
    TATTCTGGCA GAACTCAGAA TGCCAATTAC CCAATGAGAG CCGCCCCTGC ACCACCAGGA
    TATCATCAGA ATGGAGTCAT CAGAAACCAG TTTGTGCCAC CTCCCCACAC TCCTGGAAAC
    CAGAGGTCTA ATCAGAAAAG CCTGTATACC TCCATGGCTC GCCCACCCTT GCCACGGCAA
    CAGTCCACAG GCTCAGACCG ATTGTCACAG ACGCCAGAGA GCCTGGATTT CCTCAAGGTC
    CCGGACCAGG GTGCTGCAGG GGTCCGGAGA CAAACAACCA GCAGGCCTCC TCCAGCAGGC
    GGCAGACCAA AGCCCCAGCC CAAGCCCAAG CCTCAGGTGC CACAGTGCAA AGCTTTATAT
    GCTTACGACG CTCAGGACAC AGATGAGCTC AGCTTCAATG CCAACGATGT CATTGATATT
    ATTAAAGAAG ATCCTTCTGG CTGGTGGACG GGTCGACTAC GAGGCAAGCA GGGCCTGTTT
    CCAAACAACT ATGTGACCAA GATCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.