ZER1 cDNA ORF clone, Macaca fascicularis(crab-eating macaque)

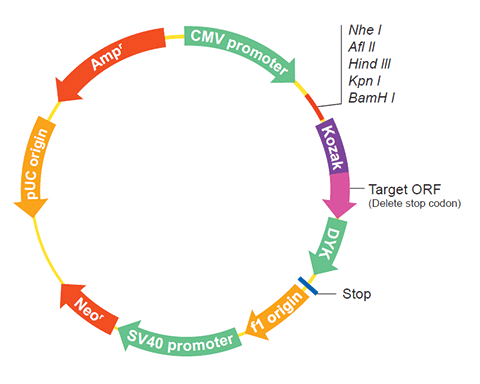
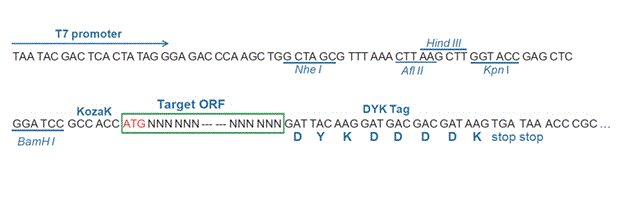
The following ZER1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZER1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OMa71135 XM_005580707.2
Latest version!
Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OMa71135 XM_005580709.2
Latest version!
Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OMa71135 XM_005580708.2
Latest version!
Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OMa71136 XM_005580710.2
Latest version!
Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OMa71135
    Clone ID Related Accession (Same CDS sequence) XM_005580707.2 , XM_005580708.2 , XM_005580709.2
    Accession Version XM_005580707.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2301bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product protein zer-1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092990.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jan 25, 2016 this sequence version replaced XM_005580707.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005580764.1
    CDS450..2750
    Translation

    Target ORF information:

    RefSeq Version XM_005580707.2
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005580707.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OMa71135
    Clone ID Related Accession (Same CDS sequence) XM_005580707.2 , XM_005580708.2 , XM_005580709.2
    Accession Version XM_005580708.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2301bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product protein zer-1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092990.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jan 25, 2016 this sequence version replaced XM_005580708.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005580765.1
    CDS219..2519
    Translation

    Target ORF information:

    RefSeq Version XM_005580708.2
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005580708.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OMa71135
    Clone ID Related Accession (Same CDS sequence) XM_005580707.2 , XM_005580708.2 , XM_005580709.2
    Accession Version XM_005580709.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2301bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product protein zer-1 homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092990.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jan 25, 2016 this sequence version replaced XM_005580709.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_005580766.1
    CDS210..2510
    Translation

    Target ORF information:

    RefSeq Version XM_005580709.2
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005580709.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGACGG TGCAGCGGAA CTGCTGCCTG
    ACGCTCTGCA ACTTCAGCAT CCCCGAGGAG CTGGAATTCC AGTACCGCCG GGTCAACGAG
    CTCCTGCTCA GCATCCTCAA CCCCACGCGG CAGGACGAGT CCATCCAGCG GATCGCCGTG
    CACCTGTGCA ATGCCCTGGT CTGCCAGGTG GACAACGACC ACAAGGAGGC TGTGGGCAAG
    ATGGGCTTTG TCGTGACTAT GCTGAAGCTG ATTCAGAAGA AGCTGCTGGA CAAGATATGT
    GACCAGGTCA TGGAGTTCTC CTGGAGCGCC CTGTGGAACA TCACAGATGA AACTCCTGAC
    AACTGCGAGA TGTTCCTCAA TTTCAACGGC ATGAAGCTCT TCCTGGACTG CCTGAAGGAA
    TTCCCAGAGA AGCAGGAACT GCATAGGAAT ATGCTAGGAC TCTTGGGGAA TGTGGCAGAA
    GTGAAGGAGC TGCGGCCTCA ACTAATGACT TCCCAGTTCA TCAGTGTCTT CAGCAACCTG
    TTGGAGAGCA AGGCCGATGG GATCGAGGTT TCCTACAATG CCTGCGGCGT CCTCTCCCAC
    ATCATGTTTG ATGGACCCGA GGCCTGGGGC GTCTGTGAGC CCCAGCGCGA GGAGGTGGAG
    GAACGCATGT GGGCCGCCAT CCAGAGCTGG GACATCAACT CTCGGAGAAA CATCAATTAC
    AGGTCATTTG AACCAATTCT TCGCCTCCTT CCCCAGGGAA TCTCTCCTGT CAGCCAGCAC
    TGGGCAACCT GGGCCCTGTA TAACCTCGTG TCCGTCTACC CGGACAAGTA CTGCCCTCTG
    CTGATCAAAG AAGGGGGGTT GCCCCTTCTG AGGGACATAA TTAAGATGGC GACCGCACGG
    CAGGAGACCA AGGAAATGGC CCGCAAGGTG ATTGAGCACT GCAGTAACTT TAAAGAGGAA
    AACATGGACA CATCCAGATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OMa71136
    Clone ID Related Accession (Same CDS sequence) XM_005580710.2
    Accession Version XM_005580710.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2295bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product protein zer-1 homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092990.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jan 25, 2016 this sequence version replaced XM_005580710.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGCAGC GGAACTGCTG CCTGACGCTC
    TGCAACTTCA GCATCCCCGA GGAGCTGGAA TTCCAGTACC GCCGGGTCAA CGAGCTCCTG
    CTCAGCATCC TCAACCCCAC GCGGCAGGAC GAGTCCATCC AGCGGATCGC CGTGCACCTG
    TGCAATGCCC TGGTCTGCCA GGTGGACAAC GACCACAAGG AGGCTGTGGG CAAGATGGGC
    TTTGTCGTGA CTATGCTGAA GCTGATTCAG AAGAAGCTGC TGGACAAGAT ATGTGACCAG
    GTCATGGAGT TCTCCTGGAG CGCCCTGTGG AACATCACAG ATGAAACTCC TGACAACTGC
    GAGATGTTCC TCAATTTCAA CGGCATGAAG CTCTTCCTGG ACTGCCTGAA GGAATTCCCA
    GAGAAGCAGG AACTGCATAG GAATATGCTA GGACTCTTGG GGAATGTGGC AGAAGTGAAG
    GAGCTGCGGC CTCAACTAAT GACTTCCCAG TTCATCAGTG TCTTCAGCAA CCTGTTGGAG
    AGCAAGGCCG ATGGGATCGA GGTTTCCTAC AATGCCTGCG GCGTCCTCTC CCACATCATG
    TTTGATGGAC CCGAGGCCTG GGGCGTCTGT GAGCCCCAGC GCGAGGAGGT GGAGGAACGC
    ATGTGGGCCG CCATCCAGAG CTGGGACATC AACTCTCGGA GAAACATCAA TTACAGGTCA
    TTTGAACCAA TTCTTCGCCT CCTTCCCCAG GGAATCTCTC CTGTCAGCCA GCACTGGGCA
    ACCTGGGCCC TGTATAACCT CGTGTCCGTC TACCCGGACA AGTACTGCCC TCTGCTGATC
    AAAGAAGGGG GGTTGCCCCT TCTGAGGGAC ATAATTAAGA TGGCGACCGC ACGGCAGGAG
    ACCAAGGAAA TGGCCCGCAA GGTGATTGAG CACTGCAGTA ACTTTAAAGA GGAAAACATG
    GACACATCCA GATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005580767.1
    CDS450..2744
    Translation

    Target ORF information:

    RefSeq Version XM_005580710.2
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis zyg-11 related, cell cycle regulator (ZER1), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005580710.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGGCGTCTG ACACTCCCGA GTCGCTGATG GCCCTCTGTA CTGACTTCTG CTTGCGCAAC 
    CTGGATGGCA CCCTGGGCTA CCTGCTGGAC AAGGAGACCC TGCGGCTACA TCCGGACATC
    TTCTTGCCCA GCGAGATCTG TGACCGGCTC GTCAATGAGT ATGTGGAGCT GGTGAACGCT
    GCCTGTAACT TCGAGCCACA CGAGAGCTTC TTCAGCCTCT TCTCAGACCC CCGCAGCACC
    CGCCTCACAC GGATCCACCT CCGCGAGGAC CTGGTGCAGG ACCAGGACCT GGAGGCCATC
    CGCAAGCAGG ACCTGGTGGA GCTGTACCTG ACCAACTGCG AGAAGCTGTC TGCCAAGAGC
    CTGCAGACAC TGAGGAGCTT CAGCCACACC CTGGTGTCCT TGAGCCTCTT CGGCTGTACA
    AACATTTTCT ATGAGGAGGA GAACCCAGGG GGCTGTGAAG ATGAGTACCT CGTCAACCCC
    ACCTGCCAGG TTCTGGTTAA GGATTTCACC TTTGAGGGCT TCAGCCGCCT CCGCTTCCTC
    AACTTGGGCC GCATGATTGA TTGGGTCCCT GTGGAGTCCC TGCTGCGGCC ACTCAACTCC
    CTGGCAGCCT TGGACCTCTC AGGCATTCAG ACCAGCGATG CCGCCTTCCT CACGCAGTGG
    AAAGACAGCC TGGTGTCCCT CGTACTCTAC AATATGGACC TGTCTGACGA CCACATCCGG
    GTCATCGTGC AGCTGCACAA GCTGCGACAC CTGGACATCT CCCGAGACCG CCTCTCCAGC
    TACTACAAGT TCAAGCTGAC TCGGGAGGTG CTGAGCCTCT TTGTGCAGAA GCTGGGGAAC
    CTAATGTCCC TGGACATCTC TGGCCACATG ATCCTAGAGA ACTGCAGCAT CTCCAAGATG
    GAAGAGGAAG CGGGACAGAC CAGCATTGAG CCTTCCAAGA GCAGCATCAT ACCTTTCCGG
    GCTCTGAAGA GGCCGCTGCA GTTCCTCGGG CTCTTCGAGA ACTCTCTGTG CCGCCTCACG
    CACATTCCGG CCTACAAAGT AAGTGGTGAT AAAAACGAAG AGCAGGTGCT GAATGCCATC
    GAGGCCTACA CGGAGCACCG GCCTGAGATC ACCTCACGGG CTATCAACCT GCTTTTTGAC
    ATTGCCCGCA TCGAGCGCTG CAACCAGCTG CTGCGGGCCC TGAAGCTGGT CATCACGGCC
    CTCAAGTGCC ACAAATATGA CAGAAACATT CAAGTAACAG GCAGTGCCGC TCTCTTCTAC
    CTAACAAATT CCGAGTACCG CTCAGAGCAG AGTGTGAAGC TGCGCCGGCA AGTCATCCAG
    GTGGTGCTGA ATGGCATGGA ATCCTACCAG GAGGTGCAGC GGAACTGCTG CCTGACGCTC
    TGCAACTTCA GCATCCCCGA GGAGCTGGAA TTCCAGTACC GCCGGGTCAA CGAGCTCCTG
    CTCAGCATCC TCAACCCCAC GCGGCAGGAC GAGTCCATCC AGCGGATCGC CGTGCACCTG
    TGCAATGCCC TGGTCTGCCA GGTGGACAAC GACCACAAGG AGGCTGTGGG CAAGATGGGC
    TTTGTCGTGA CTATGCTGAA GCTGATTCAG AAGAAGCTGC TGGACAAGAT ATGTGACCAG
    GTCATGGAGT TCTCCTGGAG CGCCCTGTGG AACATCACAG ATGAAACTCC TGACAACTGC
    GAGATGTTCC TCAATTTCAA CGGCATGAAG CTCTTCCTGG ACTGCCTGAA GGAATTCCCA
    GAGAAGCAGG AACTGCATAG GAATATGCTA GGACTCTTGG GGAATGTGGC AGAAGTGAAG
    GAGCTGCGGC CTCAACTAAT GACTTCCCAG TTCATCAGTG TCTTCAGCAA CCTGTTGGAG
    AGCAAGGCCG ATGGGATCGA GGTTTCCTAC AATGCCTGCG GCGTCCTCTC CCACATCATG
    TTTGATGGAC CCGAGGCCTG GGGCGTCTGT GAGCCCCAGC GCGAGGAGGT GGAGGAACGC
    ATGTGGGCCG CCATCCAGAG CTGGGACATC AACTCTCGGA GAAACATCAA TTACAGGTCA
    TTTGAACCAA TTCTTCGCCT CCTTCCCCAG GGAATCTCTC CTGTCAGCCA GCACTGGGCA
    ACCTGGGCCC TGTATAACCT CGTGTCCGTC TACCCGGACA AGTACTGCCC TCTGCTGATC
    AAAGAAGGGG GGTTGCCCCT TCTGAGGGAC ATAATTAAGA TGGCGACCGC ACGGCAGGAG
    ACCAAGGAAA TGGCCCGCAA GGTGATTGAG CACTGCAGTA ACTTTAAAGA GGAAAACATG
    GACACATCCA GATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.