PIGS cDNA ORF clone, Macaca fascicularis(crab-eating macaque)

The following PIGS gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the PIGS cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OMa73671 XM_005583232.1
Latest version!
Macaca fascicularis phosphatidylinositol glycan anchor biosynthesis class S (PIGS), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00
OMa73670 XM_005583231.2
Latest version!
Macaca fascicularis phosphatidylinositol glycan anchor biosynthesis class S (PIGS), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OMa73671
    Clone ID Related Accession (Same CDS sequence) XM_005583232.1
    Accession Version XM_005583232.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1377bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
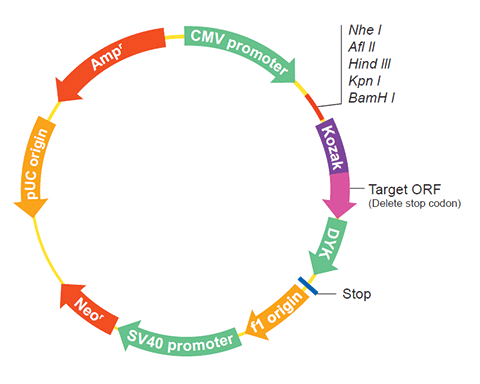
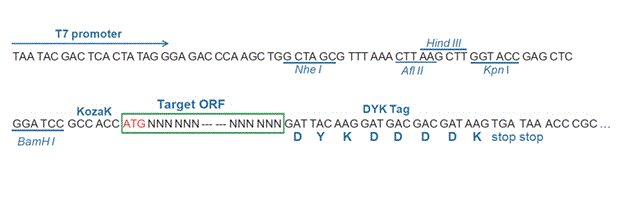
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product GPI transamidase component PIG-S isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092993.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    ATGAAAATCA AATGCCGTTT CCAGAAGGCC TATCGGAGGG CTTTGGACCA TGAGGAGGAG 
    GCCCTGTCAT CGGGCAGTGT ACAAGAGGCA GAAGCCATGT TAGATGAGCC TCAGGAGCAA
    GCGGAGGGCT CCCTGACTGT GTATGTGATC TCTGAACACT CCTCACTTCT TCCCCAGGAC
    ATGATGAGCT ACATTGGGCC CAAGAGGACA GCAGTGGTAC GGGGGATAAT GCACCGGGAG
    GCCTTTAACA TCATTGGCCG CCGCATAGTC CAGGTGGCCC AGGCCATGTC TTTGACTGAG
    GACGTGCTTG CTGCTGCTCT GGCTGACCAC CTTCCAGAGG ACAAGTGGAG CGCTGAGAAG
    AGGCGGCCTC TGAAGTCCAG CTTGGGCTAT GAGATCACCT TCAGTTTACT CAACCCAGAC
    CCCAAGTCCC ATGACGTCCA CTGGGACATT GAGGGAGCTG TGCGGCGCTA TGTGCAACCT
    TTCCTGAATG CCCTCAGTGC CGCTGGCAAC TTCTCTGTGG ACTCTCAGAT TCTTTACTAT
    GCAATGTTGG GGGTGAACCC CCGCTTTGAC TCAGCTTCCT CCAGCTACTA TTTGGACATG
    CACAACCTCC CCCATGTCAT CAACCCAGTG GAGTCCCGGC TGGGATCCAG TGCTGCCTCC
    TTGTACCCTG TGCTCAACTT TCTACTCTAC GTGCCTGAGC TTGCACACTC ACCGCTGTAC
    ATTCAGGACA AGGATGGCGC TCCAGTGGCC ACCAATGCCT TCCACAGTCC TCGCTGGGGT
    GGCATTATGG TATATAATGT CGACTCCAAA ACCTATAATG CCTCAGTGCT GCCAGTGAGA
    GTCAAGGTGG ACATGGTGCG AGTGATGGAG GTGTTCCTGG CACAGTTGCG GTTGCTCTTT
    GGGATTGCTC AGCCCCAGGT GCCTCCAAAA TGCCTGCTTT CAGGGCCTAA GAGTGAAGGG
    CTAATGACCT GGGAGCTAGA CCGGCTGCTC TGGGCTCGGT CAGTGGAGAA TCTGGCCACA
    GCCACCACCA CCCTCACCTC CCTGGCACAG CTTCTGGGCA AGATCAGCAA CATTGTCATT
    AAGGACGATG TGGCATCTGA GGTATACAGG GCTGTAGCTG CAGTCCAGAA GTCAGCAGAA
    GAGTTGGCCT CTGGGCACCT GGCATCTGCC TTTGTCGCCA GCCAGGAAGC TGTGACGTCC
    TCTGAGCGTG CCTTTTTTGA CCCGTCACTC CTCCACCTCC TTTATTTCCC TGATGACCAG
    AAATTTGCCA TCTACATCCC ACTCTTCCTG CCTATGGCTG TGCCCATCCT CCTGTCCCTG
    GTCAAGATCT TCCTGGAGAC CCACAAGTCC TGGAAAAAGC CTGAGAAGAC AGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005583289.1
    CDS201..1577
    Translation

    Target ORF information:

    RefSeq Version XM_005583232.1
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis phosphatidylinositol glycan anchor biosynthesis class S (PIGS), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005583232.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    ATGAAAATCA AATGCCGTTT CCAGAAGGCC TATCGGAGGG CTTTGGACCA TGAGGAGGAG 
    GCCCTGTCAT CGGGCAGTGT ACAAGAGGCA GAAGCCATGT TAGATGAGCC TCAGGAGCAA
    GCGGAGGGCT CCCTGACTGT GTATGTGATC TCTGAACACT CCTCACTTCT TCCCCAGGAC
    ATGATGAGCT ACATTGGGCC CAAGAGGACA GCAGTGGTAC GGGGGATAAT GCACCGGGAG
    GCCTTTAACA TCATTGGCCG CCGCATAGTC CAGGTGGCCC AGGCCATGTC TTTGACTGAG
    GACGTGCTTG CTGCTGCTCT GGCTGACCAC CTTCCAGAGG ACAAGTGGAG CGCTGAGAAG
    AGGCGGCCTC TGAAGTCCAG CTTGGGCTAT GAGATCACCT TCAGTTTACT CAACCCAGAC
    CCCAAGTCCC ATGACGTCCA CTGGGACATT GAGGGAGCTG TGCGGCGCTA TGTGCAACCT
    TTCCTGAATG CCCTCAGTGC CGCTGGCAAC TTCTCTGTGG ACTCTCAGAT TCTTTACTAT
    GCAATGTTGG GGGTGAACCC CCGCTTTGAC TCAGCTTCCT CCAGCTACTA TTTGGACATG
    CACAACCTCC CCCATGTCAT CAACCCAGTG GAGTCCCGGC TGGGATCCAG TGCTGCCTCC
    TTGTACCCTG TGCTCAACTT TCTACTCTAC GTGCCTGAGC TTGCACACTC ACCGCTGTAC
    ATTCAGGACA AGGATGGCGC TCCAGTGGCC ACCAATGCCT TCCACAGTCC TCGCTGGGGT
    GGCATTATGG TATATAATGT CGACTCCAAA ACCTATAATG CCTCAGTGCT GCCAGTGAGA
    GTCAAGGTGG ACATGGTGCG AGTGATGGAG GTGTTCCTGG CACAGTTGCG GTTGCTCTTT
    GGGATTGCTC AGCCCCAGGT GCCTCCAAAA TGCCTGCTTT CAGGGCCTAA GAGTGAAGGG
    CTAATGACCT GGGAGCTAGA CCGGCTGCTC TGGGCTCGGT CAGTGGAGAA TCTGGCCACA
    GCCACCACCA CCCTCACCTC CCTGGCACAG CTTCTGGGCA AGATCAGCAA CATTGTCATT
    AAGGACGATG TGGCATCTGA GGTATACAGG GCTGTAGCTG CAGTCCAGAA GTCAGCAGAA
    GAGTTGGCCT CTGGGCACCT GGCATCTGCC TTTGTCGCCA GCCAGGAAGC TGTGACGTCC
    TCTGAGCGTG CCTTTTTTGA CCCGTCACTC CTCCACCTCC TTTATTTCCC TGATGACCAG
    AAATTTGCCA TCTACATCCC ACTCTTCCTG CCTATGGCTG TGCCCATCCT CCTGTCCCTG
    GTCAAGATCT TCCTGGAGAC CCACAAGTCC TGGAAAAAGC CTGAGAAGAC AGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OMa73670
    Clone ID Related Accession (Same CDS sequence) XM_005583231.2
    Accession Version XM_005583231.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1668bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-01-24
    Organism Macaca fascicularis(crab-eating macaque)
    Product GPI transamidase component PIG-S isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005092993.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jan 25, 2016 this sequence version replaced XM_005583231.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Macaca fascicularis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    ATGGCGGTCG CCGGGCCCGC GGCTACAGAC CTAGAGGTGG TCCGGGGCAA GCGCGCCGCC 
    CTCTTCTTCG CTGCGGTGGC CATCGTGCTG GGGCTGCCTC TCTGGTGGAA GACCACGGAG
    ACCTACCGGG CTTCGTTGCC TTACTCCCAG ATCAGTGGAC TGAATGCCCT GCAGCTCCGC
    CTCATGGTGC CTGTCACTGT CGTGTTTGCG CGGGAGTCAG TGCCCCTGGA CGACCAGGAG
    AAGCTGCCCT TCACCGTTGT GCATGAAAGA GAGATTCCTC TGAAATACAA AATGAAAATC
    AAATGCCGTT TCCAGAAGGC CTATCGGAGG GCTTTGGACC ATGAGGAGGA GGCCCTGTCA
    TCGGGCAGTG TACAAGAGGC AGAAGCCATG TTAGATGAGC CTCAGGAGCA AGCGGAGGGC
    TCCCTGACTG TGTATGTGAT CTCTGAACAC TCCTCACTTC TTCCCCAGGA CATGATGAGC
    TACATTGGGC CCAAGAGGAC AGCAGTGGTA CGGGGGATAA TGCACCGGGA GGCCTTTAAC
    ATCATTGGCC GCCGCATAGT CCAGGTGGCC CAGGCCATGT CTTTGACTGA GGACGTGCTT
    GCTGCTGCTC TGGCTGACCA CCTTCCAGAG GACAAGTGGA GCGCTGAGAA GAGGCGGCCT
    CTGAAGTCCA GCTTGGGCTA TGAGATCACC TTCAGTTTAC TCAACCCAGA CCCCAAGTCC
    CATGACGTCC ACTGGGACAT TGAGGGAGCT GTGCGGCGCT ATGTGCAACC TTTCCTGAAT
    GCCCTCAGTG CCGCTGGCAA CTTCTCTGTG GACTCTCAGA TTCTTTACTA TGCAATGTTG
    GGGGTGAACC CCCGCTTTGA CTCAGCTTCC TCCAGCTACT ATTTGGACAT GCACAACCTC
    CCCCATGTCA TCAACCCAGT GGAGTCCCGG CTGGGATCCA GTGCTGCCTC CTTGTACCCT
    GTGCTCAACT TTCTACTCTA CGTGCCTGAG CTTGCACACT CACCGCTGTA CATTCAGGAC
    AAGGATGGCG CTCCAGTGGC CACCAATGCC TTCCACAGTC CTCGCTGGGG TGGCATTATG
    GTATATAATG TCGACTCCAA AACCTATAAT GCCTCAGTGC TGCCAGTGAG AGTCAAGGTG
    GACATGGTGC GAGTGATGGA GGTGTTCCTG GCACAGTTGC GGTTGCTCTT TGGGATTGCT
    CAGCCCCAGG TGCCTCCAAA ATGCCTGCTT TCAGGGCCTA AGAGTGAAGG GCTAATGACC
    TGGGAGCTAG ACCGGCTGCT CTGGGCTCGG TCAGTGGAGA ATCTGGCCAC AGCCACCACC
    ACCCTCACCT CCCTGGCACA GCTTCTGGGC AAGATCAGCA ACATTGTCAT TAAGGACGAT
    GTGGCATCTG AGGTATACAG GGCTGTAGCT GCAGTCCAGA AGTCAGCAGA AGAGTTGGCC
    TCTGGGCACC TGGCATCTGC CTTTGTCGCC AGCCAGGAAG CTGTGACGTC CTCTGAGCGT
    GCCTTTTTTG ACCCGTCACT CCTCCACCTC CTTTATTTCC CTGATGACCA GAAATTTGCC
    ATCTACATCC CACTCTTCCT GCCTATGGCT GTGCCCATCC TCCTGTCCCT GGTCAAGATC
    TTCCTGGAGA CCCACAAGTC CTGGAAAAAG CCTGAGAAGA CAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005583288.1
    CDS598..2265
    Translation

    Target ORF information:

    RefSeq Version XM_005583231.2
    Organism Macaca fascicularis(crab-eating macaque)
    Definition Macaca fascicularis phosphatidylinositol glycan anchor biosynthesis class S (PIGS), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005583231.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    ATGGCGGTCG CCGGGCCCGC GGCTACAGAC CTAGAGGTGG TCCGGGGCAA GCGCGCCGCC 
    CTCTTCTTCG CTGCGGTGGC CATCGTGCTG GGGCTGCCTC TCTGGTGGAA GACCACGGAG
    ACCTACCGGG CTTCGTTGCC TTACTCCCAG ATCAGTGGAC TGAATGCCCT GCAGCTCCGC
    CTCATGGTGC CTGTCACTGT CGTGTTTGCG CGGGAGTCAG TGCCCCTGGA CGACCAGGAG
    AAGCTGCCCT TCACCGTTGT GCATGAAAGA GAGATTCCTC TGAAATACAA AATGAAAATC
    AAATGCCGTT TCCAGAAGGC CTATCGGAGG GCTTTGGACC ATGAGGAGGA GGCCCTGTCA
    TCGGGCAGTG TACAAGAGGC AGAAGCCATG TTAGATGAGC CTCAGGAGCA AGCGGAGGGC
    TCCCTGACTG TGTATGTGAT CTCTGAACAC TCCTCACTTC TTCCCCAGGA CATGATGAGC
    TACATTGGGC CCAAGAGGAC AGCAGTGGTA CGGGGGATAA TGCACCGGGA GGCCTTTAAC
    ATCATTGGCC GCCGCATAGT CCAGGTGGCC CAGGCCATGT CTTTGACTGA GGACGTGCTT
    GCTGCTGCTC TGGCTGACCA CCTTCCAGAG GACAAGTGGA GCGCTGAGAA GAGGCGGCCT
    CTGAAGTCCA GCTTGGGCTA TGAGATCACC TTCAGTTTAC TCAACCCAGA CCCCAAGTCC
    CATGACGTCC ACTGGGACAT TGAGGGAGCT GTGCGGCGCT ATGTGCAACC TTTCCTGAAT
    GCCCTCAGTG CCGCTGGCAA CTTCTCTGTG GACTCTCAGA TTCTTTACTA TGCAATGTTG
    GGGGTGAACC CCCGCTTTGA CTCAGCTTCC TCCAGCTACT ATTTGGACAT GCACAACCTC
    CCCCATGTCA TCAACCCAGT GGAGTCCCGG CTGGGATCCA GTGCTGCCTC CTTGTACCCT
    GTGCTCAACT TTCTACTCTA CGTGCCTGAG CTTGCACACT CACCGCTGTA CATTCAGGAC
    AAGGATGGCG CTCCAGTGGC CACCAATGCC TTCCACAGTC CTCGCTGGGG TGGCATTATG
    GTATATAATG TCGACTCCAA AACCTATAAT GCCTCAGTGC TGCCAGTGAG AGTCAAGGTG
    GACATGGTGC GAGTGATGGA GGTGTTCCTG GCACAGTTGC GGTTGCTCTT TGGGATTGCT
    CAGCCCCAGG TGCCTCCAAA ATGCCTGCTT TCAGGGCCTA AGAGTGAAGG GCTAATGACC
    TGGGAGCTAG ACCGGCTGCT CTGGGCTCGG TCAGTGGAGA ATCTGGCCAC AGCCACCACC
    ACCCTCACCT CCCTGGCACA GCTTCTGGGC AAGATCAGCA ACATTGTCAT TAAGGACGAT
    GTGGCATCTG AGGTATACAG GGCTGTAGCT GCAGTCCAGA AGTCAGCAGA AGAGTTGGCC
    TCTGGGCACC TGGCATCTGC CTTTGTCGCC AGCCAGGAAG CTGTGACGTC CTCTGAGCGT
    GCCTTTTTTG ACCCGTCACT CCTCCACCTC CTTTATTTCC CTGATGACCA GAAATTTGCC
    ATCTACATCC CACTCTTCCT GCCTATGGCT GTGCCCATCC TCCTGTCCCT GGTCAAGATC
    TTCCTGGAGA CCCACAAGTC CTGGAAAAAG CCTGAGAAGA CAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.