ZNF804A cDNA ORF clone, Loxodonta africana(African savanna elephant)

The following ZNF804A gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZNF804A cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OLo33780 XM_003406179.2
Latest version!
Loxodonta africana zinc finger protein 804A (ZNF804A), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OLo33780
    Clone ID Related Accession (Same CDS sequence) XM_003406179.2
    Accession Version XM_003406179.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3612bp)
    Protein sequence
    SNP
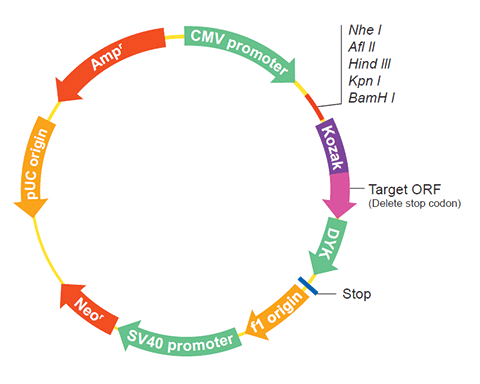
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
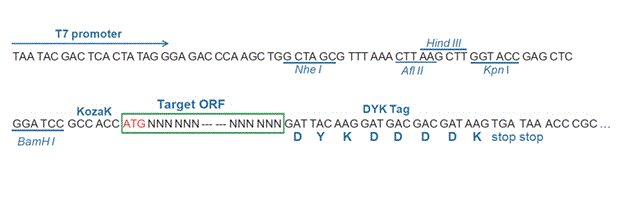
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-15
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 804A
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573423.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Dec 11, 2014 this sequence version replaced XM_003406179.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Loxodonta africana Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGTGTT ACTACATTGT CATCAGCTCC ACGCATCTCA GCAACGGACA CTTTCGCAAC 
    ATCAAGGGAG TTTTCCGGGG CCCTCTCAGC AAGAACGGGA ACAAAACTCT GGACTATGCT
    GAGAAGGAAA ATACCATAGC AAAAGCTCTG GAAGACCTAA AGGCCAATTT CTATTGTGAA
    CTCTGTGATA AGCAGTACTA CAAGCATCAA GAATTTGACA ATCACATTAA TTCTTATGAC
    CATGCTCACA AGCAGAGGCT CAAAGAACTG AAACAAAGAG AATTTGCTCG AAATGTAGCA
    TCTAAATCCA GGAAAGATGA AAGAAAACAG GAAAAAGCAC TTCAACGCCT GCACCAGCTT
    GCAGAGCTAA GAAAGGAGAC TGTATGTGCT CCTGGAAGTG GCCCCATGTT CAAGTCAACA
    ACTGTTACCG TGAGAGAAAA TCTTAATGAA ATCTCACGGA AAGTTGTGGA TTCAGTTAAT
    GGCCAGGAAG AATTCAAATA TACTTTGATT CAGAGTGAAG TGAATTCTAA CAATGTTACT
    GCTGTTGCTG CAGATTCAGA AAGTTCAAAT AATTACACAG CAAAAAATAA CCAACTTGGG
    GATCAAGCCC TGGGAATTCA CAGGCACAAA ATTGGCTTTT CTTTTGCATT TCCAAAGAAA
    GCATCAGTGA AGCTGGAGTC CTCAGCTGCA GCCTTTTCTG AATACAATGA TGATGCCTCT
    GTGGGAAAAG GATTTAGCAG AAAAAGTAGA TTTGTCCCCG GTGCTTGTCA TCTTCAACTA
    TCTTCATCAA CAGATGTGCT TTTGAGTTCT GAGGAGAAAG CTAACACTAT TCATCCACCA
    GAGGGAATGT GCTCTGACAA AGAAGAAACT CTTCAAACTC AAGAGATGAA AGAAGTCTCT
    AGTAAAAAAG ATACATTATT AGTACCTCCA TTTTGCCAGC TTCAATGCCT TTTATCTTCT
    GATTCAGATA GTTGCCAAAA TTCAGTCCCA AGAGCAGATC AGATACCACT AGAAGATGTT
    ATTACTAATG AAGACACAGC CCTGAATGGT AACAGCTCTG AGATGTTAGG AAATAAATCC
    ACACTTCCTG ATATGCCTAA TGATTGCTTG TCTTTGCAAG CTACCACAGA GGAAAATGTT
    AAGAACAATG ATGCATCCAC AACTGAAGAT GAAAGTAAAA ATCACGCCCC TGAGATTTTG
    GCCCCTTCAA ATACTGAAGA GAAAAATATA AACTTACATA AGAAAACAGA TTCATTTAAA
    AGACAATGTG AGCCATTCGT ACCTGTGCTT AACAAACATG GGTCGACAGT TCTTCAGTGG
    CCATCAGAAA TGCTGATTTA CACAACTACT GAACCATCAA TCTCTTATAG TTGCAATCCC
    CTCTGTTTTG ACTTCAAATC CACTAAATTA AGTAACAATC TATATAAAAA TAAACTGTCC
    TTAAATGATC TTTACTCACA GCAGAAGGAA GAAGACATTT GCAAGGGACC AGCTTCAGAA
    AGCAAGGACG CATCTGTCAC AGGACTCACT GATTATGAAA TTGTAGGTAG CAGAAGAGAA
    TATACTCAAG TCACTCCTCT TTTAGCTGAT GAAACTGTCT CTAAGAGTTA TGATTCTGGA
    AAAAATGGGG ATATAGGTCT AAGATTTAAA AATATTTCCT GTAGAATCAG AAACACAGGA
    AAATGTAATT CCACTAAAAA GCAAATAAAA CAGGACACTC TTCATGAGAA ATACAACAAA
    ATAAGGTTGA AAGATACTCA TGAACACTGG TTCCATAAAA GTAGAAGAAA AAAAAGAAAA
    AGAAATTTAT GTCAGCATCA TCATGGGGAG AAAACCAAAG AATTAGAATC TCATTTTAAA
    ATGGAAATGG AGAATAATTA CACTGATAAA ACTAGGACAG ATCTACTGGA AACAATTTCA
    GAGAAACAGC ATTTAACTGC AGAGTCATTA TCAGAATCAC ATCACTTAAC TGATAAAAGG
    CCCAAATCAG CATCCACATA CCTAAGTGAA AATGAAGAAA TGTGCAAAAC TTGGAACAGC
    AAATACAATA ATACTGATGC TATCAGTTCT AAAAACAACT ATAGAAGGAA CACAATTGTC
    TTAAATGGAC AATCAAATGC AACCATGATA CATTCTGGGA AACATAATTT AACATATTCC
    AGAACTTTTT GTAGTTGGAA AGCCAAAAAG TCAAGCTGTA GCCAAGATCA CAAATGCGTA
    GTTCTTCAAA ATGATGTGAA ATGCATGAGT CAGAATCAGG CTGTTAAAAG AGGTTATAAT
    TCTCTCGAAT CAGAAAGATA CCATCGAAAA CGTCGACAAC ATTCATATCC TTCAGATGAA
    AGTTTAAATC ATCAGAATTA TTTACCAGAG GAAATATTGA GGCCATCAAG TACTTCAGTT
    GCTCCCTGTA ATCCTAAAAA GAAATGGAGA AGGAAAAGAA GCAAATTCCA CACTAAATTT
    GAAGCTTTGG ATCTTAAAGA GAATACAAAT TATTTCATGA AAAACAGTCC TTCCTTAAGT
    AACCCAGATG AGTTAATAAG TAAAGACAAA AAAGAGGAAA TGAAACCACA AGAAGTTACA
    GATATTGAAA GTAACTCAGA AAACACAGAC CAAGTAGAAC ACAACCTAAC TTTGGACCCT
    AGCAATCTTC TTCCTTCTGA AACCAATGGT GAAACTGAAC ATTCAGTCAT GGAGATTACT
    TCTGGTGAAT TTTCAGAGGT TTCTGGTGAT CCCTCCACAT CTGCCTATGT AGCTAGTGTT
    CCAACAAAAG TAGCAATTGA AAATACCTTG TTTGAACATA AAAAAAGATG TGAGACTATT
    AATACTAATG GAAAACAAAT TCCTTCCAAG GTGCCCAGTA TTGAAAAGAA CTTTAGACAG
    CCACAACCTA AATCATACTT TTGCCATTAT GAACTGGCTG AGGCCCTTCC ACAAGGAAAG
    ATGAATGAGG CATCAACCGA GTGGCTACAG TATAATTCAG GAATCCTTAA CACACAACCA
    CCACTACCAT TCAAAGAAGC ACATGTTAGT GGTCATACCT TTGTAACAGC CGAACAAATT
    CTCGCTCCAT TAACTTTACC AGAGCAAACA TTATTAATCC CACTAGAAAA CCACGACAAA
    TTCAAAGACC TACCATGTGA GGCCTACCAG CACATCATAC AGCCGAACAT GCTGGCCAAC
    AAGGTCAAAT TTACCTTTCC TCCAGCTGCC CTCCCACCCC CTAGCACAAC TCTGCAGCCT
    TTGCCTTTGC AGCAGCCCTT ATGTTCTACC TCTGTAACCA CTATCCACCA CACTGTTTTG
    CAGCAGCATG CAGCAGCTGC AGCAGCAGCA GCAGCAGCCG CAGCTGCAGG GACATTTAAA
    GTACTTCAAC CACACCAACA GTTTCTTTCC CAAGTCCCAG CTCTATCCAG AACATCTTTA
    CCTCAGATCT CAGTAGGACC TAGGCTTTGT CCTGGGAATC ACCCGACTTT TGTGGCTCCT
    CCTCAGATGC CAATCATTCC AGCTTCGGTT CTCCATCCTA GTCATCTGGC TTTCCCACCT
    TTACCCCATG CACTCTTTCC TTCTCTGCTT TCCCCACACC CTACTGTCAT CCCCCTGCAA
    CCTCTCTTCT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003406227.1
    CDS549..4160
    Translation

    Target ORF information:

    RefSeq Version XM_003406179.2
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 804A (ZNF804A), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003406179.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGAGTGTT ACTACATTGT CATCAGCTCC ACGCATCTCA GCAACGGACA CTTTCGCAAC 
    ATCAAGGGAG TTTTCCGGGG CCCTCTCAGC AAGAACGGGA ACAAAACTCT GGACTATGCT
    GAGAAGGAAA ATACCATAGC AAAAGCTCTG GAAGACCTAA AGGCCAATTT CTATTGTGAA
    CTCTGTGATA AGCAGTACTA CAAGCATCAA GAATTTGACA ATCACATTAA TTCTTATGAC
    CATGCTCACA AGCAGAGGCT CAAAGAACTG AAACAAAGAG AATTTGCTCG AAATGTAGCA
    TCTAAATCCA GGAAAGATGA AAGAAAACAG GAAAAAGCAC TTCAACGCCT GCACCAGCTT
    GCAGAGCTAA GAAAGGAGAC TGTATGTGCT CCTGGAAGTG GCCCCATGTT CAAGTCAACA
    ACTGTTACCG TGAGAGAAAA TCTTAATGAA ATCTCACGGA AAGTTGTGGA TTCAGTTAAT
    GGCCAGGAAG AATTCAAATA TACTTTGATT CAGAGTGAAG TGAATTCTAA CAATGTTACT
    GCTGTTGCTG CAGATTCAGA AAGTTCAAAT AATTACACAG CAAAAAATAA CCAACTTGGG
    GATCAAGCCC TGGGAATTCA CAGGCACAAA ATTGGCTTTT CTTTTGCATT TCCAAAGAAA
    GCATCAGTGA AGCTGGAGTC CTCAGCTGCA GCCTTTTCTG AATACAATGA TGATGCCTCT
    GTGGGAAAAG GATTTAGCAG AAAAAGTAGA TTTGTCCCCG GTGCTTGTCA TCTTCAACTA
    TCTTCATCAA CAGATGTGCT TTTGAGTTCT GAGGAGAAAG CTAACACTAT TCATCCACCA
    GAGGGAATGT GCTCTGACAA AGAAGAAACT CTTCAAACTC AAGAGATGAA AGAAGTCTCT
    AGTAAAAAAG ATACATTATT AGTACCTCCA TTTTGCCAGC TTCAATGCCT TTTATCTTCT
    GATTCAGATA GTTGCCAAAA TTCAGTCCCA AGAGCAGATC AGATACCACT AGAAGATGTT
    ATTACTAATG AAGACACAGC CCTGAATGGT AACAGCTCTG AGATGTTAGG AAATAAATCC
    ACACTTCCTG ATATGCCTAA TGATTGCTTG TCTTTGCAAG CTACCACAGA GGAAAATGTT
    AAGAACAATG ATGCATCCAC AACTGAAGAT GAAAGTAAAA ATCACGCCCC TGAGATTTTG
    GCCCCTTCAA ATACTGAAGA GAAAAATATA AACTTACATA AGAAAACAGA TTCATTTAAA
    AGACAATGTG AGCCATTCGT ACCTGTGCTT AACAAACATG GGTCGACAGT TCTTCAGTGG
    CCATCAGAAA TGCTGATTTA CACAACTACT GAACCATCAA TCTCTTATAG TTGCAATCCC
    CTCTGTTTTG ACTTCAAATC CACTAAATTA AGTAACAATC TATATAAAAA TAAACTGTCC
    TTAAATGATC TTTACTCACA GCAGAAGGAA GAAGACATTT GCAAGGGACC AGCTTCAGAA
    AGCAAGGACG CATCTGTCAC AGGACTCACT GATTATGAAA TTGTAGGTAG CAGAAGAGAA
    TATACTCAAG TCACTCCTCT TTTAGCTGAT GAAACTGTCT CTAAGAGTTA TGATTCTGGA
    AAAAATGGGG ATATAGGTCT AAGATTTAAA AATATTTCCT GTAGAATCAG AAACACAGGA
    AAATGTAATT CCACTAAAAA GCAAATAAAA CAGGACACTC TTCATGAGAA ATACAACAAA
    ATAAGGTTGA AAGATACTCA TGAACACTGG TTCCATAAAA GTAGAAGAAA AAAAAGAAAA
    AGAAATTTAT GTCAGCATCA TCATGGGGAG AAAACCAAAG AATTAGAATC TCATTTTAAA
    ATGGAAATGG AGAATAATTA CACTGATAAA ACTAGGACAG ATCTACTGGA AACAATTTCA
    GAGAAACAGC ATTTAACTGC AGAGTCATTA TCAGAATCAC ATCACTTAAC TGATAAAAGG
    CCCAAATCAG CATCCACATA CCTAAGTGAA AATGAAGAAA TGTGCAAAAC TTGGAACAGC
    AAATACAATA ATACTGATGC TATCAGTTCT AAAAACAACT ATAGAAGGAA CACAATTGTC
    TTAAATGGAC AATCAAATGC AACCATGATA CATTCTGGGA AACATAATTT AACATATTCC
    AGAACTTTTT GTAGTTGGAA AGCCAAAAAG TCAAGCTGTA GCCAAGATCA CAAATGCGTA
    GTTCTTCAAA ATGATGTGAA ATGCATGAGT CAGAATCAGG CTGTTAAAAG AGGTTATAAT
    TCTCTCGAAT CAGAAAGATA CCATCGAAAA CGTCGACAAC ATTCATATCC TTCAGATGAA
    AGTTTAAATC ATCAGAATTA TTTACCAGAG GAAATATTGA GGCCATCAAG TACTTCAGTT
    GCTCCCTGTA ATCCTAAAAA GAAATGGAGA AGGAAAAGAA GCAAATTCCA CACTAAATTT
    GAAGCTTTGG ATCTTAAAGA GAATACAAAT TATTTCATGA AAAACAGTCC TTCCTTAAGT
    AACCCAGATG AGTTAATAAG TAAAGACAAA AAAGAGGAAA TGAAACCACA AGAAGTTACA
    GATATTGAAA GTAACTCAGA AAACACAGAC CAAGTAGAAC ACAACCTAAC TTTGGACCCT
    AGCAATCTTC TTCCTTCTGA AACCAATGGT GAAACTGAAC ATTCAGTCAT GGAGATTACT
    TCTGGTGAAT TTTCAGAGGT TTCTGGTGAT CCCTCCACAT CTGCCTATGT AGCTAGTGTT
    CCAACAAAAG TAGCAATTGA AAATACCTTG TTTGAACATA AAAAAAGATG TGAGACTATT
    AATACTAATG GAAAACAAAT TCCTTCCAAG GTGCCCAGTA TTGAAAAGAA CTTTAGACAG
    CCACAACCTA AATCATACTT TTGCCATTAT GAACTGGCTG AGGCCCTTCC ACAAGGAAAG
    ATGAATGAGG CATCAACCGA GTGGCTACAG TATAATTCAG GAATCCTTAA CACACAACCA
    CCACTACCAT TCAAAGAAGC ACATGTTAGT GGTCATACCT TTGTAACAGC CGAACAAATT
    CTCGCTCCAT TAACTTTACC AGAGCAAACA TTATTAATCC CACTAGAAAA CCACGACAAA
    TTCAAAGACC TACCATGTGA GGCCTACCAG CACATCATAC AGCCGAACAT GCTGGCCAAC
    AAGGTCAAAT TTACCTTTCC TCCAGCTGCC CTCCCACCCC CTAGCACAAC TCTGCAGCCT
    TTGCCTTTGC AGCAGCCCTT ATGTTCTACC TCTGTAACCA CTATCCACCA CACTGTTTTG
    CAGCAGCATG CAGCAGCTGC AGCAGCAGCA GCAGCAGCCG CAGCTGCAGG GACATTTAAA
    GTACTTCAAC CACACCAACA GTTTCTTTCC CAAGTCCCAG CTCTATCCAG AACATCTTTA
    CCTCAGATCT CAGTAGGACC TAGGCTTTGT CCTGGGAATC ACCCGACTTT TGTGGCTCCT
    CCTCAGATGC CAATCATTCC AGCTTCGGTT CTCCATCCTA GTCATCTGGC TTTCCCACCT
    TTACCCCATG CACTCTTTCC TTCTCTGCTT TCCCCACACC CTACTGTCAT CCCCCTGCAA
    CCTCTCTTCT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.