COL9A2 cDNA ORF clone, Equus caballus(horse)

The following COL9A2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the COL9A2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OHb54100 XM_023632587.1
Latest version!
Equus caballus collagen type IX alpha 2 chain (COL9A2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OHb29215 XM_014737410.1
Latest version!
Equus caballus collagen, type IX, alpha 2 (COL9A2), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OHb54100
    Clone ID Related Accession (Same CDS sequence) XM_023632587.1
    Accession Version XM_023632587.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2067bp)
    Protein sequence
    SNP
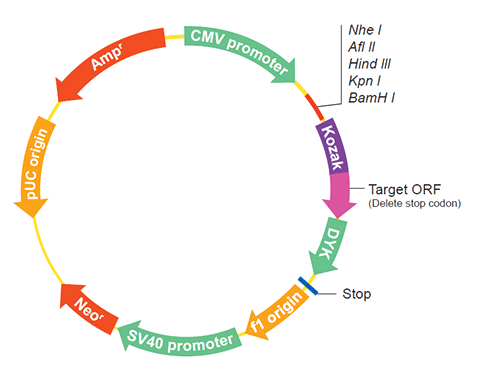
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
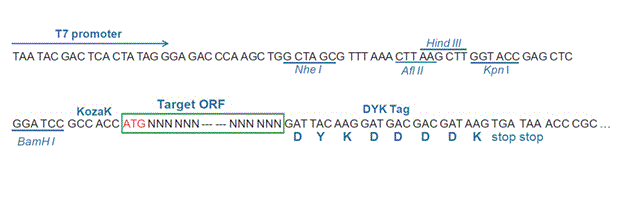
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-22
    Organism Equus caballus(horse)
    Product collagen alpha-2(IX) chain
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_009145.3) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Equus caballus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCGCTG CGGCCGCCCC CCGCAGCCTC CTTGTCCTCC TCCAGGTGCT CGGGCTCGCC 
    CTGGCGCAGA TCAGAGGTCC GCCAGGAGAG CAGGGGCCCC CGGGTCCCCC GGGGCCGCCA
    GGAGTGCCTG GATCCGACGG CATCGACGGT GACAAGGGGC CCCCTGGGAA AGCTGGCCCT
    CCGGGACCTA AGGGAGAGCC TGGCCAAGCG GGGCCCGATG GACCAGACGG CAAGCCGGGG
    ACTGATGGTC TAACTGGAGC CAAGGGGGAG CCTGGCCCCA TGGGGATCCC TGGAGTCAAG
    GGCCAGCCCG GGCTCCCAGG TCCCCCCGGT CTGCCGGGCC CTGGCTTTGC TGGACCCCCT
    GGACCTCCTG GACCAGTTGG CCTCCCCGGT GAGATTGGAA TCACAGGCCC CAAGGGGGAT
    CCTGGACCAG ACGGACCATC AGGGCCCCCA GGGCCTCCTG GGAAACCGGG CCGCCCCGGA
    ACCATCGCGG GCCTGGAAGG CAGCGCCGAT TTCCTGTGTC CAACCAACTG TCCAGCGGGA
    GCTAAAGGCC CCCCAGGGCT GCAGGGAGTG AAGGGGCATC CTGGCAAACG TGGGGCTCTG
    GGCGATTCGG GCCGCCAGGG GAAGCCGGGT CCCAAGGGAG ATGTGGGTGC CTCTGGAGAG
    CAAGGCATCC CTGGACCGCC GGGTCCCCAG GGCATCAGGG GCTACCCGGG CATGGAGGGA
    CCCAAAGGAG AGACAGGTCC TCGTGGGTAC AAAGGAATGC TGGGCTCCAT TGGTGCCGCC
    GGGTCCCCGG GTGAGGAAGG GCCGCGGGGG CCACCAGGCC GCGCCGGGGA GAAGGGTGAC
    GTGGGCAGCC AAGGTGTTCG AGGACCTCAG GGAATAACAG GCCCGAAGGG AGCAACCGGT
    CCCCCAGGCA TTGACGGCAA GGACGGGACC CCAGGCACAC CTGGTGTGAA GGGCAGTGCG
    GGACAGGCAG GACGGCCGGG AAACCCAGGC CACCAGGGCC TCGCGGGGGT GCCAGGCCAG
    CCTGGGACAA AAGGAGGCCC TGGAGACAAG GGTGAGCCAG GCCAGCAGGG CCTCCCTGGA
    TTCTCTGGTC CCCCGGGGAA GGAGGGAGAG CCAGGGCCTC GAGGAGAAAT CGGTCCCCGG
    GGCATCGTGG GCCAGAAGGG CGACCAGGGT GAGAGGGGGC CAGTGGGGCA GCCAGGCCCT
    CAAGGACGTC AGGGCCCTAA GGGGGAACAG GGGCCCCCAG GAATTCCAGG GCCCCAGGGC
    TTGCCAGGCA TCAAGGGAGA CAAGGGCTCC CCGGGGAAGA CCGGGCCCCG CGGCGGAGCG
    GGCGACCCGG GGGTGGCCGG GCTCCCCGGA GAGAAGGGCG AGAAGGGCGA GTCTGGCGAG
    CCGGGGCCCA AGGGACAGCA AGGAGTCCGC GGAGAACCCG GCTACCCGGG ACCCAGCGGG
    GATGCGGGCG CCCCAGGGGT GCAGGGCTAC CCCGGGCCCC CCGGCCCTCG AGGACTGGCT
    GGCGATCGCG GCGTGCCCGG ACAGCCCGGG AGACAGGGCG TGGCGGGCCG AGATGCCAGT
    GACCAGCACA TTGTGGACGT CGTGCTGAAG ATGCTGCAAG AGCAACTGGC AGAGGTGGCT
    GTGAGTGCCA AGCGGGAGGC CCTAGGTGCA ACAGGCATGG TGGGTCCCCC AGGACCCCCT
    GGGCCTCCTG GGTACCCAGG CAAGCAGGGA CCCCATGGGC ACCCTGGCCC TCGGGGCATT
    CCTGGCATCG TGGGAGCCGT GGGTCAGATC GGCAACACGG GGCCCAAGGG AAAACGTGGA
    GAGAAGGGCG ACCAGGGAGA CACAGGACGT GGCCATCCCG GGATGCCTGG GCCCCCAGGG
    ATCCCAGGAC TTCCTGGCCG GCCTGGCCAG GCAATCAACG GCAAGGATGG AGATCGAGGG
    TCCCCAGGTG CCCCTGGAGA GGCAGGCCGA CCTGGCCTAC CAGGCCCTGT GGGGCTCCCA
    GGCTTCTGTG AGCCTGCGGC CTGCCTCGGA GCCTCAGCCT ACGCCTCTGC ACGCCTCACG
    GAGCCTGGAT CCATCAAGGG GCCATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_023488355.1
    CDS98..2164
    Translation

    Target ORF information:

    RefSeq Version XM_023632587.1
    Organism Equus caballus(horse)
    Definition Equus caballus collagen type IX alpha 2 chain (COL9A2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_023632587.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCGCTG CGGCCGCCCC CCGCAGCCTC CTTGTCCTCC TCCAGGTGCT CGGGCTCGCC 
    CTGGCGCAGA TCAGAGGTCC GCCAGGAGAG CAGGGGCCCC CGGGTCCCCC GGGGCCGCCA
    GGAGTGCCTG GATCCGACGG CATCGACGGT GACAAGGGGC CCCCTGGGAA AGCTGGCCCT
    CCGGGACCTA AGGGAGAGCC TGGCCAAGCG GGGCCCGATG GACCAGACGG CAAGCCGGGG
    ACTGATGGTC TAACTGGAGC CAAGGGGGAG CCTGGCCCCA TGGGGATCCC TGGAGTCAAG
    GGCCAGCCCG GGCTCCCAGG TCCCCCCGGT CTGCCGGGCC CTGGCTTTGC TGGACCCCCT
    GGACCTCCTG GACCAGTTGG CCTCCCCGGT GAGATTGGAA TCACAGGCCC CAAGGGGGAT
    CCTGGACCAG ACGGACCATC AGGGCCCCCA GGGCCTCCTG GGAAACCGGG CCGCCCCGGA
    ACCATCGCGG GCCTGGAAGG CAGCGCCGAT TTCCTGTGTC CAACCAACTG TCCAGCGGGA
    GCTAAAGGCC CCCCAGGGCT GCAGGGAGTG AAGGGGCATC CTGGCAAACG TGGGGCTCTG
    GGCGATTCGG GCCGCCAGGG GAAGCCGGGT CCCAAGGGAG ATGTGGGTGC CTCTGGAGAG
    CAAGGCATCC CTGGACCGCC GGGTCCCCAG GGCATCAGGG GCTACCCGGG CATGGAGGGA
    CCCAAAGGAG AGACAGGTCC TCGTGGGTAC AAAGGAATGC TGGGCTCCAT TGGTGCCGCC
    GGGTCCCCGG GTGAGGAAGG GCCGCGGGGG CCACCAGGCC GCGCCGGGGA GAAGGGTGAC
    GTGGGCAGCC AAGGTGTTCG AGGACCTCAG GGAATAACAG GCCCGAAGGG AGCAACCGGT
    CCCCCAGGCA TTGACGGCAA GGACGGGACC CCAGGCACAC CTGGTGTGAA GGGCAGTGCG
    GGACAGGCAG GACGGCCGGG AAACCCAGGC CACCAGGGCC TCGCGGGGGT GCCAGGCCAG
    CCTGGGACAA AAGGAGGCCC TGGAGACAAG GGTGAGCCAG GCCAGCAGGG CCTCCCTGGA
    TTCTCTGGTC CCCCGGGGAA GGAGGGAGAG CCAGGGCCTC GAGGAGAAAT CGGTCCCCGG
    GGCATCGTGG GCCAGAAGGG CGACCAGGGT GAGAGGGGGC CAGTGGGGCA GCCAGGCCCT
    CAAGGACGTC AGGGCCCTAA GGGGGAACAG GGGCCCCCAG GAATTCCAGG GCCCCAGGGC
    TTGCCAGGCA TCAAGGGAGA CAAGGGCTCC CCGGGGAAGA CCGGGCCCCG CGGCGGAGCG
    GGCGACCCGG GGGTGGCCGG GCTCCCCGGA GAGAAGGGCG AGAAGGGCGA GTCTGGCGAG
    CCGGGGCCCA AGGGACAGCA AGGAGTCCGC GGAGAACCCG GCTACCCGGG ACCCAGCGGG
    GATGCGGGCG CCCCAGGGGT GCAGGGCTAC CCCGGGCCCC CCGGCCCTCG AGGACTGGCT
    GGCGATCGCG GCGTGCCCGG ACAGCCCGGG AGACAGGGCG TGGCGGGCCG AGATGCCAGT
    GACCAGCACA TTGTGGACGT CGTGCTGAAG ATGCTGCAAG AGCAACTGGC AGAGGTGGCT
    GTGAGTGCCA AGCGGGAGGC CCTAGGTGCA ACAGGCATGG TGGGTCCCCC AGGACCCCCT
    GGGCCTCCTG GGTACCCAGG CAAGCAGGGA CCCCATGGGC ACCCTGGCCC TCGGGGCATT
    CCTGGCATCG TGGGAGCCGT GGGTCAGATC GGCAACACGG GGCCCAAGGG AAAACGTGGA
    GAGAAGGGCG ACCAGGGAGA CACAGGACGT GGCCATCCCG GGATGCCTGG GCCCCCAGGG
    ATCCCAGGAC TTCCTGGCCG GCCTGGCCAG GCAATCAACG GCAAGGATGG AGATCGAGGG
    TCCCCAGGTG CCCCTGGAGA GGCAGGCCGA CCTGGCCTAC CAGGCCCTGT GGGGCTCCCA
    GGCTTCTGTG AGCCTGCGGC CTGCCTCGGA GCCTCAGCCT ACGCCTCTGC ACGCCTCACG
    GAGCCTGGAT CCATCAAGGG GCCATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OHb29215
    Clone ID Related Accession (Same CDS sequence) XM_014737410.1
    Accession Version XM_014737410.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2067bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-11-19
    Organism Equus caballus(horse)
    Product collagen alpha-2(IX) chain
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_001867402.1) and transcript sequence (AM182497.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus caballus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## assembly gap :: added 141 transcript bases to patch genome assembly gap ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCGCTG CGGCCGCCCC CCGCAGCCTC CTTGTCCTCC TCCAGGTGCT CGGGCTCGCC 
    CTGGCGCAGA TCAGAGGTCC GCCAGGAGAG CAGGGGCCCC CGGGTCCCCC GGGGCCGCCA
    GGAGTGCCTG GATCCGACGG CATCGACGGT GACAAGGGGC CCCCTGGGAA AGCTGGCCCT
    CCGGGACCTA AGGGAGAGCC TGGCCAAGCG GGGCCCGATG GACCAGACGG CAAGCCGGGG
    ACTGATGGTC TAACTGGAGC CAAGGGGGAG CCTGGCCCCA TGGGGATCCC TGGAGTCAAG
    GGCCAGCCCG GGCTCCCAGG TCCCCCCGGT CTGCCGGGCC CTGGCTTTGC TGGACCCCCT
    GGACCTCCTG GACCAGTTGG CCTCCCCGGT GAGATTGGAA TCACAGGCCC CAAGGGGGAT
    CCTGGACCAG ACGGACCATC AGGGCCCCCA GGGCCTCCTG GGAAACCGGG CCGCCCCGGA
    ACCATCGCGG GCCTGGAAGG CAGCGCCGAT TTCCTGTGTC CAACCAACTG TCCAGCGGGA
    GCTAAAGGCC CCCCAGGGCT GCAGGGAGTG AAGGGGCATC CTGGCAAACG TGGGGCTCTG
    GGCGATTCGG GCCGCCAGGG GAAGCCGGGT CCCAAGGGAG ATGTGGGTGC CTCTGGAGAG
    CAAGGCATCC CTGGACCGCC GGGTCCCCAG GGCATCAGGG GCTACCCGGG CATGGAGGGA
    CCCAAAGGAG AGACAGGTCC TCGTGGGTAC AAAGGAATGC TGGGCTCCAT TGGTGCCGCC
    GGGTCCCCGG GTGAGGAAGG GCCGCGGGGG CCACCAGGCC GCGCCGGGGA GAAGGGTGAC
    GTGGGCAGCC AAGGTGTTCG AGGACCTCAG GGAATAACAG GCCCGAAGGG AGCAACCGGT
    CCCCCAGGCA TTGACGGCAA GGACGGGGCC CCAGGCACAC CTGGTGTGAA GGGCAGTGCG
    GGACAGGCAG GACGGCCGGG AAACCCAGGC CACCAGGGCC TCGCGGGGGT GCCAGGCCAG
    CCTGGGACAA AAGGAGGCCC TGGAGACAAG GGTGAGCCAG GCCAGCAGGG CCTCCCTGGA
    TTCTCTGGTC CCCCGGGGAA GGAGGGAGAG CCAGGGCCTC GAGGAGAAAT CGGTCCCCGG
    GGCATCGTGG GCCAGAAGGG CGACCAGGGT GAGAGGGGGC CAGTGGGGCA GCCAGGCCCT
    CAAGGACGTC AGGGCCCTAA GGGGGAACAG GGGCCCCCAG GAATTCCAGG GCCCCAGGGC
    TTGCCAGGCA TCAAGGGAGA CAAGGGCTCC CCGGGGAAGA CCGGGCCCCG CGGCGGAGCG
    GGCGACCCGG GGGTGGCCGG GCTCCCCGGA GAGAAGGGCG AGAAGGGCGA GTCTGGCGAG
    CCGGGGCCCA AGGGACAGCA AGGAGTCCGC GGAGAACCCG GCTACCCGGG ACCCAGCGGG
    GATGCGGGCG CCCCAGGGGT GCAGGGCTAC CCCGGGCCCC CCGGCCCTCG AGGACTGGCT
    GGCGATCGCG GCGTGCCCGG ACAGCCCGGG AGACAGGGCG TGGCGGGCCG AGATGCCAGT
    GACCAGCACA TTGTGGACGT CGTGCTGAAG ATGCTGCAAG AGCAACTGGC AGAGGTGGCT
    GTGAGTGCCA AGCGGGAGGC CCTAGGTGCA ACAGGCATGG TGGGTCCCCC AGGACCCCCT
    GGGCCTCCTG GGTACCCAGG CAAGCAGGGA CCCCATGGGC ACCCTGGCCC TCGGGGCATT
    CCTGGCATCG TGGGAGCCGT GGGTCAGATC GGCAACACGG GGCCCAAGGG AAAACGTGGA
    GAGAAGGGCG ACCAGGGAGA CACAGGACGT GGCCATCCCG GGATGCCTGG GCCCCCAGGG
    ATCCCAGGAC TTCCTGGCCG GCCTGGCCAG GCAATCAACG GCAAGGATGG AGATCGAGGG
    TCCCCAGGTG CCCCTGGAGA GGCAGGCCGA CCTGGCCTAC CAGGCCCTGT GGGGCTTCCA
    GGCTTCTGTG AGCCTGCGGC CTGCCTCGGA GCCTCAGCCT ACGCCTCTGC ACGCCTCACG
    GAGCCTGGAT CCATCAAGGG GCCATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014592896.1
    CDS70..2136
    Translation

    Target ORF information:

    RefSeq Version XM_014737410.1
    Organism Equus caballus(horse)
    Definition Equus caballus collagen, type IX, alpha 2 (COL9A2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014737410.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCGCTG CGGCCGCCCC CCGCAGCCTC CTTGTCCTCC TCCAGGTGCT CGGGCTCGCC 
    CTGGCGCAGA TCAGAGGTCC GCCAGGAGAG CAGGGGCCCC CGGGTCCCCC GGGGCCGCCA
    GGAGTGCCTG GATCCGACGG CATCGACGGT GACAAGGGGC CCCCTGGGAA AGCTGGCCCT
    CCGGGACCTA AGGGAGAGCC TGGCCAAGCG GGGCCCGATG GACCAGACGG CAAGCCGGGG
    ACTGATGGTC TAACTGGAGC CAAGGGGGAG CCTGGCCCCA TGGGGATCCC TGGAGTCAAG
    GGCCAGCCCG GGCTCCCAGG TCCCCCCGGT CTGCCGGGCC CTGGCTTTGC TGGACCCCCT
    GGACCTCCTG GACCAGTTGG CCTCCCCGGT GAGATTGGAA TCACAGGCCC CAAGGGGGAT
    CCTGGACCAG ACGGACCATC AGGGCCCCCA GGGCCTCCTG GGAAACCGGG CCGCCCCGGA
    ACCATCGCGG GCCTGGAAGG CAGCGCCGAT TTCCTGTGTC CAACCAACTG TCCAGCGGGA
    GCTAAAGGCC CCCCAGGGCT GCAGGGAGTG AAGGGGCATC CTGGCAAACG TGGGGCTCTG
    GGCGATTCGG GCCGCCAGGG GAAGCCGGGT CCCAAGGGAG ATGTGGGTGC CTCTGGAGAG
    CAAGGCATCC CTGGACCGCC GGGTCCCCAG GGCATCAGGG GCTACCCGGG CATGGAGGGA
    CCCAAAGGAG AGACAGGTCC TCGTGGGTAC AAAGGAATGC TGGGCTCCAT TGGTGCCGCC
    GGGTCCCCGG GTGAGGAAGG GCCGCGGGGG CCACCAGGCC GCGCCGGGGA GAAGGGTGAC
    GTGGGCAGCC AAGGTGTTCG AGGACCTCAG GGAATAACAG GCCCGAAGGG AGCAACCGGT
    CCCCCAGGCA TTGACGGCAA GGACGGGGCC CCAGGCACAC CTGGTGTGAA GGGCAGTGCG
    GGACAGGCAG GACGGCCGGG AAACCCAGGC CACCAGGGCC TCGCGGGGGT GCCAGGCCAG
    CCTGGGACAA AAGGAGGCCC TGGAGACAAG GGTGAGCCAG GCCAGCAGGG CCTCCCTGGA
    TTCTCTGGTC CCCCGGGGAA GGAGGGAGAG CCAGGGCCTC GAGGAGAAAT CGGTCCCCGG
    GGCATCGTGG GCCAGAAGGG CGACCAGGGT GAGAGGGGGC CAGTGGGGCA GCCAGGCCCT
    CAAGGACGTC AGGGCCCTAA GGGGGAACAG GGGCCCCCAG GAATTCCAGG GCCCCAGGGC
    TTGCCAGGCA TCAAGGGAGA CAAGGGCTCC CCGGGGAAGA CCGGGCCCCG CGGCGGAGCG
    GGCGACCCGG GGGTGGCCGG GCTCCCCGGA GAGAAGGGCG AGAAGGGCGA GTCTGGCGAG
    CCGGGGCCCA AGGGACAGCA AGGAGTCCGC GGAGAACCCG GCTACCCGGG ACCCAGCGGG
    GATGCGGGCG CCCCAGGGGT GCAGGGCTAC CCCGGGCCCC CCGGCCCTCG AGGACTGGCT
    GGCGATCGCG GCGTGCCCGG ACAGCCCGGG AGACAGGGCG TGGCGGGCCG AGATGCCAGT
    GACCAGCACA TTGTGGACGT CGTGCTGAAG ATGCTGCAAG AGCAACTGGC AGAGGTGGCT
    GTGAGTGCCA AGCGGGAGGC CCTAGGTGCA ACAGGCATGG TGGGTCCCCC AGGACCCCCT
    GGGCCTCCTG GGTACCCAGG CAAGCAGGGA CCCCATGGGC ACCCTGGCCC TCGGGGCATT
    CCTGGCATCG TGGGAGCCGT GGGTCAGATC GGCAACACGG GGCCCAAGGG AAAACGTGGA
    GAGAAGGGCG ACCAGGGAGA CACAGGACGT GGCCATCCCG GGATGCCTGG GCCCCCAGGG
    ATCCCAGGAC TTCCTGGCCG GCCTGGCCAG GCAATCAACG GCAAGGATGG AGATCGAGGG
    TCCCCAGGTG CCCCTGGAGA GGCAGGCCGA CCTGGCCTAC CAGGCCCTGT GGGGCTTCCA
    GGCTTCTGTG AGCCTGCGGC CTGCCTCGGA GCCTCAGCCT ACGCCTCTGC ACGCCTCACG
    GAGCCTGGAT CCATCAAGGG GCCATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.