ERI2 cDNA ORF clone, Equus asinus(ass)

The following ERI2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ERI2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OEq16355 XM_014853430.1
Latest version!
Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OEq16356 XM_014853431.1
Latest version!
Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OEq16357 XM_014853432.1
Latest version!
Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OEq16355
    Clone ID Related Accession (Same CDS sequence) XM_014853430.1
    Accession Version XM_014853430.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2244bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
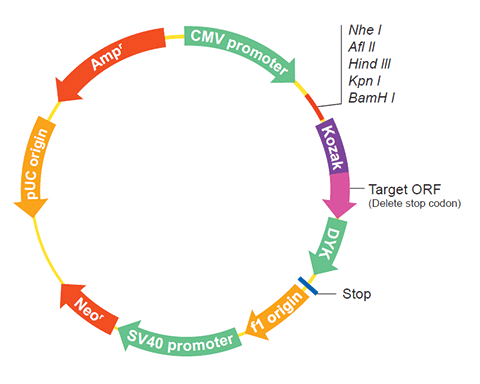
    Clone information Clone Map MSDS
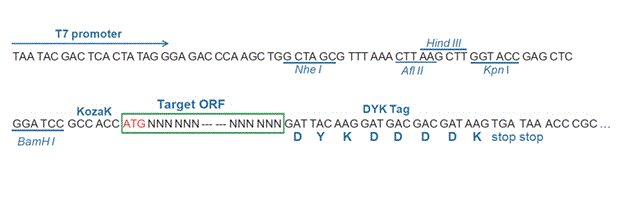
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product ERI1 exoribonuclease 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638087.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCAGATAA AAATGACTAC TAAAATCAAG AGAGGGTGGC ACTACAAAAG TCAAGGTCTT 
    TTGCCCTTAA AGTCTAGTTC AGTTTCCTCT CAATCACAAT ACATTAATAA TGAGGGTTAT
    ACCATTAGTT TGTTAGCCTA TTCAAACAGG AGTGTGAATG GGTTTGTTGA ACATACTGGG
    TTGTTTTACA TTTTTAGGCA GCTTGGATTA ATTAGGAGAA AGTCAATTGT ACCAGCAAAT
    GGAAATCTAG GAAGCAGCAA ATCCAAACAG TTGTTTGACT ACTTAATTGT CATTGATTTT
    GAGTCGACAT GCTGGAATGA TGGGAAACAC CACCAGAGCC AGGAAATAAT TGAATTTCCA
    GCAGTATTGC TGAACACATC CACTGGAGAG ATTGAATCTG AGTTCCACGC TTATGTTCAG
    CCTCAAGAAC ATCCAATTCT TTCTGAATTT TGCATGGAAC TGACAGGCAT AAAGCAGGCT
    CAAGTTGATG AAGGAGTCCC TCTGAAGATT TGCTTATCTC AGTTCTGTAA ATGGATTCAG
    AAGATTCAGC AACAGAAGAA AATTACTTTT GCTTCCGGGG TTGCAGATCT TTCTACTTCC
    GAAGTAAAAT TATGTGCATT TGTTACTTGG TCAGACTGGG ACTTGGGAGT TTGCCTGGAG
    TATGAGTGTA AAAGAAAACA ACTGTTAAAA CCTGTGTTCT TGAATTCTTG GATTGATCTC
    AGAGTAACTT ACAAGATTTT CTATAAGAGA AAACCAAAAG GACTAAGTGG TGCCCTGCAG
    GAAGTGGGAA TAGAATTCTT GGGACGAGAA CATTCTGGGT TGGATGATTC TCGGAATACT
    GCCCTTCTTG CTTGGAAAAT GATCAGGGAT GGTTGCTTCA TGAAAATTAC AAGGCCCTTG
    AAGAAGGTCC CCACTAAGAA GAATCCCAAC ATTTTGGCCA GAAATTTGAA TACAAATCAA
    GTTGAAGAAA CATCAGCCTG CAACAGTAAC ACTCAGGGTC CCAGCATATT TGATAGCGAG
    CCTAAAAATG CAATAAATCC TCATGAAAAA GTTAAAGTGA CATCAGTTGG TGTGAATCCT
    CCTATAATGG TACAGCAAGA TCAGTTACAA CTAAAGAACG ACATAAAAGT GGATCTTCAC
    AATGTCAAAA GCTGTTTCTC TCTTTTCAAT ACTAAGTCCT CCACATCTCT GGGGCAGTTG
    CAGTCTCCCA GTTTGGATAC ACCTATGCAG AAGCAAATAA AAAATGAACG TCTTGCATTT
    AATACCAAAT CTAAGTCTTC AGCAATTGGT TCAGAATTGG TACGTGTTTC AACTACCCTT
    TCATCTGTTA ATCATGTTTC TGATACAGAA ATGAGTTCTG CTTTTCACTG TTTACCTATG
    TTGGCTGATT GGGAGGATAT AGCTTTACTG CCAGCTTCTC AGCCTGAGCA AAGTGTAGAT
    TTTATGCCTG CCATTAGTGA CTCAAACTTA GATACTTCAT TTAATTCTGG AGAAAGATTA
    ATGGTTTTAA AAGAGTCTGA AATGCTGAGT CATGAAAACT TGGGAGGCAC AGAAGAAACT
    CCTCAAAAAT CTGAAACCTC TAAGTCTATT GTGTATAAGA GTCCACACAC TACTATTTAT
    GATGTAAAAG AACCCAAAAA TCCAGGTTCA GATGTTTCTG ACTTTAAATT ACCTGAATGC
    AAATCAAGTA GCTTCAACAG CGTTAATGCC AGTATGTCTC ATCTTTCAGT TTTGGGGAAA
    CATCCTCTTC TTTTAGGTGG TACTGAAAGG AGTCCATCCG TTCCCTCAGC TTTCCCACCA
    GCCAAAAAAC AGACCTTCAC TAGTCATGAA GAAAAGCCCA CATCATCTCT TGGCTCCCCA
    GGGAGAAGGT CTTCCCAGAA GGTTCTCCCC TCTGTCTTAA CTTCTACAGT TAACCTACGA
    GAGCCTTGGA AGAGTGGGAG GATGACACCT CCTTTATGCA AGTGTGGCCG AAGATGTAAG
    AGACTTGTTG TTTCTAATAA TGGACCAAAC CATGGAAAAG TCTTCTACTG TTGCCCTATT
    GGGAAATACC AAGAAAACAG AAAATGCTGT GGTTATTTCA AATGGGAACA AACACTTCAA
    AAGGAAAGAG CCAATAGCAT AGTTCAACCT CATTCCCCAG GGGGACTCGC GTTTAGTTCT
    CCAGAAATAA GCCCTATTTG TGACAGAAAT GTAAATTTTT CTACTGAAAA TTCATTAAGA
    CTCAGACCTT CAATGAGGAA TTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014708916.1
    CDS1043..3286
    Translation

    Target ORF information:

    RefSeq Version XM_014853430.1
    Organism Equus asinus(ass)
    Definition Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014853430.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCAGATAA AAATGACTAC TAAAATCAAG AGAGGGTGGC ACTACAAAAG TCAAGGTCTT 
    TTGCCCTTAA AGTCTAGTTC AGTTTCCTCT CAATCACAAT ACATTAATAA TGAGGGTTAT
    ACCATTAGTT TGTTAGCCTA TTCAAACAGG AGTGTGAATG GGTTTGTTGA ACATACTGGG
    TTGTTTTACA TTTTTAGGCA GCTTGGATTA ATTAGGAGAA AGTCAATTGT ACCAGCAAAT
    GGAAATCTAG GAAGCAGCAA ATCCAAACAG TTGTTTGACT ACTTAATTGT CATTGATTTT
    GAGTCGACAT GCTGGAATGA TGGGAAACAC CACCAGAGCC AGGAAATAAT TGAATTTCCA
    GCAGTATTGC TGAACACATC CACTGGAGAG ATTGAATCTG AGTTCCACGC TTATGTTCAG
    CCTCAAGAAC ATCCAATTCT TTCTGAATTT TGCATGGAAC TGACAGGCAT AAAGCAGGCT
    CAAGTTGATG AAGGAGTCCC TCTGAAGATT TGCTTATCTC AGTTCTGTAA ATGGATTCAG
    AAGATTCAGC AACAGAAGAA AATTACTTTT GCTTCCGGGG TTGCAGATCT TTCTACTTCC
    GAAGTAAAAT TATGTGCATT TGTTACTTGG TCAGACTGGG ACTTGGGAGT TTGCCTGGAG
    TATGAGTGTA AAAGAAAACA ACTGTTAAAA CCTGTGTTCT TGAATTCTTG GATTGATCTC
    AGAGTAACTT ACAAGATTTT CTATAAGAGA AAACCAAAAG GACTAAGTGG TGCCCTGCAG
    GAAGTGGGAA TAGAATTCTT GGGACGAGAA CATTCTGGGT TGGATGATTC TCGGAATACT
    GCCCTTCTTG CTTGGAAAAT GATCAGGGAT GGTTGCTTCA TGAAAATTAC AAGGCCCTTG
    AAGAAGGTCC CCACTAAGAA GAATCCCAAC ATTTTGGCCA GAAATTTGAA TACAAATCAA
    GTTGAAGAAA CATCAGCCTG CAACAGTAAC ACTCAGGGTC CCAGCATATT TGATAGCGAG
    CCTAAAAATG CAATAAATCC TCATGAAAAA GTTAAAGTGA CATCAGTTGG TGTGAATCCT
    CCTATAATGG TACAGCAAGA TCAGTTACAA CTAAAGAACG ACATAAAAGT GGATCTTCAC
    AATGTCAAAA GCTGTTTCTC TCTTTTCAAT ACTAAGTCCT CCACATCTCT GGGGCAGTTG
    CAGTCTCCCA GTTTGGATAC ACCTATGCAG AAGCAAATAA AAAATGAACG TCTTGCATTT
    AATACCAAAT CTAAGTCTTC AGCAATTGGT TCAGAATTGG TACGTGTTTC AACTACCCTT
    TCATCTGTTA ATCATGTTTC TGATACAGAA ATGAGTTCTG CTTTTCACTG TTTACCTATG
    TTGGCTGATT GGGAGGATAT AGCTTTACTG CCAGCTTCTC AGCCTGAGCA AAGTGTAGAT
    TTTATGCCTG CCATTAGTGA CTCAAACTTA GATACTTCAT TTAATTCTGG AGAAAGATTA
    ATGGTTTTAA AAGAGTCTGA AATGCTGAGT CATGAAAACT TGGGAGGCAC AGAAGAAACT
    CCTCAAAAAT CTGAAACCTC TAAGTCTATT GTGTATAAGA GTCCACACAC TACTATTTAT
    GATGTAAAAG AACCCAAAAA TCCAGGTTCA GATGTTTCTG ACTTTAAATT ACCTGAATGC
    AAATCAAGTA GCTTCAACAG CGTTAATGCC AGTATGTCTC ATCTTTCAGT TTTGGGGAAA
    CATCCTCTTC TTTTAGGTGG TACTGAAAGG AGTCCATCCG TTCCCTCAGC TTTCCCACCA
    GCCAAAAAAC AGACCTTCAC TAGTCATGAA GAAAAGCCCA CATCATCTCT TGGCTCCCCA
    GGGAGAAGGT CTTCCCAGAA GGTTCTCCCC TCTGTCTTAA CTTCTACAGT TAACCTACGA
    GAGCCTTGGA AGAGTGGGAG GATGACACCT CCTTTATGCA AGTGTGGCCG AAGATGTAAG
    AGACTTGTTG TTTCTAATAA TGGACCAAAC CATGGAAAAG TCTTCTACTG TTGCCCTATT
    GGGAAATACC AAGAAAACAG AAAATGCTGT GGTTATTTCA AATGGGAACA AACACTTCAA
    AAGGAAAGAG CCAATAGCAT AGTTCAACCT CATTCCCCAG GGGGACTCGC GTTTAGTTCT
    CCAGAAATAA GCCCTATTTG TGACAGAAAT GTAAATTTTT CTACTGAAAA TTCATTAAGA
    CTCAGACCTT CAATGAGGAA TTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq16356
    Clone ID Related Accession (Same CDS sequence) XM_014853431.1
    Accession Version XM_014853431.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2070bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product ERI1 exoribonuclease 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638087.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCGACCA AGAGGCTGGC CCGGCAGCTT GGATTAATTA GGAGAAAGTC AATTGTACCA 
    GCAAATGGAA ATCTAGGAAG CAGCAAATCC AAACAGTTGT TTGACTACTT AATTGTCATT
    GATTTTGAGT CGACATGCTG GAATGATGGG AAACACCACC AGAGCCAGGA AATAATTGAA
    TTTCCAGCAG TATTGCTGAA CACATCCACT GGAGAGATTG AATCTGAGTT CCACGCTTAT
    GTTCAGCCTC AAGAACATCC AATTCTTTCT GAATTTTGCA TGGAACTGAC AGGCATAAAG
    CAGGCTCAAG TTGATGAAGG AGTCCCTCTG AAGATTTGCT TATCTCAGTT CTGTAAATGG
    ATTCAGAAGA TTCAGCAACA GAAGAAAATT ACTTTTGCTT CCGGGGTTGC AGATCTTTCT
    ACTTCCGAAG TAAAATTATG TGCATTTGTT ACTTGGTCAG ACTGGGACTT GGGAGTTTGC
    CTGGAGTATG AGTGTAAAAG AAAACAACTG TTAAAACCTG TGTTCTTGAA TTCTTGGATT
    GATCTCAGAG TAACTTACAA GATTTTCTAT AAGAGAAAAC CAAAAGGACT AAGTGGTGCC
    CTGCAGGAAG TGGGAATAGA ATTCTTGGGA CGAGAACATT CTGGGTTGGA TGATTCTCGG
    AATACTGCCC TTCTTGCTTG GAAAATGATC AGGGATGGTT GCTTCATGAA AATTACAAGG
    CCCTTGAAGA AGGTCCCCAC TAAGAAGAAT CCCAACATTT TGGCCAGAAA TTTGAATACA
    AATCAAGTTG AAGAAACATC AGCCTGCAAC AGTAACACTC AGGGTCCCAG CATATTTGAT
    AGCGAGCCTA AAAATGCAAT AAATCCTCAT GAAAAAGTTA AAGTGACATC AGTTGGTGTG
    AATCCTCCTA TAATGGTACA GCAAGATCAG TTACAACTAA AGAACGACAT AAAAGTGGAT
    CTTCACAATG TCAAAAGCTG TTTCTCTCTT TTCAATACTA AGTCCTCCAC ATCTCTGGGG
    CAGTTGCAGT CTCCCAGTTT GGATACACCT ATGCAGAAGC AAATAAAAAA TGAACGTCTT
    GCATTTAATA CCAAATCTAA GTCTTCAGCA ATTGGTTCAG AATTGGTACG TGTTTCAACT
    ACCCTTTCAT CTGTTAATCA TGTTTCTGAT ACAGAAATGA GTTCTGCTTT TCACTGTTTA
    CCTATGTTGG CTGATTGGGA GGATATAGCT TTACTGCCAG CTTCTCAGCC TGAGCAAAGT
    GTAGATTTTA TGCCTGCCAT TAGTGACTCA AACTTAGATA CTTCATTTAA TTCTGGAGAA
    AGATTAATGG TTTTAAAAGA GTCTGAAATG CTGAGTCATG AAAACTTGGG AGGCACAGAA
    GAAACTCCTC AAAAATCTGA AACCTCTAAG TCTATTGTGT ATAAGAGTCC ACACACTACT
    ATTTATGATG TAAAAGAACC CAAAAATCCA GGTTCAGATG TTTCTGACTT TAAATTACCT
    GAATGCAAAT CAAGTAGCTT CAACAGCGTT AATGCCAGTA TGTCTCATCT TTCAGTTTTG
    GGGAAACATC CTCTTCTTTT AGGTGGTACT GAAAGGAGTC CATCCGTTCC CTCAGCTTTC
    CCACCAGCCA AAAAACAGAC CTTCACTAGT CATGAAGAAA AGCCCACATC ATCTCTTGGC
    TCCCCAGGGA GAAGGTCTTC CCAGAAGGTT CTCCCCTCTG TCTTAACTTC TACAGTTAAC
    CTACGAGAGC CTTGGAAGAG TGGGAGGATG ACACCTCCTT TATGCAAGTG TGGCCGAAGA
    TGTAAGAGAC TTGTTGTTTC TAATAATGGA CCAAACCATG GAAAAGTCTT CTACTGTTGC
    CCTATTGGGA AATACCAAGA AAACAGAAAA TGCTGTGGTT ATTTCAAATG GGAACAAACA
    CTTCAAAAGG AAAGAGCCAA TAGCATAGTT CAACCTCATT CCCCAGGGGG ACTCGCGTTT
    AGTTCTCCAG AAATAAGCCC TATTTGTGAC AGAAATGTAA ATTTTTCTAC TGAAAATTCA
    TTAAGACTCA GACCTTCAAT GAGGAATTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014708917.1
    CDS66..2135
    Translation

    Target ORF information:

    RefSeq Version XM_014853431.1
    Organism Equus asinus(ass)
    Definition Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014853431.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCGACCA AGAGGCTGGC CCGGCAGCTT GGATTAATTA GGAGAAAGTC AATTGTACCA 
    GCAAATGGAA ATCTAGGAAG CAGCAAATCC AAACAGTTGT TTGACTACTT AATTGTCATT
    GATTTTGAGT CGACATGCTG GAATGATGGG AAACACCACC AGAGCCAGGA AATAATTGAA
    TTTCCAGCAG TATTGCTGAA CACATCCACT GGAGAGATTG AATCTGAGTT CCACGCTTAT
    GTTCAGCCTC AAGAACATCC AATTCTTTCT GAATTTTGCA TGGAACTGAC AGGCATAAAG
    CAGGCTCAAG TTGATGAAGG AGTCCCTCTG AAGATTTGCT TATCTCAGTT CTGTAAATGG
    ATTCAGAAGA TTCAGCAACA GAAGAAAATT ACTTTTGCTT CCGGGGTTGC AGATCTTTCT
    ACTTCCGAAG TAAAATTATG TGCATTTGTT ACTTGGTCAG ACTGGGACTT GGGAGTTTGC
    CTGGAGTATG AGTGTAAAAG AAAACAACTG TTAAAACCTG TGTTCTTGAA TTCTTGGATT
    GATCTCAGAG TAACTTACAA GATTTTCTAT AAGAGAAAAC CAAAAGGACT AAGTGGTGCC
    CTGCAGGAAG TGGGAATAGA ATTCTTGGGA CGAGAACATT CTGGGTTGGA TGATTCTCGG
    AATACTGCCC TTCTTGCTTG GAAAATGATC AGGGATGGTT GCTTCATGAA AATTACAAGG
    CCCTTGAAGA AGGTCCCCAC TAAGAAGAAT CCCAACATTT TGGCCAGAAA TTTGAATACA
    AATCAAGTTG AAGAAACATC AGCCTGCAAC AGTAACACTC AGGGTCCCAG CATATTTGAT
    AGCGAGCCTA AAAATGCAAT AAATCCTCAT GAAAAAGTTA AAGTGACATC AGTTGGTGTG
    AATCCTCCTA TAATGGTACA GCAAGATCAG TTACAACTAA AGAACGACAT AAAAGTGGAT
    CTTCACAATG TCAAAAGCTG TTTCTCTCTT TTCAATACTA AGTCCTCCAC ATCTCTGGGG
    CAGTTGCAGT CTCCCAGTTT GGATACACCT ATGCAGAAGC AAATAAAAAA TGAACGTCTT
    GCATTTAATA CCAAATCTAA GTCTTCAGCA ATTGGTTCAG AATTGGTACG TGTTTCAACT
    ACCCTTTCAT CTGTTAATCA TGTTTCTGAT ACAGAAATGA GTTCTGCTTT TCACTGTTTA
    CCTATGTTGG CTGATTGGGA GGATATAGCT TTACTGCCAG CTTCTCAGCC TGAGCAAAGT
    GTAGATTTTA TGCCTGCCAT TAGTGACTCA AACTTAGATA CTTCATTTAA TTCTGGAGAA
    AGATTAATGG TTTTAAAAGA GTCTGAAATG CTGAGTCATG AAAACTTGGG AGGCACAGAA
    GAAACTCCTC AAAAATCTGA AACCTCTAAG TCTATTGTGT ATAAGAGTCC ACACACTACT
    ATTTATGATG TAAAAGAACC CAAAAATCCA GGTTCAGATG TTTCTGACTT TAAATTACCT
    GAATGCAAAT CAAGTAGCTT CAACAGCGTT AATGCCAGTA TGTCTCATCT TTCAGTTTTG
    GGGAAACATC CTCTTCTTTT AGGTGGTACT GAAAGGAGTC CATCCGTTCC CTCAGCTTTC
    CCACCAGCCA AAAAACAGAC CTTCACTAGT CATGAAGAAA AGCCCACATC ATCTCTTGGC
    TCCCCAGGGA GAAGGTCTTC CCAGAAGGTT CTCCCCTCTG TCTTAACTTC TACAGTTAAC
    CTACGAGAGC CTTGGAAGAG TGGGAGGATG ACACCTCCTT TATGCAAGTG TGGCCGAAGA
    TGTAAGAGAC TTGTTGTTTC TAATAATGGA CCAAACCATG GAAAAGTCTT CTACTGTTGC
    CCTATTGGGA AATACCAAGA AAACAGAAAA TGCTGTGGTT ATTTCAAATG GGAACAAACA
    CTTCAAAAGG AAAGAGCCAA TAGCATAGTT CAACCTCATT CCCCAGGGGG ACTCGCGTTT
    AGTTCTCCAG AAATAAGCCC TATTTGTGAC AGAAATGTAA ATTTTTCTAC TGAAAATTCA
    TTAAGACTCA GACCTTCAAT GAGGAATTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OEq16357
    Clone ID Related Accession (Same CDS sequence) XM_014853432.1
    Accession Version XM_014853432.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1791bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-01
    Organism Equus asinus(ass)
    Product ERI1 exoribonuclease 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014638087.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Equus asinus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGGAACTGA CAGGCATAAA GCAGGCTCAA GTTGATGAAG GAGTCCCTCT GAAGATTTGC 
    TTATCTCAGT TCTGTAAATG GATTCAGAAG ATTCAGCAAC AGAAGAAAAT TACTTTTGCT
    TCCGGGGTTG CAGATCTTTC TACTTCCGAA GTAAAATTAT GTGCATTTGT TACTTGGTCA
    GACTGGGACT TGGGAGTTTG CCTGGAGTAT GAGTGTAAAA GAAAACAACT GTTAAAACCT
    GTGTTCTTGA ATTCTTGGAT TGATCTCAGA GTAACTTACA AGATTTTCTA TAAGAGAAAA
    CCAAAAGGAC TAAGTGGTGC CCTGCAGGAA GTGGGAATAG AATTCTTGGG ACGAGAACAT
    TCTGGGTTGG ATGATTCTCG GAATACTGCC CTTCTTGCTT GGAAAATGAT CAGGGATGGT
    TGCTTCATGA AAATTACAAG GCCCTTGAAG AAGGTCCCCA CTAAGAAGAA TCCCAACATT
    TTGGCCAGAA ATTTGAATAC AAATCAAGTT GAAGAAACAT CAGCCTGCAA CAGTAACACT
    CAGGGTCCCA GCATATTTGA TAGCGAGCCT AAAAATGCAA TAAATCCTCA TGAAAAAGTT
    AAAGTGACAT CAGTTGGTGT GAATCCTCCT ATAATGGTAC AGCAAGATCA GTTACAACTA
    AAGAACGACA TAAAAGTGGA TCTTCACAAT GTCAAAAGCT GTTTCTCTCT TTTCAATACT
    AAGTCCTCCA CATCTCTGGG GCAGTTGCAG TCTCCCAGTT TGGATACACC TATGCAGAAG
    CAAATAAAAA ATGAACGTCT TGCATTTAAT ACCAAATCTA AGTCTTCAGC AATTGGTTCA
    GAATTGGTAC GTGTTTCAAC TACCCTTTCA TCTGTTAATC ATGTTTCTGA TACAGAAATG
    AGTTCTGCTT TTCACTGTTT ACCTATGTTG GCTGATTGGG AGGATATAGC TTTACTGCCA
    GCTTCTCAGC CTGAGCAAAG TGTAGATTTT ATGCCTGCCA TTAGTGACTC AAACTTAGAT
    ACTTCATTTA ATTCTGGAGA AAGATTAATG GTTTTAAAAG AGTCTGAAAT GCTGAGTCAT
    GAAAACTTGG GAGGCACAGA AGAAACTCCT CAAAAATCTG AAACCTCTAA GTCTATTGTG
    TATAAGAGTC CACACACTAC TATTTATGAT GTAAAAGAAC CCAAAAATCC AGGTTCAGAT
    GTTTCTGACT TTAAATTACC TGAATGCAAA TCAAGTAGCT TCAACAGCGT TAATGCCAGT
    ATGTCTCATC TTTCAGTTTT GGGGAAACAT CCTCTTCTTT TAGGTGGTAC TGAAAGGAGT
    CCATCCGTTC CCTCAGCTTT CCCACCAGCC AAAAAACAGA CCTTCACTAG TCATGAAGAA
    AAGCCCACAT CATCTCTTGG CTCCCCAGGG AGAAGGTCTT CCCAGAAGGT TCTCCCCTCT
    GTCTTAACTT CTACAGTTAA CCTACGAGAG CCTTGGAAGA GTGGGAGGAT GACACCTCCT
    TTATGCAAGT GTGGCCGAAG ATGTAAGAGA CTTGTTGTTT CTAATAATGG ACCAAACCAT
    GGAAAAGTCT TCTACTGTTG CCCTATTGGG AAATACCAAG AAAACAGAAA ATGCTGTGGT
    TATTTCAAAT GGGAACAAAC ACTTCAAAAG GAAAGAGCCA ATAGCATAGT TCAACCTCAT
    TCCCCAGGGG GACTCGCGTT TAGTTCTCCA GAAATAAGCC CTATTTGTGA CAGAAATGTA
    AATTTTTCTA CTGAAAATTC ATTAAGACTC AGACCTTCAA TGAGGAATTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014708918.1
    CDS260..2050
    Translation

    Target ORF information:

    RefSeq Version XM_014853432.1
    Organism Equus asinus(ass)
    Definition Equus asinus ERI1 exoribonuclease family member 2 (ERI2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014853432.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGGAACTGA CAGGCATAAA GCAGGCTCAA GTTGATGAAG GAGTCCCTCT GAAGATTTGC 
    TTATCTCAGT TCTGTAAATG GATTCAGAAG ATTCAGCAAC AGAAGAAAAT TACTTTTGCT
    TCCGGGGTTG CAGATCTTTC TACTTCCGAA GTAAAATTAT GTGCATTTGT TACTTGGTCA
    GACTGGGACT TGGGAGTTTG CCTGGAGTAT GAGTGTAAAA GAAAACAACT GTTAAAACCT
    GTGTTCTTGA ATTCTTGGAT TGATCTCAGA GTAACTTACA AGATTTTCTA TAAGAGAAAA
    CCAAAAGGAC TAAGTGGTGC CCTGCAGGAA GTGGGAATAG AATTCTTGGG ACGAGAACAT
    TCTGGGTTGG ATGATTCTCG GAATACTGCC CTTCTTGCTT GGAAAATGAT CAGGGATGGT
    TGCTTCATGA AAATTACAAG GCCCTTGAAG AAGGTCCCCA CTAAGAAGAA TCCCAACATT
    TTGGCCAGAA ATTTGAATAC AAATCAAGTT GAAGAAACAT CAGCCTGCAA CAGTAACACT
    CAGGGTCCCA GCATATTTGA TAGCGAGCCT AAAAATGCAA TAAATCCTCA TGAAAAAGTT
    AAAGTGACAT CAGTTGGTGT GAATCCTCCT ATAATGGTAC AGCAAGATCA GTTACAACTA
    AAGAACGACA TAAAAGTGGA TCTTCACAAT GTCAAAAGCT GTTTCTCTCT TTTCAATACT
    AAGTCCTCCA CATCTCTGGG GCAGTTGCAG TCTCCCAGTT TGGATACACC TATGCAGAAG
    CAAATAAAAA ATGAACGTCT TGCATTTAAT ACCAAATCTA AGTCTTCAGC AATTGGTTCA
    GAATTGGTAC GTGTTTCAAC TACCCTTTCA TCTGTTAATC ATGTTTCTGA TACAGAAATG
    AGTTCTGCTT TTCACTGTTT ACCTATGTTG GCTGATTGGG AGGATATAGC TTTACTGCCA
    GCTTCTCAGC CTGAGCAAAG TGTAGATTTT ATGCCTGCCA TTAGTGACTC AAACTTAGAT
    ACTTCATTTA ATTCTGGAGA AAGATTAATG GTTTTAAAAG AGTCTGAAAT GCTGAGTCAT
    GAAAACTTGG GAGGCACAGA AGAAACTCCT CAAAAATCTG AAACCTCTAA GTCTATTGTG
    TATAAGAGTC CACACACTAC TATTTATGAT GTAAAAGAAC CCAAAAATCC AGGTTCAGAT
    GTTTCTGACT TTAAATTACC TGAATGCAAA TCAAGTAGCT TCAACAGCGT TAATGCCAGT
    ATGTCTCATC TTTCAGTTTT GGGGAAACAT CCTCTTCTTT TAGGTGGTAC TGAAAGGAGT
    CCATCCGTTC CCTCAGCTTT CCCACCAGCC AAAAAACAGA CCTTCACTAG TCATGAAGAA
    AAGCCCACAT CATCTCTTGG CTCCCCAGGG AGAAGGTCTT CCCAGAAGGT TCTCCCCTCT
    GTCTTAACTT CTACAGTTAA CCTACGAGAG CCTTGGAAGA GTGGGAGGAT GACACCTCCT
    TTATGCAAGT GTGGCCGAAG ATGTAAGAGA CTTGTTGTTT CTAATAATGG ACCAAACCAT
    GGAAAAGTCT TCTACTGTTG CCCTATTGGG AAATACCAAG AAAACAGAAA ATGCTGTGGT
    TATTTCAAAT GGGAACAAAC ACTTCAAAAG GAAAGAGCCA ATAGCATAGT TCAACCTCAT
    TCCCCAGGGG GACTCGCGTT TAGTTCTCCA GAAATAAGCC CTATTTGTGA CAGAAATGTA
    AATTTTTCTA CTGAAAATTC ATTAAGACTC AGACCTTCAA TGAGGAATTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.