ARHGAP22 cDNA ORF clone, Corvus cornix cornix

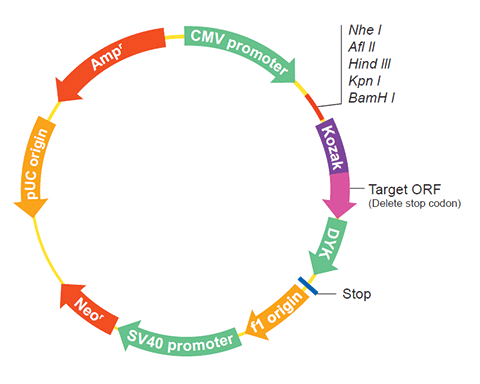
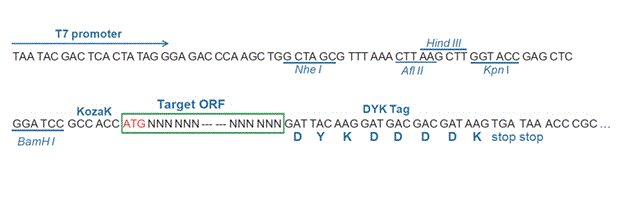
The following ARHGAP22 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ARHGAP22 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCo54809 XM_019292269.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OCo54812 XM_019292284.2
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OCo54813 XM_019292293.2
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OCo54814 XM_019292296.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X9, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OCo97189 XM_019292266.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OCo97190 XM_019292277.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OCo97191 XM_019292282.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OCo97192 XM_019292286.1
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OCo97193 XM_019292289.2
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OCo97194 XM_019292300.2
Latest version!
Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X10, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCo54809
    Clone ID Related Accession (Same CDS sequence) XM_019292269.1
    Accession Version XM_019292269.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2151bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTATTTGC TGAGTTCCCG GTCAAGGAGT CTGGTGATGG GTGAACAGAT TGGGCCTCCC 
    TCCAGACCAT CTTCTCCAAA TCCTCAAGAA CGTGTGCTGA AGTGTGGCTG GCTAAAGAAA
    CAAAGGAGCA TTATGAAGAA CTGGCAGCAG CGGTGGTTTG TGCTGCGTGG GGATCAGCTC
    TCCTATTATA AGGATGAAGA GGAAACTAAA CCTCAGGGTT TGATACTACT GCAAGGCAGT
    CAGGTGAATG AGCTGCCACC TAATCCTGAT GAACCAGGGA AACATCTCTT TGAAATTACC
    CCAGGTGGTG CAGGGGACCG GGAAAAGATG CCTGTCAATC ATGAGGCTTT CCTGCTCATG
    GCTAATTCCC AGAATGAAAT GGAAGATTGG GTGAAAGCCA TCCGACGGGT TATATGGGCT
    CCATTTGGTG GAGGTATTGC AAATAGCTCA CATGCACATA AATTAAAACA TTTGCCTCAA
    GGGATCTTTG GACAGCGCTT GGAGGACACC GTACAGTATG AGCGGAAGTA TGGCCAGCGC
    TTGGCCCCTC TGCTGGTGGA ACAGTGTGTG GATTTTATTC GGGAGCGAGG TCTTACAGAG
    GAGGGGCTCT TTCGGATGCC TGGACAAGCC AACCTTGTCA AAGATCTGCA GGATTCTTTT
    GATTGTGGAG AGAAACCCCT TTTCGACAGC AACACAGATG TTCACACTGT GGCGTCCCTC
    CTGAAGCTTT ACCTTCGAGA GCTGCCAGAG CCTGTCATCC CCTTTGCCAA ATATGAAGAC
    TTTCTTTCTT GTGGACAGCT ACTCTCAAAA GATGAGGGAG AGGGTACCCA GGAACTGGTT
    AAACAGGTGA AGAATTTGCC CCAAGCCAAC TACAACCTCC TCAAATACAT ATGCAAGTTC
    CTTGATGAAG TTCAGGCTCA CTCCAGCATT AACAAGATGA GTGTCCAGAA CCTGGCTACA
    GTATTTGGAC CAAACATACT GCGGCCCAAA ATGGAGGATC CGGTGACCAT GATGGAAGGC
    ACCTCGCTAG TTCAGCACCT GATGACAGTA CTGATAAGTG AGCAGGGGCG GATCTTTGCT
    GTTCCTCAGG CGGAGGTGCC AGGGAGCCAG CTGGAAATCA GACCTGTGCG CCAGCGCAGC
    ACTGTCGAGT GGATCTCAGA GGAGGACGGG GAGGACAGCA GGTCACAGAA CAGCGCTGCC
    AGCCCTGCTG ATTTGCCTTC TGGCAATGCT GTGGCACTAG AGGCTACTCC GGGACCTACA
    GTGAAAATCA CTCCTCCAGA GCACAGTGGC AAATCGGCCC AGCCTGCCAC AAGCCCCAGT
    AAAAGAGTGC AGACGCTGCC TCCATGGAAA TACTCCTTCC GCCAGCAGGG AGCACGGTCT
    GTGAGTCCAA AGCTGGGCAG CTCATCCTTA GATATCCCCA ACCTCTCCTC CAGCGGGAAC
    TGGTTGATGA ACGGCCTGTA CTCCCTCCGA GGCCATCGCC GGACAGCCTC TGGGGAACGA
    GTGAAAGACT CGTGTTCCTC CCAGAGACTC TCCACTTACG ACAACGTCCC TTCATCCAGC
    CTGTCCCTCA GCACGCACAG CATGGCCAGC ACCACCTGGT CTACATCATC CTGTGAGATC
    TCCGTGATGG ACTCAGTGAG CAGCTGCCCA GCCTGCCGGG CTAGTGACTC TTCTGCTTTA
    AGCTCCCTAA AAACTGAGTG GGTAACTCAG GGCTCACTGT CTCAGAGTGA GGTCAAGACA
    GCAGATCTGG AGAACAGCAT GGACAGGTTT GAAGCCTGCA GCAGCAGCAG CAGCGAACAG
    AGTGACCCAG CTGCAGCTTC CCGAGACTCT GTCCAATGCT CCAGGGCCTT ACAGAGCTTG
    GTGGTGGAGC TAAAGACAGA ACTGAGCAAA CAGAGGACTG AGTATGAGAC TAGTATCAAA
    AGAATTGAAG AAACAAGTGC AGACCTGAGG AACCAAGTGG TTAGGTTAGA AGAAGAACTG
    GATCAAGAAC GAAAGAAATA CACGATGCTG GAGATAAAGC TGAGGAATTC TGAACGCGCT
    CGTGAAGATG CTGAGAAGAG AAATTACCTC CTGCAAAAGG AAATGGAAGA ATTTTTTTCA
    ACATTAGGAT GTTTAACTGT TGGGAGTCCA AGTGCTAAAG TCCCCAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147814.1
    CDS16..2166
    Translation

    Target ORF information:

    RefSeq Version XM_019292269.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292269.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTATTTGC TGAGTTCCCG GTCAAGGAGT CTGGTGATGG GTGAACAGAT TGGGCCTCCC 
    TCCAGACCAT CTTCTCCAAA TCCTCAAGAA CGTGTGCTGA AGTGTGGCTG GCTAAAGAAA
    CAAAGGAGCA TTATGAAGAA CTGGCAGCAG CGGTGGTTTG TGCTGCGTGG GGATCAGCTC
    TCCTATTATA AGGATGAAGA GGAAACTAAA CCTCAGGGTT TGATACTACT GCAAGGCAGT
    CAGGTGAATG AGCTGCCACC TAATCCTGAT GAACCAGGGA AACATCTCTT TGAAATTACC
    CCAGGTGGTG CAGGGGACCG GGAAAAGATG CCTGTCAATC ATGAGGCTTT CCTGCTCATG
    GCTAATTCCC AGAATGAAAT GGAAGATTGG GTGAAAGCCA TCCGACGGGT TATATGGGCT
    CCATTTGGTG GAGGTATTGC AAATAGCTCA CATGCACATA AATTAAAACA TTTGCCTCAA
    GGGATCTTTG GACAGCGCTT GGAGGACACC GTACAGTATG AGCGGAAGTA TGGCCAGCGC
    TTGGCCCCTC TGCTGGTGGA ACAGTGTGTG GATTTTATTC GGGAGCGAGG TCTTACAGAG
    GAGGGGCTCT TTCGGATGCC TGGACAAGCC AACCTTGTCA AAGATCTGCA GGATTCTTTT
    GATTGTGGAG AGAAACCCCT TTTCGACAGC AACACAGATG TTCACACTGT GGCGTCCCTC
    CTGAAGCTTT ACCTTCGAGA GCTGCCAGAG CCTGTCATCC CCTTTGCCAA ATATGAAGAC
    TTTCTTTCTT GTGGACAGCT ACTCTCAAAA GATGAGGGAG AGGGTACCCA GGAACTGGTT
    AAACAGGTGA AGAATTTGCC CCAAGCCAAC TACAACCTCC TCAAATACAT ATGCAAGTTC
    CTTGATGAAG TTCAGGCTCA CTCCAGCATT AACAAGATGA GTGTCCAGAA CCTGGCTACA
    GTATTTGGAC CAAACATACT GCGGCCCAAA ATGGAGGATC CGGTGACCAT GATGGAAGGC
    ACCTCGCTAG TTCAGCACCT GATGACAGTA CTGATAAGTG AGCAGGGGCG GATCTTTGCT
    GTTCCTCAGG CGGAGGTGCC AGGGAGCCAG CTGGAAATCA GACCTGTGCG CCAGCGCAGC
    ACTGTCGAGT GGATCTCAGA GGAGGACGGG GAGGACAGCA GGTCACAGAA CAGCGCTGCC
    AGCCCTGCTG ATTTGCCTTC TGGCAATGCT GTGGCACTAG AGGCTACTCC GGGACCTACA
    GTGAAAATCA CTCCTCCAGA GCACAGTGGC AAATCGGCCC AGCCTGCCAC AAGCCCCAGT
    AAAAGAGTGC AGACGCTGCC TCCATGGAAA TACTCCTTCC GCCAGCAGGG AGCACGGTCT
    GTGAGTCCAA AGCTGGGCAG CTCATCCTTA GATATCCCCA ACCTCTCCTC CAGCGGGAAC
    TGGTTGATGA ACGGCCTGTA CTCCCTCCGA GGCCATCGCC GGACAGCCTC TGGGGAACGA
    GTGAAAGACT CGTGTTCCTC CCAGAGACTC TCCACTTACG ACAACGTCCC TTCATCCAGC
    CTGTCCCTCA GCACGCACAG CATGGCCAGC ACCACCTGGT CTACATCATC CTGTGAGATC
    TCCGTGATGG ACTCAGTGAG CAGCTGCCCA GCCTGCCGGG CTAGTGACTC TTCTGCTTTA
    AGCTCCCTAA AAACTGAGTG GGTAACTCAG GGCTCACTGT CTCAGAGTGA GGTCAAGACA
    GCAGATCTGG AGAACAGCAT GGACAGGTTT GAAGCCTGCA GCAGCAGCAG CAGCGAACAG
    AGTGACCCAG CTGCAGCTTC CCGAGACTCT GTCCAATGCT CCAGGGCCTT ACAGAGCTTG
    GTGGTGGAGC TAAAGACAGA ACTGAGCAAA CAGAGGACTG AGTATGAGAC TAGTATCAAA
    AGAATTGAAG AAACAAGTGC AGACCTGAGG AACCAAGTGG TTAGGTTAGA AGAAGAACTG
    GATCAAGAAC GAAAGAAATA CACGATGCTG GAGATAAAGC TGAGGAATTC TGAACGCGCT
    CGTGAAGATG CTGAGAAGAG AAATTACCTC CTGCAAAAGG AAATGGAAGA ATTTTTTTCA
    ACATTAGGAT GTTTAACTGT TGGGAGTCCA AGTGCTAAAG TCCCCAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo54812
    Clone ID Related Accession (Same CDS sequence) XM_019292284.2
    Accession Version XM_019292284.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1899bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019292284.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGCCGTTTT TTACTGCCAA ATATCTTAAG AAAAGCAAGT GTCTCCGAAA GGGTGGTGCA 
    GGGGACCGGG AAAAGATGCC TGTCAATCAT GAGGCTTTCC TGCTCATGGC TAATTCCCAG
    AATGAAATGG AAGATTGGGT GAAAGCCATC CGACGGGTTA TATGGGCTCC ATTTGGTGGA
    GGTATTGCAA ATAGCTCACA TGCACATAAA TTAAAACATT TGCCTCAAGG GATCTTTGGA
    CAGCGCTTGG AGGACACCGT ACAGTATGAG CGGAAGTATG GCCAGCGCTT GGCCCCTCTG
    CTGGTGGAAC AGTGTGTGGA TTTTATTCGG GAGCGAGGTC TTACAGAGGA GGGGCTCTTT
    CGGATGCCTG GACAAGCCAA CCTTGTCAAA GATCTGCAGG ATTCTTTTGA TTGTGGAGAG
    AAACCCCTTT TCGACAGCAA CACAGATGTT CACACTGTGG CGTCCCTCCT GAAGCTTTAC
    CTTCGAGAGC TGCCAGAGCC TGTCATCCCC TTTGCCAAAT ATGAAGACTT TCTTTCTTGT
    GGACAGCTAC TCTCAAAAGA TGAGGGAGAG GGTACCCAGG AACTGGTTAA ACAGGTGAAG
    AATTTGCCCC AAGCCAACTA CAACCTCCTC AAATACATAT GCAAGTTCCT TGATGAAGTT
    CAGGCTCACT CCAGCATTAA CAAGATGAGT GTCCAGAACC TGGCTACAGT ATTTGGACCA
    AACATACTGC GGCCCAAAAT GGAGGATCCG GTGACCATGA TGGAAGGCAC CTCGCTAGTT
    CAGCACCTGA TGACAGTACT GATAAGTGAG CAGGGGCGGA TCTTTGCTGT TCCTCAGGCG
    GAGGTGCCAG GGAGCCAGCT GGAAATCAGA CCTGTGCGCC AGCGCAGCAC TGTCGAGTGG
    ATCTCAGAGG AGGACGGGGA GGACAGCAGG TCACAGAACA GCGCTGCCAG CCCTGCTGAT
    TTGCCTTCTG GCAATGCTGT GGCACTAGAG GCTACTCCGG GACCTACAGT GAAAATCACT
    CCTCCAGAGC ACAGTGGCAA ATCGGCCCAG CCTGCCACAA GCCCCAGTAA AAGAGTGCAG
    ACGCTGCCTC CATGGAAATA CTCCTTCCGC CAGCAGGGAG CACGGTCTGT GAGTCCAAAG
    CTGGGCAGCT CATCCTTAGA TATCCCCAAC CTCTCCTCCA GCGGGAACTG GTTGATGAAC
    GGCCTGTACT CCCTCCGAGG CCATCGCCGG ACAGCCTCTG GGGAACGAGT GAAAGACTCG
    TGTTCCTCCC AGAGACTCTC CACTTACGAC AACGTCCCTT CATCCAGCCT GTCCCTCAGC
    ACGCACAGCA TGGCCAGCAC CACCTGGTCT ACATCATCCT GTGAGATCTC CGTGATGGAC
    TCAGTGAGCA GCTGCCCAGC CTGCCGGGCT AGTGACTCTT CTGCTTTAAG CTCCCTAAAA
    ACTGAGTGGG TAACTCAGGG CTCACTGTCT CAGAGTGAGG TCAAGACAGC AGATCTGGAG
    AACAGCATGG ACAGGTTTGA AGCCTGCAGC AGCAGCAGCA GCGAACAGAG TGACCCAGCT
    GCAGCTTCCC GAGACTCTGT CCAATGCTCC AGGGCCTTAC AGAGCTTGGT GGTGGAGCTA
    AAGACAGAAC TGAGCAAACA GAGGACTGAG TATGAGACTA GTATCAAAAG AATTGAAGAA
    ACAAGTGCAG ACCTGAGGAA CCAAGTGGTT AGGTTAGAAG AAGAACTGGA TCAAGAACGA
    AAGAAATACA CGATGCTGGA GATAAAGCTG AGGAATTCTG AACGCGCTCG TGAAGATGCT
    GAGAAGAGAA ATTACCTCCT GCAAAAGGAA ATGGAAGAAT TTTTTTCAAC ATTAGGATGT
    TTAACTGTTG GGAGTCCAAG TGCTAAAGTC CCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147829.1
    CDS188..2086
    Translation

    Target ORF information:

    RefSeq Version XM_019292284.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292284.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGCCGTTTT TTACTGCCAA ATATCTTAAG AAAAGCAAGT GTCTCCGAAA GGGTGGTGCA 
    GGGGACCGGG AAAAGATGCC TGTCAATCAT GAGGCTTTCC TGCTCATGGC TAATTCCCAG
    AATGAAATGG AAGATTGGGT GAAAGCCATC CGACGGGTTA TATGGGCTCC ATTTGGTGGA
    GGTATTGCAA ATAGCTCACA TGCACATAAA TTAAAACATT TGCCTCAAGG GATCTTTGGA
    CAGCGCTTGG AGGACACCGT ACAGTATGAG CGGAAGTATG GCCAGCGCTT GGCCCCTCTG
    CTGGTGGAAC AGTGTGTGGA TTTTATTCGG GAGCGAGGTC TTACAGAGGA GGGGCTCTTT
    CGGATGCCTG GACAAGCCAA CCTTGTCAAA GATCTGCAGG ATTCTTTTGA TTGTGGAGAG
    AAACCCCTTT TCGACAGCAA CACAGATGTT CACACTGTGG CGTCCCTCCT GAAGCTTTAC
    CTTCGAGAGC TGCCAGAGCC TGTCATCCCC TTTGCCAAAT ATGAAGACTT TCTTTCTTGT
    GGACAGCTAC TCTCAAAAGA TGAGGGAGAG GGTACCCAGG AACTGGTTAA ACAGGTGAAG
    AATTTGCCCC AAGCCAACTA CAACCTCCTC AAATACATAT GCAAGTTCCT TGATGAAGTT
    CAGGCTCACT CCAGCATTAA CAAGATGAGT GTCCAGAACC TGGCTACAGT ATTTGGACCA
    AACATACTGC GGCCCAAAAT GGAGGATCCG GTGACCATGA TGGAAGGCAC CTCGCTAGTT
    CAGCACCTGA TGACAGTACT GATAAGTGAG CAGGGGCGGA TCTTTGCTGT TCCTCAGGCG
    GAGGTGCCAG GGAGCCAGCT GGAAATCAGA CCTGTGCGCC AGCGCAGCAC TGTCGAGTGG
    ATCTCAGAGG AGGACGGGGA GGACAGCAGG TCACAGAACA GCGCTGCCAG CCCTGCTGAT
    TTGCCTTCTG GCAATGCTGT GGCACTAGAG GCTACTCCGG GACCTACAGT GAAAATCACT
    CCTCCAGAGC ACAGTGGCAA ATCGGCCCAG CCTGCCACAA GCCCCAGTAA AAGAGTGCAG
    ACGCTGCCTC CATGGAAATA CTCCTTCCGC CAGCAGGGAG CACGGTCTGT GAGTCCAAAG
    CTGGGCAGCT CATCCTTAGA TATCCCCAAC CTCTCCTCCA GCGGGAACTG GTTGATGAAC
    GGCCTGTACT CCCTCCGAGG CCATCGCCGG ACAGCCTCTG GGGAACGAGT GAAAGACTCG
    TGTTCCTCCC AGAGACTCTC CACTTACGAC AACGTCCCTT CATCCAGCCT GTCCCTCAGC
    ACGCACAGCA TGGCCAGCAC CACCTGGTCT ACATCATCCT GTGAGATCTC CGTGATGGAC
    TCAGTGAGCA GCTGCCCAGC CTGCCGGGCT AGTGACTCTT CTGCTTTAAG CTCCCTAAAA
    ACTGAGTGGG TAACTCAGGG CTCACTGTCT CAGAGTGAGG TCAAGACAGC AGATCTGGAG
    AACAGCATGG ACAGGTTTGA AGCCTGCAGC AGCAGCAGCA GCGAACAGAG TGACCCAGCT
    GCAGCTTCCC GAGACTCTGT CCAATGCTCC AGGGCCTTAC AGAGCTTGGT GGTGGAGCTA
    AAGACAGAAC TGAGCAAACA GAGGACTGAG TATGAGACTA GTATCAAAAG AATTGAAGAA
    ACAAGTGCAG ACCTGAGGAA CCAAGTGGTT AGGTTAGAAG AAGAACTGGA TCAAGAACGA
    AAGAAATACA CGATGCTGGA GATAAAGCTG AGGAATTCTG AACGCGCTCG TGAAGATGCT
    GAGAAGAGAA ATTACCTCCT GCAAAAGGAA ATGGAAGAAT TTTTTTCAAC ATTAGGATGT
    TTAACTGTTG GGAGTCCAAG TGCTAAAGTC CCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo54813
    Clone ID Related Accession (Same CDS sequence) XM_019292293.2
    Accession Version XM_019292293.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1824bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X8
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019292293.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT 
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_019147838.1
    CDS192..2015
    Translation

    Target ORF information:

    RefSeq Version XM_019292293.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292293.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT 
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo54814
    Clone ID Related Accession (Same CDS sequence) XM_019292296.1
    Accession Version XM_019292296.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1791bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X9
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGTGTCTGA TGCCTGAAGT CAGGACTTTC TTTCTCTGCC GCTCCTGCTG TCTGACACTG 
    CCTGGTTTCT GCTTGAAGCT CAGCGCCTGT CATGTAGCAG AGTGCTGCAC AAGAACGAGA
    GGGATCTTTG GACAGCGCTT GGAGGACACC GTACAGTATG AGCGGAAGTA TGGCCAGCGC
    TTGGCCCCTC TGCTGGTGGA ACAGTGTGTG GATTTTATTC GGGAGCGAGG TCTTACAGAG
    GAGGGGCTCT TTCGGATGCC TGGACAAGCC AACCTTGTCA AAGATCTGCA GGATTCTTTT
    GATTGTGGAG AGAAACCCCT TTTCGACAGC AACACAGATG TTCACACTGT GGCGTCCCTC
    CTGAAGCTTT ACCTTCGAGA GCTGCCAGAG CCTGTCATCC CCTTTGCCAA ATATGAAGAC
    TTTCTTTCTT GTGGACAGCT ACTCTCAAAA GATGAGGGAG AGGGTACCCA GGAACTGGTT
    AAACAGGTGA AGAATTTGCC CCAAGCCAAC TACAACCTCC TCAAATACAT ATGCAAGTTC
    CTTGATGAAG TTCAGGCTCA CTCCAGCATT AACAAGATGA GTGTCCAGAA CCTGGCTACA
    GTATTTGGAC CAAACATACT GCGGCCCAAA ATGGAGGATC CGGTGACCAT GATGGAAGGC
    ACCTCGCTAG TTCAGCACCT GATGACAGTA CTGATAAGTG AGCAGGGGCG GATCTTTGCT
    GTTCCTCAGG CGGAGGTGCC AGGGAGCCAG CTGGAAATCA GACCTGTGCG CCAGCGCAGC
    ACTGTCGAGT GGATCTCAGA GGAGGACGGG GAGGACAGCA GGTCACAGAA CAGCGCTGCC
    AGCCCTGCTG ATTTGCCTTC TGGCAATGCT GTGGCACTAG AGGCTACTCC GGGACCTACA
    GTGAAAATCA CTCCTCCAGA GCACAGTGGC AAATCGGCCC AGCCTGCCAC AAGCCCCAGT
    AAAAGAGTGC AGACGCTGCC TCCATGGAAA TACTCCTTCC GCCAGCAGGG AGCACGGTCT
    GTGAGTCCAA AGCTGGGCAG CTCATCCTTA GATATCCCCA ACCTCTCCTC CAGCGGGAAC
    TGGTTGATGA ACGGCCTGTA CTCCCTCCGA GGCCATCGCC GGACAGCCTC TGGGGAACGA
    GTGAAAGACT CGTGTTCCTC CCAGAGACTC TCCACTTACG ACAACGTCCC TTCATCCAGC
    CTGTCCCTCA GCACGCACAG CATGGCCAGC ACCACCTGGT CTACATCATC CTGTGAGATC
    TCCGTGATGG ACTCAGTGAG CAGCTGCCCA GCCTGCCGGG CTAGTGACTC TTCTGCTTTA
    AGCTCCCTAA AAACTGAGTG GGTAACTCAG GGCTCACTGT CTCAGAGTGA GGTCAAGACA
    GCAGATCTGG AGAACAGCAT GGACAGGTTT GAAGCCTGCA GCAGCAGCAG CAGCGAACAG
    AGTGACCCAG CTGCAGCTTC CCGAGACTCT GTCCAATGCT CCAGGGCCTT ACAGAGCTTG
    GTGGTGGAGC TAAAGACAGA ACTGAGCAAA CAGAGGACTG AGTATGAGAC TAGTATCAAA
    AGAATTGAAG AAACAAGTGC AGACCTGAGG AACCAAGTGG TTAGGTTAGA AGAAGAACTG
    GATCAAGAAC GAAAGAAATA CACGATGCTG GAGATAAAGC TGAGGAATTC TGAACGCGCT
    CGTGAAGATG CTGAGAAGAG AAATTACCTC CTGCAAAAGG AAATGGAAGA ATTTTTTTCA
    ACATTAGGAT GTTTAACTGT TGGGAGTCCA AGTGCTAAAG TCCCCAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147841.1
    CDS186..1976
    Translation

    Target ORF information:

    RefSeq Version XM_019292296.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X9, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292296.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGTGTCTGA TGCCTGAAGT CAGGACTTTC TTTCTCTGCC GCTCCTGCTG TCTGACACTG 
    CCTGGTTTCT GCTTGAAGCT CAGCGCCTGT CATGTAGCAG AGTGCTGCAC AAGAACGAGA
    GGGATCTTTG GACAGCGCTT GGAGGACACC GTACAGTATG AGCGGAAGTA TGGCCAGCGC
    TTGGCCCCTC TGCTGGTGGA ACAGTGTGTG GATTTTATTC GGGAGCGAGG TCTTACAGAG
    GAGGGGCTCT TTCGGATGCC TGGACAAGCC AACCTTGTCA AAGATCTGCA GGATTCTTTT
    GATTGTGGAG AGAAACCCCT TTTCGACAGC AACACAGATG TTCACACTGT GGCGTCCCTC
    CTGAAGCTTT ACCTTCGAGA GCTGCCAGAG CCTGTCATCC CCTTTGCCAA ATATGAAGAC
    TTTCTTTCTT GTGGACAGCT ACTCTCAAAA GATGAGGGAG AGGGTACCCA GGAACTGGTT
    AAACAGGTGA AGAATTTGCC CCAAGCCAAC TACAACCTCC TCAAATACAT ATGCAAGTTC
    CTTGATGAAG TTCAGGCTCA CTCCAGCATT AACAAGATGA GTGTCCAGAA CCTGGCTACA
    GTATTTGGAC CAAACATACT GCGGCCCAAA ATGGAGGATC CGGTGACCAT GATGGAAGGC
    ACCTCGCTAG TTCAGCACCT GATGACAGTA CTGATAAGTG AGCAGGGGCG GATCTTTGCT
    GTTCCTCAGG CGGAGGTGCC AGGGAGCCAG CTGGAAATCA GACCTGTGCG CCAGCGCAGC
    ACTGTCGAGT GGATCTCAGA GGAGGACGGG GAGGACAGCA GGTCACAGAA CAGCGCTGCC
    AGCCCTGCTG ATTTGCCTTC TGGCAATGCT GTGGCACTAG AGGCTACTCC GGGACCTACA
    GTGAAAATCA CTCCTCCAGA GCACAGTGGC AAATCGGCCC AGCCTGCCAC AAGCCCCAGT
    AAAAGAGTGC AGACGCTGCC TCCATGGAAA TACTCCTTCC GCCAGCAGGG AGCACGGTCT
    GTGAGTCCAA AGCTGGGCAG CTCATCCTTA GATATCCCCA ACCTCTCCTC CAGCGGGAAC
    TGGTTGATGA ACGGCCTGTA CTCCCTCCGA GGCCATCGCC GGACAGCCTC TGGGGAACGA
    GTGAAAGACT CGTGTTCCTC CCAGAGACTC TCCACTTACG ACAACGTCCC TTCATCCAGC
    CTGTCCCTCA GCACGCACAG CATGGCCAGC ACCACCTGGT CTACATCATC CTGTGAGATC
    TCCGTGATGG ACTCAGTGAG CAGCTGCCCA GCCTGCCGGG CTAGTGACTC TTCTGCTTTA
    AGCTCCCTAA AAACTGAGTG GGTAACTCAG GGCTCACTGT CTCAGAGTGA GGTCAAGACA
    GCAGATCTGG AGAACAGCAT GGACAGGTTT GAAGCCTGCA GCAGCAGCAG CAGCGAACAG
    AGTGACCCAG CTGCAGCTTC CCGAGACTCT GTCCAATGCT CCAGGGCCTT ACAGAGCTTG
    GTGGTGGAGC TAAAGACAGA ACTGAGCAAA CAGAGGACTG AGTATGAGAC TAGTATCAAA
    AGAATTGAAG AAACAAGTGC AGACCTGAGG AACCAAGTGG TTAGGTTAGA AGAAGAACTG
    GATCAAGAAC GAAAGAAATA CACGATGCTG GAGATAAAGC TGAGGAATTC TGAACGCGCT
    CGTGAAGATG CTGAGAAGAG AAATTACCTC CTGCAAAAGG AAATGGAAGA ATTTTTTTCA
    ACATTAGGAT GTTTAACTGT TGGGAGTCCA AGTGCTAAAG TCCCCAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97189
    Clone ID Related Accession (Same CDS sequence) XM_019292266.1
    Accession Version XM_019292266.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2184bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGTG GTGCAGGGGA CCGGGAAAAG
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147811.1
    CDS16..2199
    Translation

    Target ORF information:

    RefSeq Version XM_019292266.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292266.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGTG GTGCAGGGGA CCGGGAAAAG
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97190
    Clone ID Related Accession (Same CDS sequence) XM_019292277.1
    Accession Version XM_019292277.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2136bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGTG GTGCAGGGGA CCGGGAAAAG
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGGAT CTTTGGACAG
    CGCTTGGAGG ACACCGTACA GTATGAGCGG AAGTATGGCC AGCGCTTGGC CCCTCTGCTG
    GTGGAACAGT GTGTGGATTT TATTCGGGAG CGAGGTCTTA CAGAGGAGGG GCTCTTTCGG
    ATGCCTGGAC AAGCCAACCT TGTCAAAGAT CTGCAGGATT CTTTTGATTG TGGAGAGAAA
    CCCCTTTTCG ACAGCAACAC AGATGTTCAC ACTGTGGCGT CCCTCCTGAA GCTTTACCTT
    CGAGAGCTGC CAGAGCCTGT CATCCCCTTT GCCAAATATG AAGACTTTCT TTCTTGTGGA
    CAGCTACTCT CAAAAGATGA GGGAGAGGGT ACCCAGGAAC TGGTTAAACA GGTGAAGAAT
    TTGCCCCAAG CCAACTACAA CCTCCTCAAA TACATATGCA AGTTCCTTGA TGAAGTTCAG
    GCTCACTCCA GCATTAACAA GATGAGTGTC CAGAACCTGG CTACAGTATT TGGACCAAAC
    ATACTGCGGC CCAAAATGGA GGATCCGGTG ACCATGATGG AAGGCACCTC GCTAGTTCAG
    CACCTGATGA CAGTACTGAT AAGTGAGCAG GGGCGGATCT TTGCTGTTCC TCAGGCGGAG
    GTGCCAGGGA GCCAGCTGGA AATCAGACCT GTGCGCCAGC GCAGCACTGT CGAGTGGATC
    TCAGAGGAGG ACGGGGAGGA CAGCAGGTCA CAGAACAGCG CTGCCAGCCC TGCTGATTTG
    CCTTCTGGCA ATGCTGTGGC ACTAGAGGCT ACTCCGGGAC CTACAGTGAA AATCACTCCT
    CCAGAGCACA GTGGCAAATC GGCCCAGCCT GCCACAAGCC CCAGTAAAAG AGTGCAGACG
    CTGCCTCCAT GGAAATACTC CTTCCGCCAG CAGGGAGCAC GGTCTGTGAG TCCAAAGCTG
    GGCAGCTCAT CCTTAGATAT CCCCAACCTC TCCTCCAGCG GGAACTGGTT GATGAACGGC
    CTGTACTCCC TCCGAGGCCA TCGCCGGACA GCCTCTGGGG AACGAGTGAA AGACTCGTGT
    TCCTCCCAGA GACTCTCCAC TTACGACAAC GTCCCTTCAT CCAGCCTGTC CCTCAGCACG
    CACAGCATGG CCAGCACCAC CTGGTCTACA TCATCCTGTG AGATCTCCGT GATGGACTCA
    GTGAGCAGCT GCCCAGCCTG CCGGGCTAGT GACTCTTCTG CTTTAAGCTC CCTAAAAACT
    GAGTGGGTAA CTCAGGGCTC ACTGTCTCAG AGTGAGGTCA AGACAGCAGA TCTGGAGAAC
    AGCATGGACA GGTTTGAAGC CTGCAGCAGC AGCAGCAGCG AACAGAGTGA CCCAGCTGCA
    GCTTCCCGAG ACTCTGTCCA ATGCTCCAGG GCCTTACAGA GCTTGGTGGT GGAGCTAAAG
    ACAGAACTGA GCAAACAGAG GACTGAGTAT GAGACTAGTA TCAAAAGAAT TGAAGAAACA
    AGTGCAGACC TGAGGAACCA AGTGGTTAGG TTAGAAGAAG AACTGGATCA AGAACGAAAG
    AAATACACGA TGCTGGAGAT AAAGCTGAGG AATTCTGAAC GCGCTCGTGA AGATGCTGAG
    AAGAGAAATT ACCTCCTGCA AAAGGAAATG GAAGAATTTT TTTCAACATT AGGATGTTTA
    ACTGTTGGGA GTCCAAGTGC TAAAGTCCCC AAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147822.1
    CDS16..2151
    Translation

    Target ORF information:

    RefSeq Version XM_019292277.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292277.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGTG GTGCAGGGGA CCGGGAAAAG
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGGAT CTTTGGACAG
    CGCTTGGAGG ACACCGTACA GTATGAGCGG AAGTATGGCC AGCGCTTGGC CCCTCTGCTG
    GTGGAACAGT GTGTGGATTT TATTCGGGAG CGAGGTCTTA CAGAGGAGGG GCTCTTTCGG
    ATGCCTGGAC AAGCCAACCT TGTCAAAGAT CTGCAGGATT CTTTTGATTG TGGAGAGAAA
    CCCCTTTTCG ACAGCAACAC AGATGTTCAC ACTGTGGCGT CCCTCCTGAA GCTTTACCTT
    CGAGAGCTGC CAGAGCCTGT CATCCCCTTT GCCAAATATG AAGACTTTCT TTCTTGTGGA
    CAGCTACTCT CAAAAGATGA GGGAGAGGGT ACCCAGGAAC TGGTTAAACA GGTGAAGAAT
    TTGCCCCAAG CCAACTACAA CCTCCTCAAA TACATATGCA AGTTCCTTGA TGAAGTTCAG
    GCTCACTCCA GCATTAACAA GATGAGTGTC CAGAACCTGG CTACAGTATT TGGACCAAAC
    ATACTGCGGC CCAAAATGGA GGATCCGGTG ACCATGATGG AAGGCACCTC GCTAGTTCAG
    CACCTGATGA CAGTACTGAT AAGTGAGCAG GGGCGGATCT TTGCTGTTCC TCAGGCGGAG
    GTGCCAGGGA GCCAGCTGGA AATCAGACCT GTGCGCCAGC GCAGCACTGT CGAGTGGATC
    TCAGAGGAGG ACGGGGAGGA CAGCAGGTCA CAGAACAGCG CTGCCAGCCC TGCTGATTTG
    CCTTCTGGCA ATGCTGTGGC ACTAGAGGCT ACTCCGGGAC CTACAGTGAA AATCACTCCT
    CCAGAGCACA GTGGCAAATC GGCCCAGCCT GCCACAAGCC CCAGTAAAAG AGTGCAGACG
    CTGCCTCCAT GGAAATACTC CTTCCGCCAG CAGGGAGCAC GGTCTGTGAG TCCAAAGCTG
    GGCAGCTCAT CCTTAGATAT CCCCAACCTC TCCTCCAGCG GGAACTGGTT GATGAACGGC
    CTGTACTCCC TCCGAGGCCA TCGCCGGACA GCCTCTGGGG AACGAGTGAA AGACTCGTGT
    TCCTCCCAGA GACTCTCCAC TTACGACAAC GTCCCTTCAT CCAGCCTGTC CCTCAGCACG
    CACAGCATGG CCAGCACCAC CTGGTCTACA TCATCCTGTG AGATCTCCGT GATGGACTCA
    GTGAGCAGCT GCCCAGCCTG CCGGGCTAGT GACTCTTCTG CTTTAAGCTC CCTAAAAACT
    GAGTGGGTAA CTCAGGGCTC ACTGTCTCAG AGTGAGGTCA AGACAGCAGA TCTGGAGAAC
    AGCATGGACA GGTTTGAAGC CTGCAGCAGC AGCAGCAGCG AACAGAGTGA CCCAGCTGCA
    GCTTCCCGAG ACTCTGTCCA ATGCTCCAGG GCCTTACAGA GCTTGGTGGT GGAGCTAAAG
    ACAGAACTGA GCAAACAGAG GACTGAGTAT GAGACTAGTA TCAAAAGAAT TGAAGAAACA
    AGTGCAGACC TGAGGAACCA AGTGGTTAGG TTAGAAGAAG AACTGGATCA AGAACGAAAG
    AAATACACGA TGCTGGAGAT AAAGCTGAGG AATTCTGAAC GCGCTCGTGA AGATGCTGAG
    AAGAGAAATT ACCTCCTGCA AAAGGAAATG GAAGAATTTT TTTCAACATT AGGATGTTTA
    ACTGTTGGGA GTCCAAGTGC TAAAGTCCCC AAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97191
    Clone ID Related Accession (Same CDS sequence) XM_019292282.1
    Accession Version XM_019292282.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2007bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGGA TCTTTGGACA GCGCTTGGAG
    GACACCGTAC AGTATGAGCG GAAGTATGGC CAGCGCTTGG CCCCTCTGCT GGTGGAACAG
    TGTGTGGATT TTATTCGGGA GCGAGGTCTT ACAGAGGAGG GGCTCTTTCG GATGCCTGGA
    CAAGCCAACC TTGTCAAAGA TCTGCAGGAT TCTTTTGATT GTGGAGAGAA ACCCCTTTTC
    GACAGCAACA CAGATGTTCA CACTGTGGCG TCCCTCCTGA AGCTTTACCT TCGAGAGCTG
    CCAGAGCCTG TCATCCCCTT TGCCAAATAT GAAGACTTTC TTTCTTGTGG ACAGCTACTC
    TCAAAAGATG AGGGAGAGGG TACCCAGGAA CTGGTTAAAC AGGTGAAGAA TTTGCCCCAA
    GCCAACTACA ACCTCCTCAA ATACATATGC AAGTTCCTTG ATGAAGTTCA GGCTCACTCC
    AGCATTAACA AGATGAGTGT CCAGAACCTG GCTACAGTAT TTGGACCAAA CATACTGCGG
    CCCAAAATGG AGGATCCGGT GACCATGATG GAAGGCACCT CGCTAGTTCA GCACCTGATG
    ACAGTACTGA TAAGTGAGCA GGGGCGGATC TTTGCTGTTC CTCAGGCGGA GGTGCCAGGG
    AGCCAGCTGG AAATCAGACC TGTGCGCCAG CGCAGCACTG TCGAGTGGAT CTCAGAGGAG
    GACGGGGAGG ACAGCAGGTC ACAGAACAGC GCTGCCAGCC CTGCTGATTT GCCTTCTGGC
    AATGCTGTGG CACTAGAGGC TACTCCGGGA CCTACAGTGA AAATCACTCC TCCAGAGCAC
    AGTGGCAAAT CGGCCCAGCC TGCCACAAGC CCCAGTAAAA GAGTGCAGAC GCTGCCTCCA
    TGGAAATACT CCTTCCGCCA GCAGGGAGCA CGGTCTGTGA GTCCAAAGCT GGGCAGCTCA
    TCCTTAGATA TCCCCAACCT CTCCTCCAGC GGGAACTGGT TGATGAACGG CCTGTACTCC
    CTCCGAGGCC ATCGCCGGAC AGCCTCTGGG GAACGAGTGA AAGACTCGTG TTCCTCCCAG
    AGACTCTCCA CTTACGACAA CGTCCCTTCA TCCAGCCTGT CCCTCAGCAC GCACAGCATG
    GCCAGCACCA CCTGGTCTAC ATCATCCTGT GAGATCTCCG TGATGGACTC AGTGAGCAGC
    TGCCCAGCCT GCCGGGCTAG TGACTCTTCT GCTTTAAGCT CCCTAAAAAC TGAGTGGGTA
    ACTCAGGGCT CACTGTCTCA GAGTGAGGTC AAGACAGCAG ATCTGGAGAA CAGCATGGAC
    AGGTTTGAAG CCTGCAGCAG CAGCAGCAGC GAACAGAGTG ACCCAGCTGC AGCTTCCCGA
    GACTCTGTCC AATGCTCCAG GGCCTTACAG AGCTTGGTGG TGGAGCTAAA GACAGAACTG
    AGCAAACAGA GGACTGAGTA TGAGACTAGT ATCAAAAGAA TTGAAGAAAC AAGTGCAGAC
    CTGAGGAACC AAGTGGTTAG GTTAGAAGAA GAACTGGATC AAGAACGAAA GAAATACACG
    ATGCTGGAGA TAAAGCTGAG GAATTCTGAA CGCGCTCGTG AAGATGCTGA GAAGAGAAAT
    TACCTCCTGC AAAAGGAAAT GGAAGAATTT TTTTCAACAT TAGGATGTTT AACTGTTGGG
    AGTCCAAGTG CTAAAGTCCC CAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147827.1
    CDS16..2022
    Translation

    Target ORF information:

    RefSeq Version XM_019292282.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292282.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGGGACTAC AAGAGATGCA ACAGAGATGC CTTCAGCGGT GCTTGTCAGC CCGGTCAAGG 
    AGTCTGGTGA TGGGTGAACA GATTGGGCCT CCCTCCAGAC CATCTTCTCC AAATCCTCAA
    GAACGTGTGC TGAAGTGTGG CTGGCTAAAG AAACAAAGGA GCATTATGAA GAACTGGCAG
    CAGCGGTGGT TTGTGCTGCG TGGGGATCAG CTCTCCTATT ATAAGGATGA AGAGGAAACT
    AAACCTCAGG GTTTGATACT ACTGCAAGGC AGTCAGGTGA ATGAGCTGCC ACCTAATCCT
    GATGAACCAG GGAAACATCT CTTTGAAATT ACCCCAGGGA TCTTTGGACA GCGCTTGGAG
    GACACCGTAC AGTATGAGCG GAAGTATGGC CAGCGCTTGG CCCCTCTGCT GGTGGAACAG
    TGTGTGGATT TTATTCGGGA GCGAGGTCTT ACAGAGGAGG GGCTCTTTCG GATGCCTGGA
    CAAGCCAACC TTGTCAAAGA TCTGCAGGAT TCTTTTGATT GTGGAGAGAA ACCCCTTTTC
    GACAGCAACA CAGATGTTCA CACTGTGGCG TCCCTCCTGA AGCTTTACCT TCGAGAGCTG
    CCAGAGCCTG TCATCCCCTT TGCCAAATAT GAAGACTTTC TTTCTTGTGG ACAGCTACTC
    TCAAAAGATG AGGGAGAGGG TACCCAGGAA CTGGTTAAAC AGGTGAAGAA TTTGCCCCAA
    GCCAACTACA ACCTCCTCAA ATACATATGC AAGTTCCTTG ATGAAGTTCA GGCTCACTCC
    AGCATTAACA AGATGAGTGT CCAGAACCTG GCTACAGTAT TTGGACCAAA CATACTGCGG
    CCCAAAATGG AGGATCCGGT GACCATGATG GAAGGCACCT CGCTAGTTCA GCACCTGATG
    ACAGTACTGA TAAGTGAGCA GGGGCGGATC TTTGCTGTTC CTCAGGCGGA GGTGCCAGGG
    AGCCAGCTGG AAATCAGACC TGTGCGCCAG CGCAGCACTG TCGAGTGGAT CTCAGAGGAG
    GACGGGGAGG ACAGCAGGTC ACAGAACAGC GCTGCCAGCC CTGCTGATTT GCCTTCTGGC
    AATGCTGTGG CACTAGAGGC TACTCCGGGA CCTACAGTGA AAATCACTCC TCCAGAGCAC
    AGTGGCAAAT CGGCCCAGCC TGCCACAAGC CCCAGTAAAA GAGTGCAGAC GCTGCCTCCA
    TGGAAATACT CCTTCCGCCA GCAGGGAGCA CGGTCTGTGA GTCCAAAGCT GGGCAGCTCA
    TCCTTAGATA TCCCCAACCT CTCCTCCAGC GGGAACTGGT TGATGAACGG CCTGTACTCC
    CTCCGAGGCC ATCGCCGGAC AGCCTCTGGG GAACGAGTGA AAGACTCGTG TTCCTCCCAG
    AGACTCTCCA CTTACGACAA CGTCCCTTCA TCCAGCCTGT CCCTCAGCAC GCACAGCATG
    GCCAGCACCA CCTGGTCTAC ATCATCCTGT GAGATCTCCG TGATGGACTC AGTGAGCAGC
    TGCCCAGCCT GCCGGGCTAG TGACTCTTCT GCTTTAAGCT CCCTAAAAAC TGAGTGGGTA
    ACTCAGGGCT CACTGTCTCA GAGTGAGGTC AAGACAGCAG ATCTGGAGAA CAGCATGGAC
    AGGTTTGAAG CCTGCAGCAG CAGCAGCAGC GAACAGAGTG ACCCAGCTGC AGCTTCCCGA
    GACTCTGTCC AATGCTCCAG GGCCTTACAG AGCTTGGTGG TGGAGCTAAA GACAGAACTG
    AGCAAACAGA GGACTGAGTA TGAGACTAGT ATCAAAAGAA TTGAAGAAAC AAGTGCAGAC
    CTGAGGAACC AAGTGGTTAG GTTAGAAGAA GAACTGGATC AAGAACGAAA GAAATACACG
    ATGCTGGAGA TAAAGCTGAG GAATTCTGAA CGCGCTCGTG AAGATGCTGA GAAGAGAAAT
    TACCTCCTGC AAAAGGAAAT GGAAGAATTT TTTTCAACAT TAGGATGTTT AACTGTTGGG
    AGTCCAAGTG CTAAAGTCCC CAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97192
    Clone ID Related Accession (Same CDS sequence) XM_019292286.1
    Accession Version XM_019292286.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1884bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTGGTATC AAAGATGCTA TGTATCATCT TGGACTGGTG GTGCAGGGGA CCGGGAAAAG 
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147831.1
    CDS34..1917
    Translation

    Target ORF information:

    RefSeq Version XM_019292286.1
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292286.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGTGGTATC AAAGATGCTA TGTATCATCT TGGACTGGTG GTGCAGGGGA CCGGGAAAAG 
    ATGCCTGTCA ATCATGAGGC TTTCCTGCTC ATGGCTAATT CCCAGAATGA AATGGAAGAT
    TGGGTGAAAG CCATCCGACG GGTTATATGG GCTCCATTTG GTGGAGGTAT TGCAAATAGC
    TCACATGCAC ATAAATTAAA ACATTTGCCT CAAGGGATCT TTGGACAGCG CTTGGAGGAC
    ACCGTACAGT ATGAGCGGAA GTATGGCCAG CGCTTGGCCC CTCTGCTGGT GGAACAGTGT
    GTGGATTTTA TTCGGGAGCG AGGTCTTACA GAGGAGGGGC TCTTTCGGAT GCCTGGACAA
    GCCAACCTTG TCAAAGATCT GCAGGATTCT TTTGATTGTG GAGAGAAACC CCTTTTCGAC
    AGCAACACAG ATGTTCACAC TGTGGCGTCC CTCCTGAAGC TTTACCTTCG AGAGCTGCCA
    GAGCCTGTCA TCCCCTTTGC CAAATATGAA GACTTTCTTT CTTGTGGACA GCTACTCTCA
    AAAGATGAGG GAGAGGGTAC CCAGGAACTG GTTAAACAGG TGAAGAATTT GCCCCAAGCC
    AACTACAACC TCCTCAAATA CATATGCAAG TTCCTTGATG AAGTTCAGGC TCACTCCAGC
    ATTAACAAGA TGAGTGTCCA GAACCTGGCT ACAGTATTTG GACCAAACAT ACTGCGGCCC
    AAAATGGAGG ATCCGGTGAC CATGATGGAA GGCACCTCGC TAGTTCAGCA CCTGATGACA
    GTACTGATAA GTGAGCAGGG GCGGATCTTT GCTGTTCCTC AGGCGGAGGT GCCAGGGAGC
    CAGCTGGAAA TCAGACCTGT GCGCCAGCGC AGCACTGTCG AGTGGATCTC AGAGGAGGAC
    GGGGAGGACA GCAGGTCACA GAACAGCGCT GCCAGCCCTG CTGATTTGCC TTCTGGCAAT
    GCTGTGGCAC TAGAGGCTAC TCCGGGACCT ACAGTGAAAA TCACTCCTCC AGAGCACAGT
    GGCAAATCGG CCCAGCCTGC CACAAGCCCC AGTAAAAGAG TGCAGACGCT GCCTCCATGG
    AAATACTCCT TCCGCCAGCA GGGAGCACGG TCTGTGAGTC CAAAGCTGGG CAGCTCATCC
    TTAGATATCC CCAACCTCTC CTCCAGCGGG AACTGGTTGA TGAACGGCCT GTACTCCCTC
    CGAGGCCATC GCCGGACAGC CTCTGGGGAA CGAGTGAAAG ACTCGTGTTC CTCCCAGAGA
    CTCTCCACTT ACGACAACGT CCCTTCATCC AGCCTGTCCC TCAGCACGCA CAGCATGGCC
    AGCACCACCT GGTCTACATC ATCCTGTGAG ATCTCCGTGA TGGACTCAGT GAGCAGCTGC
    CCAGCCTGCC GGGCTAGTGA CTCTTCTGCT TTAAGCTCCC TAAAAACTGA GTGGGTAACT
    CAGGGCTCAC TGTCTCAGAG TGAGGTCAAG ACAGCAGATC TGGAGAACAG CATGGACAGG
    TTTGAAGCCT GCAGCAGCAG CAGCAGCGAA CAGAGTGACC CAGCTGCAGC TTCCCGAGAC
    TCTGTCCAAT GCTCCAGGGC CTTACAGAGC TTGGTGGTGG AGCTAAAGAC AGAACTGAGC
    AAACAGAGGA CTGAGTATGA GACTAGTATC AAAAGAATTG AAGAAACAAG TGCAGACCTG
    AGGAACCAAG TGGTTAGGTT AGAAGAAGAA CTGGATCAAG AACGAAAGAA ATACACGATG
    CTGGAGATAA AGCTGAGGAA TTCTGAACGC GCTCGTGAAG ATGCTGAGAA GAGAAATTAC
    CTCCTGCAAA AGGAAATGGA AGAATTTTTT TCAACATTAG GATGTTTAAC TGTTGGGAGT
    CCAAGTGCTA AAGTCCCCAA GTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97193
    Clone ID Related Accession (Same CDS sequence) XM_019292289.2
    Accession Version XM_019292289.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1860bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X7
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019292289.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGTTTGGTG GTGGTGGTGC AGGGGACCGG GAAAAGATGC CTGTCAATCA TGAGGCTTTC 
    CTGCTCATGG CTAATTCCCA GAATGAAATG GAAGATTGGG TGAAAGCCAT CCGACGGGTT
    ATATGGGCTC CATTTGGTGG AGGTATTGCA AATAGCTCAC ATGCACATAA ATTAAAACAT
    TTGCCTCAAG GGATCTTTGG ACAGCGCTTG GAGGACACCG TACAGTATGA GCGGAAGTAT
    GGCCAGCGCT TGGCCCCTCT GCTGGTGGAA CAGTGTGTGG ATTTTATTCG GGAGCGAGGT
    CTTACAGAGG AGGGGCTCTT TCGGATGCCT GGACAAGCCA ACCTTGTCAA AGATCTGCAG
    GATTCTTTTG ATTGTGGAGA GAAACCCCTT TTCGACAGCA ACACAGATGT TCACACTGTG
    GCGTCCCTCC TGAAGCTTTA CCTTCGAGAG CTGCCAGAGC CTGTCATCCC CTTTGCCAAA
    TATGAAGACT TTCTTTCTTG TGGACAGCTA CTCTCAAAAG ATGAGGGAGA GGGTACCCAG
    GAACTGGTTA AACAGGTGAA GAATTTGCCC CAAGCCAACT ACAACCTCCT CAAATACATA
    TGCAAGTTCC TTGATGAAGT TCAGGCTCAC TCCAGCATTA ACAAGATGAG TGTCCAGAAC
    CTGGCTACAG TATTTGGACC AAACATACTG CGGCCCAAAA TGGAGGATCC GGTGACCATG
    ATGGAAGGCA CCTCGCTAGT TCAGCACCTG ATGACAGTAC TGATAAGTGA GCAGGGGCGG
    ATCTTTGCTG TTCCTCAGGC GGAGGTGCCA GGGAGCCAGC TGGAAATCAG ACCTGTGCGC
    CAGCGCAGCA CTGTCGAGTG GATCTCAGAG GAGGACGGGG AGGACAGCAG GTCACAGAAC
    AGCGCTGCCA GCCCTGCTGA TTTGCCTTCT GGCAATGCTG TGGCACTAGA GGCTACTCCG
    GGACCTACAG TGAAAATCAC TCCTCCAGAG CACAGTGGCA AATCGGCCCA GCCTGCCACA
    AGCCCCAGTA AAAGAGTGCA GACGCTGCCT CCATGGAAAT ACTCCTTCCG CCAGCAGGGA
    GCACGGTCTG TGAGTCCAAA GCTGGGCAGC TCATCCTTAG ATATCCCCAA CCTCTCCTCC
    AGCGGGAACT GGTTGATGAA CGGCCTGTAC TCCCTCCGAG GCCATCGCCG GACAGCCTCT
    GGGGAACGAG TGAAAGACTC GTGTTCCTCC CAGAGACTCT CCACTTACGA CAACGTCCCT
    TCATCCAGCC TGTCCCTCAG CACGCACAGC ATGGCCAGCA CCACCTGGTC TACATCATCC
    TGTGAGATCT CCGTGATGGA CTCAGTGAGC AGCTGCCCAG CCTGCCGGGC TAGTGACTCT
    TCTGCTTTAA GCTCCCTAAA AACTGAGTGG GTAACTCAGG GCTCACTGTC TCAGAGTGAG
    GTCAAGACAG CAGATCTGGA GAACAGCATG GACAGGTTTG AAGCCTGCAG CAGCAGCAGC
    AGCGAACAGA GTGACCCAGC TGCAGCTTCC CGAGACTCTG TCCAATGCTC CAGGGCCTTA
    CAGAGCTTGG TGGTGGAGCT AAAGACAGAA CTGAGCAAAC AGAGGACTGA GTATGAGACT
    AGTATCAAAA GAATTGAAGA AACAAGTGCA GACCTGAGGA ACCAAGTGGT TAGGTTAGAA
    GAAGAACTGG ATCAAGAACG AAAGAAATAC ACGATGCTGG AGATAAAGCT GAGGAATTCT
    GAACGCGCTC GTGAAGATGC TGAGAAGAGA AATTACCTCC TGCAAAAGGA AATGGAAGAA
    TTTTTTTCAA CATTAGGATG TTTAACTGTT GGGAGTCCAA GTGCTAAAGT CCCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147834.1
    CDS16..1875
    Translation

    Target ORF information:

    RefSeq Version XM_019292289.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292289.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGTTTGGTG GTGGTGGTGC AGGGGACCGG GAAAAGATGC CTGTCAATCA TGAGGCTTTC 
    CTGCTCATGG CTAATTCCCA GAATGAAATG GAAGATTGGG TGAAAGCCAT CCGACGGGTT
    ATATGGGCTC CATTTGGTGG AGGTATTGCA AATAGCTCAC ATGCACATAA ATTAAAACAT
    TTGCCTCAAG GGATCTTTGG ACAGCGCTTG GAGGACACCG TACAGTATGA GCGGAAGTAT
    GGCCAGCGCT TGGCCCCTCT GCTGGTGGAA CAGTGTGTGG ATTTTATTCG GGAGCGAGGT
    CTTACAGAGG AGGGGCTCTT TCGGATGCCT GGACAAGCCA ACCTTGTCAA AGATCTGCAG
    GATTCTTTTG ATTGTGGAGA GAAACCCCTT TTCGACAGCA ACACAGATGT TCACACTGTG
    GCGTCCCTCC TGAAGCTTTA CCTTCGAGAG CTGCCAGAGC CTGTCATCCC CTTTGCCAAA
    TATGAAGACT TTCTTTCTTG TGGACAGCTA CTCTCAAAAG ATGAGGGAGA GGGTACCCAG
    GAACTGGTTA AACAGGTGAA GAATTTGCCC CAAGCCAACT ACAACCTCCT CAAATACATA
    TGCAAGTTCC TTGATGAAGT TCAGGCTCAC TCCAGCATTA ACAAGATGAG TGTCCAGAAC
    CTGGCTACAG TATTTGGACC AAACATACTG CGGCCCAAAA TGGAGGATCC GGTGACCATG
    ATGGAAGGCA CCTCGCTAGT TCAGCACCTG ATGACAGTAC TGATAAGTGA GCAGGGGCGG
    ATCTTTGCTG TTCCTCAGGC GGAGGTGCCA GGGAGCCAGC TGGAAATCAG ACCTGTGCGC
    CAGCGCAGCA CTGTCGAGTG GATCTCAGAG GAGGACGGGG AGGACAGCAG GTCACAGAAC
    AGCGCTGCCA GCCCTGCTGA TTTGCCTTCT GGCAATGCTG TGGCACTAGA GGCTACTCCG
    GGACCTACAG TGAAAATCAC TCCTCCAGAG CACAGTGGCA AATCGGCCCA GCCTGCCACA
    AGCCCCAGTA AAAGAGTGCA GACGCTGCCT CCATGGAAAT ACTCCTTCCG CCAGCAGGGA
    GCACGGTCTG TGAGTCCAAA GCTGGGCAGC TCATCCTTAG ATATCCCCAA CCTCTCCTCC
    AGCGGGAACT GGTTGATGAA CGGCCTGTAC TCCCTCCGAG GCCATCGCCG GACAGCCTCT
    GGGGAACGAG TGAAAGACTC GTGTTCCTCC CAGAGACTCT CCACTTACGA CAACGTCCCT
    TCATCCAGCC TGTCCCTCAG CACGCACAGC ATGGCCAGCA CCACCTGGTC TACATCATCC
    TGTGAGATCT CCGTGATGGA CTCAGTGAGC AGCTGCCCAG CCTGCCGGGC TAGTGACTCT
    TCTGCTTTAA GCTCCCTAAA AACTGAGTGG GTAACTCAGG GCTCACTGTC TCAGAGTGAG
    GTCAAGACAG CAGATCTGGA GAACAGCATG GACAGGTTTG AAGCCTGCAG CAGCAGCAGC
    AGCGAACAGA GTGACCCAGC TGCAGCTTCC CGAGACTCTG TCCAATGCTC CAGGGCCTTA
    CAGAGCTTGG TGGTGGAGCT AAAGACAGAA CTGAGCAAAC AGAGGACTGA GTATGAGACT
    AGTATCAAAA GAATTGAAGA AACAAGTGCA GACCTGAGGA ACCAAGTGGT TAGGTTAGAA
    GAAGAACTGG ATCAAGAACG AAAGAAATAC ACGATGCTGG AGATAAAGCT GAGGAATTCT
    GAACGCGCTC GTGAAGATGC TGAGAAGAGA AATTACCTCC TGCAAAAGGA AATGGAAGAA
    TTTTTTTCAA CATTAGGATG TTTAACTGTT GGGAGTCCAA GTGCTAAAGT CCCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo97194
    Clone ID Related Accession (Same CDS sequence) XM_019292300.2
    Accession Version XM_019292300.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1710bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product rho GTPase-activating protein 22 isoform X10
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018113989.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019292300.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    ATGGGACAAA CGTGTTCCTG TGGTGTTTCT CAGCTTGCAG GGATCTTTGG ACAGCGCTTG 
    GAGGACACCG TACAGTATGA GCGGAAGTAT GGCCAGCGCT TGGCCCCTCT GCTGGTGGAA
    CAGTGTGTGG ATTTTATTCG GGAGCGAGGT CTTACAGAGG AGGGGCTCTT TCGGATGCCT
    GGACAAGCCA ACCTTGTCAA AGATCTGCAG GATTCTTTTG ATTGTGGAGA GAAACCCCTT
    TTCGACAGCA ACACAGATGT TCACACTGTG GCGTCCCTCC TGAAGCTTTA CCTTCGAGAG
    CTGCCAGAGC CTGTCATCCC CTTTGCCAAA TATGAAGACT TTCTTTCTTG TGGACAGCTA
    CTCTCAAAAG ATGAGGGAGA GGGTACCCAG GAACTGGTTA AACAGGTGAA GAATTTGCCC
    CAAGCCAACT ACAACCTCCT CAAATACATA TGCAAGTTCC TTGATGAAGT TCAGGCTCAC
    TCCAGCATTA ACAAGATGAG TGTCCAGAAC CTGGCTACAG TATTTGGACC AAACATACTG
    CGGCCCAAAA TGGAGGATCC GGTGACCATG ATGGAAGGCA CCTCGCTAGT TCAGCACCTG
    ATGACAGTAC TGATAAGTGA GCAGGGGCGG ATCTTTGCTG TTCCTCAGGC GGAGGTGCCA
    GGGAGCCAGC TGGAAATCAG ACCTGTGCGC CAGCGCAGCA CTGTCGAGTG GATCTCAGAG
    GAGGACGGGG AGGACAGCAG GTCACAGAAC AGCGCTGCCA GCCCTGCTGA TTTGCCTTCT
    GGCAATGCTG TGGCACTAGA GGCTACTCCG GGACCTACAG TGAAAATCAC TCCTCCAGAG
    CACAGTGGCA AATCGGCCCA GCCTGCCACA AGCCCCAGTA AAAGAGTGCA GACGCTGCCT
    CCATGGAAAT ACTCCTTCCG CCAGCAGGGA GCACGGTCTG TGAGTCCAAA GCTGGGCAGC
    TCATCCTTAG ATATCCCCAA CCTCTCCTCC AGCGGGAACT GGTTGATGAA CGGCCTGTAC
    TCCCTCCGAG GCCATCGCCG GACAGCCTCT GGGGAACGAG TGAAAGACTC GTGTTCCTCC
    CAGAGACTCT CCACTTACGA CAACGTCCCT TCATCCAGCC TGTCCCTCAG CACGCACAGC
    ATGGCCAGCA CCACCTGGTC TACATCATCC TGTGAGATCT CCGTGATGGA CTCAGTGAGC
    AGCTGCCCAG CCTGCCGGGC TAGTGACTCT TCTGCTTTAA GCTCCCTAAA AACTGAGTGG
    GTAACTCAGG GCTCACTGTC TCAGAGTGAG GTCAAGACAG CAGATCTGGA GAACAGCATG
    GACAGGTTTG AAGCCTGCAG CAGCAGCAGC AGCGAACAGA GTGACCCAGC TGCAGCTTCC
    CGAGACTCTG TCCAATGCTC CAGGGCCTTA CAGAGCTTGG TGGTGGAGCT AAAGACAGAA
    CTGAGCAAAC AGAGGACTGA GTATGAGACT AGTATCAAAA GAATTGAAGA AACAAGTGCA
    GACCTGAGGA ACCAAGTGGT TAGGTTAGAA GAAGAACTGG ATCAAGAACG AAAGAAATAC
    ACGATGCTGG AGATAAAGCT GAGGAATTCT GAACGCGCTC GTGAAGATGC TGAGAAGAGA
    AATTACCTCC TGCAAAAGGA AATGGAAGAA TTTTTTTCAA CATTAGGATG TTTAACTGTT
    GGGAGTCCAA GTGCTAAAGT CCCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019147845.1
    CDS34..1743
    Translation

    Target ORF information:

    RefSeq Version XM_019292300.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix Rho GTPase activating protein 22 (ARHGAP22), transcript variant X10, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019292300.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    ATGGGACAAA CGTGTTCCTG TGGTGTTTCT CAGCTTGCAG GGATCTTTGG ACAGCGCTTG 
    GAGGACACCG TACAGTATGA GCGGAAGTAT GGCCAGCGCT TGGCCCCTCT GCTGGTGGAA
    CAGTGTGTGG ATTTTATTCG GGAGCGAGGT CTTACAGAGG AGGGGCTCTT TCGGATGCCT
    GGACAAGCCA ACCTTGTCAA AGATCTGCAG GATTCTTTTG ATTGTGGAGA GAAACCCCTT
    TTCGACAGCA ACACAGATGT TCACACTGTG GCGTCCCTCC TGAAGCTTTA CCTTCGAGAG
    CTGCCAGAGC CTGTCATCCC CTTTGCCAAA TATGAAGACT TTCTTTCTTG TGGACAGCTA
    CTCTCAAAAG ATGAGGGAGA GGGTACCCAG GAACTGGTTA AACAGGTGAA GAATTTGCCC
    CAAGCCAACT ACAACCTCCT CAAATACATA TGCAAGTTCC TTGATGAAGT TCAGGCTCAC
    TCCAGCATTA ACAAGATGAG TGTCCAGAAC CTGGCTACAG TATTTGGACC AAACATACTG
    CGGCCCAAAA TGGAGGATCC GGTGACCATG ATGGAAGGCA CCTCGCTAGT TCAGCACCTG
    ATGACAGTAC TGATAAGTGA GCAGGGGCGG ATCTTTGCTG TTCCTCAGGC GGAGGTGCCA
    GGGAGCCAGC TGGAAATCAG ACCTGTGCGC CAGCGCAGCA CTGTCGAGTG GATCTCAGAG
    GAGGACGGGG AGGACAGCAG GTCACAGAAC AGCGCTGCCA GCCCTGCTGA TTTGCCTTCT
    GGCAATGCTG TGGCACTAGA GGCTACTCCG GGACCTACAG TGAAAATCAC TCCTCCAGAG
    CACAGTGGCA AATCGGCCCA GCCTGCCACA AGCCCCAGTA AAAGAGTGCA GACGCTGCCT
    CCATGGAAAT ACTCCTTCCG CCAGCAGGGA GCACGGTCTG TGAGTCCAAA GCTGGGCAGC
    TCATCCTTAG ATATCCCCAA CCTCTCCTCC AGCGGGAACT GGTTGATGAA CGGCCTGTAC
    TCCCTCCGAG GCCATCGCCG GACAGCCTCT GGGGAACGAG TGAAAGACTC GTGTTCCTCC
    CAGAGACTCT CCACTTACGA CAACGTCCCT TCATCCAGCC TGTCCCTCAG CACGCACAGC
    ATGGCCAGCA CCACCTGGTC TACATCATCC TGTGAGATCT CCGTGATGGA CTCAGTGAGC
    AGCTGCCCAG CCTGCCGGGC TAGTGACTCT TCTGCTTTAA GCTCCCTAAA AACTGAGTGG
    GTAACTCAGG GCTCACTGTC TCAGAGTGAG GTCAAGACAG CAGATCTGGA GAACAGCATG
    GACAGGTTTG AAGCCTGCAG CAGCAGCAGC AGCGAACAGA GTGACCCAGC TGCAGCTTCC
    CGAGACTCTG TCCAATGCTC CAGGGCCTTA CAGAGCTTGG TGGTGGAGCT AAAGACAGAA
    CTGAGCAAAC AGAGGACTGA GTATGAGACT AGTATCAAAA GAATTGAAGA AACAAGTGCA
    GACCTGAGGA ACCAAGTGGT TAGGTTAGAA GAAGAACTGG ATCAAGAACG AAAGAAATAC
    ACGATGCTGG AGATAAAGCT GAGGAATTCT GAACGCGCTC GTGAAGATGC TGAGAAGAGA
    AATTACCTCC TGCAAAAGGA AATGGAAGAA TTTTTTTCAA CATTAGGATG TTTAACTGTT
    GGGAGTCCAA GTGCTAAAGT CCCCAAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.