IMPG2 cDNA ORF clone, Corvus cornix cornix

The following IMPG2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the IMPG2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCo102122 XM_019283689.2
Latest version!
Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OCo102123 XM_019283690.2
Latest version!
Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OCo102124 XM_010396196.3
Latest version!
Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $797.30
$1139.00
OCo102125 XM_019283691.2
Latest version!
Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCo102122
    Clone ID Related Accession (Same CDS sequence) XM_019283689.2
    Accession Version XM_019283689.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4173bp)
    Protein sequence
    SNP
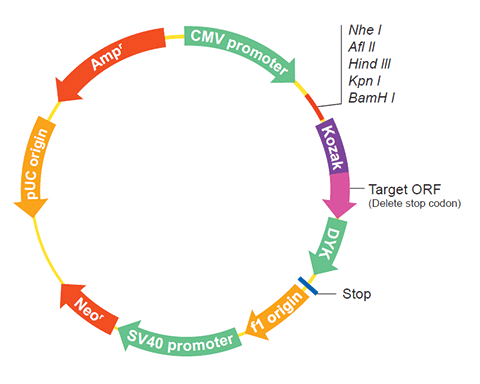
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
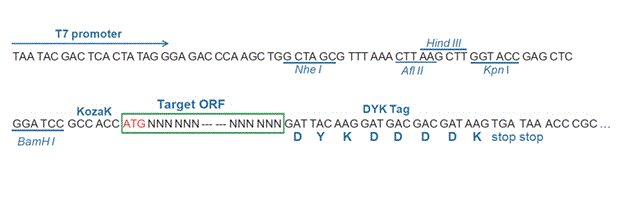
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product interphotoreceptor matrix proteoglycan 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018114014.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019283689.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGCCA AGATGATCCA GGGAATCACT CATGCAGTGG GACTCCTACT
    CCACCTTTGG ATGCTGACGT CACCACACTG AGAGATGCAG CTGCCAATGT TCCTCCCCCT
    CATGAGATCT CCGTTGAGAC TCCTGCAGGT GATACCATCC ATGAGCTTGA CAATGTAGTC
    CCTACTATCA ATAATGAGAT AAAGAAGCAG GACGAAAAGC TAGTCAGACC CGTAACAGAG
    CAGATGATTG AGTTCAACAT TTTGATTGTT GGTGAACAGT ACAGTGAGGA GCTGAAGGAT
    CCATCTGCTG CTGAGTATCA ACTGCTGTCT CAACGATTCA TTTCTCAGAT TAAAAGCGTG
    TTTGAAGGAC TACCTGGATA CAAAAACATC CATATCCTGG ATTACAGCCC TTCAGAGGAA
    GACAGTGGGG TGGAAGTTCA CTATGCTGTC ACATTTGATG GAAAAGCTAT GAGCAATGCC
    ACCTGGGACC TCATTAACCT TCATTCAAAC AAGGTGGAGG ACAACTCCTT TATGGGCATA
    GAGGATAATC CAACAGTTGT GTACACCATC AGTGATTTCC AAGATTATAT TGCTGAGATC
    CTCCAGAAGA ATGCTCTGCT TGAAAATGCT TCCATGATTT TAGACCCGAA ATCTCTCCAG
    CTTACTAACG TGAAAGAAAT ACTGCATCCC ACATCAGAAG TCCCGTCCTG GATTACTGAG
    AATCCAGTTG TGCTGGCGCG CCCGGAGTTT GATGACAGCA CCTTTTTAGC TGAACGTCCT
    TCTGCAGATG AATCAACTGT CAGCAATGCT TTGCCCTTTG ATTACACCAA ACCAGACTCC
    ACCTCAGACA GTGAGCAGTC TAGTGACAAT GAAATCCAGC CAAGACCAGA GAATATTGAC
    TATGAGGCCA GTTTGGCACC TGAAGCTCCA CTTTCCTCAG AGGCTGACAT CACTGCTTTG
    CCTGATGGGC TGAATTTAGA GACTTCTCGT TTAGTCACTG TACCAGTGTT AGAGCACGGT
    TCTATGGACT CTCAGGAATG GCTTTCAGCC CCCAGTTCTT CAGAAGATAC TGGATTATCT
    GAAGAACTTT TGCCTTTAAG TCCTTCTCAC CTTGTGCCTG AAGAATCTCC ATCTACCGAT
    GACTATGTAG TTCCTCTGCT TTCTGCACCA ACAGTGGCCT CTTCATCAGT TGTAGAGACT
    GATATTCAAG AGAAGGAAGA AGTAATCCAA GGTAGTCCTG AGGGCAGTGA CAGTGCAGAC
    TCTGTGGAAG AAATTCCTTT TCCCTTAGAA GTGCCCCCTA TGGAAGACGA AACTGATATA
    TTTCTTGGAG ATAGAGTTAT ATATGATGAT GGGTCTGGTT CAGCTTTTGA TGGTTCAGGA
    AAAGAAATGG AATCAAGTAT CTGGCCTTGG GAAGAAGCAA CCTTGGAACC AGTTTTCTAC
    CCTGGTCCTG ATAGCTGGCT TGAAGATGAC AATGACTCTT TGTTAATCAA AACTGAGGAT
    ATTCCTGAAG GCATGATTTT AGACTATATT CTTAACTCTG GGAATAAATT AGATTATGAT
    CTTTCCAAAG ATGAGAATGA AGGGATAGTC GATATAAAAG ATTTCCTTGA TGAATCTGAA
    ATATTTGTCT TTCCAGAGAC TACAACTCTG CAAGTACCTC TGTTACAGAC AGAAGAGCCA
    TCGTCTGTGG AACCATCTAC ACAGACAGAA ACCCTGGGCA TGTATGACTC TTCTTTTGTC
    ATGCCAGCTG GAGAGCCCCC TGTCTCACCA CCATATACAG ATCTGTCTGT GGAAGATAGT
    CTCGTTATAT CCACAGGGAC TGTCAGTATG GAGCAACCTG AGGAGTTTAG TGTAGGCCAG
    AACATAATCT CTGATGTAGT TGAACACCAA AGTGAAGACA GGGCAATGGC AGAAGAACTA
    TTCACAGTGA AGCAACCGGA TGTAATGGAA GCTGCTACGA TAGGACACTT GGACACAACC
    TCTTCAGGAA CTATTCTGAC TGCAGGTCCT TCCATGGTAA AGCCTGATGC TTCCACAGAA
    GAGCAGCAAG CCCTAGATTC ATCGCTGGCA GACCAAGACG CTCCTGGATC AGCAGTGAAG
    GAGCCAGCTG ATTTTTGGCC TACTGACAGG GCACTTGAGA CCTCCTTAGA TCAGACAGTG
    CAACCAGCAA TGCCAGCTGT TACTCAAGGT TCAGCTGAAG TTCCTTCTGT AACAGGTCAC
    ACCACTGTCC TAGAGGGCTT TGCTGTGCAG GATGGTACAG ACCATGACAC GCACATTTCC
    ATGAGCTTCA GCACTGTTAT GGATTATCAA ACAGTGAGTG TAACAACAAG CACCGTTGAG
    CTTCCATCCC ATCTCCCTCC TGTGGCATCC TCGCCATCAT TGTCTGTGGC TACCTCAACA
    AAGCTGGGAG ATGAAACAAC AAGAGTCCTG GATGTTTCAG TAGACCTGGA TGGTGTTAGC
    ACTGTCCACT TTTCTCCTGG GAGGACTGAG GAGGGAAGGA GAATGACGGA AAGTCACATG
    GAGCTAACAA CTCGTGTCCA GTCCACAGAG ATGGCCAGCG TGGCTTGGGC CACACATGAA
    ACTCACTATA GTAGCACAGT CCCGTCCCGA GCTCTAGTTG TGTTCTTCAG TCTTCGCGTT
    ACCAACATGA TGTTTTCAGA GGACCTGTTT AATAAAAACT CCCCTGAATA CAAAGCCTTG
    GAGCAGCGAT TCTTGGAACT GCTGGTGCCC TACCTTCAGT CAAATCTGAC GGGATTCCAG
    AATCTGGAAA TCCTGAACTT CAGAAATGGC AGCATTGTGG TGAACAGTCG AATGAAATTT
    GCCAAACCTG TGCCTCGGAA TGTCACCAAC GCTGTGTACA TGATCCTGGA AGATTTCTGC
    AACACTGCAT ATCACACCAT GAACCTGGCC ATTGATAAAT ACTCCCTGGA TGTGGAATCA
    GGTGAGCAAG CAGATCCGTG CAAGTTCCAG GCCTGCAATG AGTTCTCTGA GTGCTTAGTA
    AATCGCTGGA GTGGGGAAGC TGAGTGTGTC TGCAACCCTG GCTACCTCAG CATTGATGGG
    CTGCCATGCA ACAGCATTTG TGATCTGCAA CCAAACTTCT GCCTGAACGA TGGCAAGTGT
    GACATAAGCC CTGGGCAAGG GGCCATCTGT AGGTGCCGTG TGGGAGAGAA CTGGTGGTAC
    AGAGGGGAGC ACTGTGAGGA ATATGTGTCT GAGCCACTGG TTGTGGGTAT TGCGATTGCT
    TCTGTGGCAG GATTCCTTCT TGTGGCATCT GCTGTCATCT TCTTCTTGGC CAGGACCCTT
    CGAGACCAGT ACACAAAGAG TGATACTGGG GACTCACAGG GGCAGGGTGA CAGCCTCTCG
    TCCATTGAGA ACGCAGTTAA ATACAATCCC ATGTATGAAA GTGATACGAC TGGCTACAGC
    CATTATTACC GGAGATATCC GCAGCTAACG TCCTACAGTT CCACCAGTGC AGAGACATCC
    ACAGACTACA GCAGTGAAGA GATCAGGCAC ATTTATGAAA ACAGTGAGCT TACTAAGGAG
    GAAATTCAGG ACAGAATTCG AATTATAGAG CTCTACGCTA AAGACCGCCA GTTTGCAGAG
    TTTGTTAGGC AGCATCAAAT GAAGCTGCTT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019139234.2
    CDS274..4446
    Translation

    Target ORF information:

    RefSeq Version XM_019283689.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019283689.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGCCA AGATGATCCA GGGAATCACT CATGCAGTGG GACTCCTACT
    CCACCTTTGG ATGCTGACGT CACCACACTG AGAGATGCAG CTGCCAATGT TCCTCCCCCT
    CATGAGATCT CCGTTGAGAC TCCTGCAGGT GATACCATCC ATGAGCTTGA CAATGTAGTC
    CCTACTATCA ATAATGAGAT AAAGAAGCAG GACGAAAAGC TAGTCAGACC CGTAACAGAG
    CAGATGATTG AGTTCAACAT TTTGATTGTT GGTGAACAGT ACAGTGAGGA GCTGAAGGAT
    CCATCTGCTG CTGAGTATCA ACTGCTGTCT CAACGATTCA TTTCTCAGAT TAAAAGCGTG
    TTTGAAGGAC TACCTGGATA CAAAAACATC CATATCCTGG ATTACAGCCC TTCAGAGGAA
    GACAGTGGGG TGGAAGTTCA CTATGCTGTC ACATTTGATG GAAAAGCTAT GAGCAATGCC
    ACCTGGGACC TCATTAACCT TCATTCAAAC AAGGTGGAGG ACAACTCCTT TATGGGCATA
    GAGGATAATC CAACAGTTGT GTACACCATC AGTGATTTCC AAGATTATAT TGCTGAGATC
    CTCCAGAAGA ATGCTCTGCT TGAAAATGCT TCCATGATTT TAGACCCGAA ATCTCTCCAG
    CTTACTAACG TGAAAGAAAT ACTGCATCCC ACATCAGAAG TCCCGTCCTG GATTACTGAG
    AATCCAGTTG TGCTGGCGCG CCCGGAGTTT GATGACAGCA CCTTTTTAGC TGAACGTCCT
    TCTGCAGATG AATCAACTGT CAGCAATGCT TTGCCCTTTG ATTACACCAA ACCAGACTCC
    ACCTCAGACA GTGAGCAGTC TAGTGACAAT GAAATCCAGC CAAGACCAGA GAATATTGAC
    TATGAGGCCA GTTTGGCACC TGAAGCTCCA CTTTCCTCAG AGGCTGACAT CACTGCTTTG
    CCTGATGGGC TGAATTTAGA GACTTCTCGT TTAGTCACTG TACCAGTGTT AGAGCACGGT
    TCTATGGACT CTCAGGAATG GCTTTCAGCC CCCAGTTCTT CAGAAGATAC TGGATTATCT
    GAAGAACTTT TGCCTTTAAG TCCTTCTCAC CTTGTGCCTG AAGAATCTCC ATCTACCGAT
    GACTATGTAG TTCCTCTGCT TTCTGCACCA ACAGTGGCCT CTTCATCAGT TGTAGAGACT
    GATATTCAAG AGAAGGAAGA AGTAATCCAA GGTAGTCCTG AGGGCAGTGA CAGTGCAGAC
    TCTGTGGAAG AAATTCCTTT TCCCTTAGAA GTGCCCCCTA TGGAAGACGA AACTGATATA
    TTTCTTGGAG ATAGAGTTAT ATATGATGAT GGGTCTGGTT CAGCTTTTGA TGGTTCAGGA
    AAAGAAATGG AATCAAGTAT CTGGCCTTGG GAAGAAGCAA CCTTGGAACC AGTTTTCTAC
    CCTGGTCCTG ATAGCTGGCT TGAAGATGAC AATGACTCTT TGTTAATCAA AACTGAGGAT
    ATTCCTGAAG GCATGATTTT AGACTATATT CTTAACTCTG GGAATAAATT AGATTATGAT
    CTTTCCAAAG ATGAGAATGA AGGGATAGTC GATATAAAAG ATTTCCTTGA TGAATCTGAA
    ATATTTGTCT TTCCAGAGAC TACAACTCTG CAAGTACCTC TGTTACAGAC AGAAGAGCCA
    TCGTCTGTGG AACCATCTAC ACAGACAGAA ACCCTGGGCA TGTATGACTC TTCTTTTGTC
    ATGCCAGCTG GAGAGCCCCC TGTCTCACCA CCATATACAG ATCTGTCTGT GGAAGATAGT
    CTCGTTATAT CCACAGGGAC TGTCAGTATG GAGCAACCTG AGGAGTTTAG TGTAGGCCAG
    AACATAATCT CTGATGTAGT TGAACACCAA AGTGAAGACA GGGCAATGGC AGAAGAACTA
    TTCACAGTGA AGCAACCGGA TGTAATGGAA GCTGCTACGA TAGGACACTT GGACACAACC
    TCTTCAGGAA CTATTCTGAC TGCAGGTCCT TCCATGGTAA AGCCTGATGC TTCCACAGAA
    GAGCAGCAAG CCCTAGATTC ATCGCTGGCA GACCAAGACG CTCCTGGATC AGCAGTGAAG
    GAGCCAGCTG ATTTTTGGCC TACTGACAGG GCACTTGAGA CCTCCTTAGA TCAGACAGTG
    CAACCAGCAA TGCCAGCTGT TACTCAAGGT TCAGCTGAAG TTCCTTCTGT AACAGGTCAC
    ACCACTGTCC TAGAGGGCTT TGCTGTGCAG GATGGTACAG ACCATGACAC GCACATTTCC
    ATGAGCTTCA GCACTGTTAT GGATTATCAA ACAGTGAGTG TAACAACAAG CACCGTTGAG
    CTTCCATCCC ATCTCCCTCC TGTGGCATCC TCGCCATCAT TGTCTGTGGC TACCTCAACA
    AAGCTGGGAG ATGAAACAAC AAGAGTCCTG GATGTTTCAG TAGACCTGGA TGGTGTTAGC
    ACTGTCCACT TTTCTCCTGG GAGGACTGAG GAGGGAAGGA GAATGACGGA AAGTCACATG
    GAGCTAACAA CTCGTGTCCA GTCCACAGAG ATGGCCAGCG TGGCTTGGGC CACACATGAA
    ACTCACTATA GTAGCACAGT CCCGTCCCGA GCTCTAGTTG TGTTCTTCAG TCTTCGCGTT
    ACCAACATGA TGTTTTCAGA GGACCTGTTT AATAAAAACT CCCCTGAATA CAAAGCCTTG
    GAGCAGCGAT TCTTGGAACT GCTGGTGCCC TACCTTCAGT CAAATCTGAC GGGATTCCAG
    AATCTGGAAA TCCTGAACTT CAGAAATGGC AGCATTGTGG TGAACAGTCG AATGAAATTT
    GCCAAACCTG TGCCTCGGAA TGTCACCAAC GCTGTGTACA TGATCCTGGA AGATTTCTGC
    AACACTGCAT ATCACACCAT GAACCTGGCC ATTGATAAAT ACTCCCTGGA TGTGGAATCA
    GGTGAGCAAG CAGATCCGTG CAAGTTCCAG GCCTGCAATG AGTTCTCTGA GTGCTTAGTA
    AATCGCTGGA GTGGGGAAGC TGAGTGTGTC TGCAACCCTG GCTACCTCAG CATTGATGGG
    CTGCCATGCA ACAGCATTTG TGATCTGCAA CCAAACTTCT GCCTGAACGA TGGCAAGTGT
    GACATAAGCC CTGGGCAAGG GGCCATCTGT AGGTGCCGTG TGGGAGAGAA CTGGTGGTAC
    AGAGGGGAGC ACTGTGAGGA ATATGTGTCT GAGCCACTGG TTGTGGGTAT TGCGATTGCT
    TCTGTGGCAG GATTCCTTCT TGTGGCATCT GCTGTCATCT TCTTCTTGGC CAGGACCCTT
    CGAGACCAGT ACACAAAGAG TGATACTGGG GACTCACAGG GGCAGGGTGA CAGCCTCTCG
    TCCATTGAGA ACGCAGTTAA ATACAATCCC ATGTATGAAA GTGATACGAC TGGCTACAGC
    CATTATTACC GGAGATATCC GCAGCTAACG TCCTACAGTT CCACCAGTGC AGAGACATCC
    ACAGACTACA GCAGTGAAGA GATCAGGCAC ATTTATGAAA ACAGTGAGCT TACTAAGGAG
    GAAATTCAGG ACAGAATTCG AATTATAGAG CTCTACGCTA AAGACCGCCA GTTTGCAGAG
    TTTGTTAGGC AGCATCAAAT GAAGCTGCTT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo102123
    Clone ID Related Accession (Same CDS sequence) XM_019283690.2
    Accession Version XM_019283690.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4170bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product interphotoreceptor matrix proteoglycan 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018114014.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019283690.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGAAGCTTA TTCAGCTGCA GAAGGAGGAC AGGCTGAAGA AGTTTCACCA
    GCCCCTCAGC TCAGTGACTG GCAGCTGGCA AACCCTTCTC TGCCTCCTGG GTTGAAAAAG
    CCTAACAGCA TCATGGATGC TGAGCAGTTC CACAGGCATT TGCAGTTACG AAGGAAGCGG
    TCCATTCTGT TCCCCAGTGG AGTTAAGATC TGCCCTGATG AATCTGTTGA GCAGGCTATT
    GCCAACCATC TGAAGTATTT CAGGCTCAGA GTGTGCCAGG AAACAGTCTG GGAGGTCTTC
    AAGACATTCT GGGACAGACT GCCGGAGCGT GAAGAGTATA ATGCCTGGAT GAGCCTGTGT
    GAGGAAGGAA TAATGAGCAT CTTTGAAATG GGCACCAACT TCAGTCAGTC TGAGGAGCAC
    CGGAGCCTGA TCATGAAGAA ACTGTCCTAT ACAAAGGAAG CAATGGGGAG TTCCTGCACT
    GATTGGTCAT GTGGCCAAGA TGATCCAGGG AATCACTCAT GCAGTGGGAC TCCTACTCCA
    CCTTTGGATG CTGACGTCAC CACACTGAGA GATGCAGCTG CCAATGTTCC TCCCCCTCAT
    GAGATCTCCG TTGAGACTCC TGCAGGTGAT ACCATCCATG AGCTTGACAA TGTAGTCCCT
    ACTATCAATA ATGAGATAAA GAAGCAGGAC GAAAAGCTAG TCAGACCCGT AACAGAGCAG
    ATGATTGAGT TCAACATTTT GATTGTTGGT GAACAGTACA GTGAGGAGCT GAAGGATCCA
    TCTGCTGCTG AGTATCAACT GCTGTCTCAA CGATTCATTT CTCAGATTAA AAGCGTGTTT
    GAAGGACTAC CTGGATACAA AAACATCCAT ATCCTGGATT ACAGCCCTTC AGAGGAAGAC
    AGTGGGGTGG AAGTTCACTA TGCTGTCACA TTTGATGGAA AAGCTATGAG CAATGCCACC
    TGGGACCTCA TTAACCTTCA TTCAAACAAG GTGGAGGACA ACTCCTTTAT GGGCATAGAG
    GATAATCCAA CAGTTGTGTA CACCATCAGT GATTTCCAAG ATTATATTGC TGAGATCCTC
    CAGAAGAATG CTCTGCTTGA AAATGCTTCC ATGATTTTAG ACCCGAAATC TCTCCAGCTT
    ACTAACGTGA AAGAAATACT GCATCCCACA TCAGAAGTCC CGTCCTGGAT TACTGAGAAT
    CCAGTTGTGC TGGCGCGCCC GGAGTTTGAT GACAGCACCT TTTTAGCTGA ACGTCCTTCT
    GCAGATGAAT CAACTGTCAG CAATGCTTTG CCCTTTGATT ACACCAAACC AGACTCCACC
    TCAGACAGTG AGCAGTCTAG TGACAATGAA ATCCAGCCAA GACCAGAGAA TATTGACTAT
    GAGGCCAGTT TGGCACCTGA AGCTCCACTT TCCTCAGAGG CTGACATCAC TGCTTTGCCT
    GATGGGCTGA ATTTAGAGAC TTCTCGTTTA GTCACTGTAC CAGTGTTAGA GCACGGTTCT
    ATGGACTCTC AGGAATGGCT TTCAGCCCCC AGTTCTTCAG AAGATACTGG ATTATCTGAA
    GAACTTTTGC CTTTAAGTCC TTCTCACCTT GTGCCTGAAG AATCTCCATC TACCGATGAC
    TATGTAGTTC CTCTGCTTTC TGCACCAACA GTGGCCTCTT CATCAGTTGT AGAGACTGAT
    ATTCAAGAGA AGGAAGAAGT AATCCAAGGT AGTCCTGAGG GCAGTGACAG TGCAGACTCT
    GTGGAAGAAA TTCCTTTTCC CTTAGAAGTG CCCCCTATGG AAGACGAAAC TGATATATTT
    CTTGGAGATA GAGTTATATA TGATGATGGG TCTGGTTCAG CTTTTGATGG TTCAGGAAAA
    GAAATGGAAT CAAGTATCTG GCCTTGGGAA GAAGCAACCT TGGAACCAGT TTTCTACCCT
    GGTCCTGATA GCTGGCTTGA AGATGACAAT GACTCTTTGT TAATCAAAAC TGAGGATATT
    CCTGAAGGCA TGATTTTAGA CTATATTCTT AACTCTGGGA ATAAATTAGA TTATGATCTT
    TCCAAAGATG AGAATGAAGG GATAGTCGAT ATAAAAGATT TCCTTGATGA ATCTGAAATA
    TTTGTCTTTC CAGAGACTAC AACTCTGCAA GTACCTCTGT TACAGACAGA AGAGCCATCG
    TCTGTGGAAC CATCTACACA GACAGAAACC CTGGGCATGT ATGACTCTTC TTTTGTCATG
    CCAGCTGGAG AGCCCCCTGT CTCACCACCA TATACAGATC TGTCTGTGGA AGATAGTCTC
    GTTATATCCA CAGGGACTGT CAGTATGGAG CAACCTGAGG AGTTTAGTGT AGGCCAGAAC
    ATAATCTCTG ATGTAGTTGA ACACCAAAGT GAAGACAGGG CAATGGCAGA AGAACTATTC
    ACAGTGAAGC AACCGGATGT AATGGAAGCT GCTACGATAG GACACTTGGA CACAACCTCT
    TCAGGAACTA TTCTGACTGC AGGTCCTTCC ATGGTAAAGC CTGATGCTTC CACAGAAGAG
    CAGCAAGCCC TAGATTCATC GCTGGCAGAC CAAGACGCTC CTGGATCAGC AGTGAAGGAG
    CCAGCTGATT TTTGGCCTAC TGACAGGGCA CTTGAGACCT CCTTAGATCA GACAGTGCAA
    CCAGCAATGC CAGCTGTTAC TCAAGGTTCA GCTGAAGTTC CTTCTGTAAC AGGTCACACC
    ACTGTCCTAG AGGGCTTTGC TGTGCAGGAT GGTACAGACC ATGACACGCA CATTTCCATG
    AGCTTCAGCA CTGTTATGGA TTATCAAACA GTGAGTGTAA CAACAAGCAC CGTTGAGCTT
    CCATCCCATC TCCCTCCTGT GGCATCCTCG CCATCATTGT CTGTGGCTAC CTCAACAAAG
    CTGGGAGATG AAACAACAAG AGTCCTGGAT GTTTCAGTAG ACCTGGATGG TGTTAGCACT
    GTCCACTTTT CTCCTGGGAG GACTGAGGAG GGAAGGAGAA TGACGGAAAG TCACATGGAG
    CTAACAACTC GTGTCCAGTC CACAGAGATG GCCAGCGTGG CTTGGGCCAC ACATGAAACT
    CACTATAGTA GCACAGTCCC GTCCCGAGCT CTAGTTGTGT TCTTCAGTCT TCGCGTTACC
    AACATGATGT TTTCAGAGGA CCTGTTTAAT AAAAACTCCC CTGAATACAA AGCCTTGGAG
    CAGCGATTCT TGGAACTGCT GGTGCCCTAC CTTCAGTCAA ATCTGACGGG ATTCCAGAAT
    CTGGAAATCC TGAACTTCAG AAATGGCAGC ATTGTGGTGA ACAGTCGAAT GAAATTTGCC
    AAACCTGTGC CTCGGAATGT CACCAACGCT GTGTACATGA TCCTGGAAGA TTTCTGCAAC
    ACTGCATATC ACACCATGAA CCTGGCCATT GATAAATACT CCCTGGATGT GGAATCAGGT
    GAGCAAGCAG ATCCGTGCAA GTTCCAGGCC TGCAATGAGT TCTCTGAGTG CTTAGTAAAT
    CGCTGGAGTG GGGAAGCTGA GTGTGTCTGC AACCCTGGCT ACCTCAGCAT TGATGGGCTG
    CCATGCAACA GCATTTGTGA TCTGCAACCA AACTTCTGCC TGAACGATGG CAAGTGTGAC
    ATAAGCCCTG GGCAAGGGGC CATCTGTAGG TGCCGTGTGG GAGAGAACTG GTGGTACAGA
    GGGGAGCACT GTGAGGAATA TGTGTCTGAG CCACTGGTTG TGGGTATTGC GATTGCTTCT
    GTGGCAGGAT TCCTTCTTGT GGCATCTGCT GTCATCTTCT TCTTGGCCAG GACCCTTCGA
    GACCAGTACA CAAAGAGTGA TACTGGGGAC TCACAGGGGC AGGGTGACAG CCTCTCGTCC
    ATTGAGAACG CAGTTAAATA CAATCCCATG TATGAAAGTG ATACGACTGG CTACAGCCAT
    TATTACCGGA GATATCCGCA GCTAACGTCC TACAGTTCCA CCAGTGCAGA GACATCCACA
    GACTACAGCA GTGAAGAGAT CAGGCACATT TATGAAAACA GTGAGCTTAC TAAGGAGGAA
    ATTCAGGACA GAATTCGAAT TATAGAGCTC TACGCTAAAG ACCGCCAGTT TGCAGAGTTT
    GTTAGGCAGC ATCAAATGAA GCTGCTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019139235.2
    CDS274..4443
    Translation

    Target ORF information:

    RefSeq Version XM_019283690.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019283690.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGAAGCTTA TTCAGCTGCA GAAGGAGGAC AGGCTGAAGA AGTTTCACCA
    GCCCCTCAGC TCAGTGACTG GCAGCTGGCA AACCCTTCTC TGCCTCCTGG GTTGAAAAAG
    CCTAACAGCA TCATGGATGC TGAGCAGTTC CACAGGCATT TGCAGTTACG AAGGAAGCGG
    TCCATTCTGT TCCCCAGTGG AGTTAAGATC TGCCCTGATG AATCTGTTGA GCAGGCTATT
    GCCAACCATC TGAAGTATTT CAGGCTCAGA GTGTGCCAGG AAACAGTCTG GGAGGTCTTC
    AAGACATTCT GGGACAGACT GCCGGAGCGT GAAGAGTATA ATGCCTGGAT GAGCCTGTGT
    GAGGAAGGAA TAATGAGCAT CTTTGAAATG GGCACCAACT TCAGTCAGTC TGAGGAGCAC
    CGGAGCCTGA TCATGAAGAA ACTGTCCTAT ACAAAGGAAG CAATGGGGAG TTCCTGCACT
    GATTGGTCAT GTGGCCAAGA TGATCCAGGG AATCACTCAT GCAGTGGGAC TCCTACTCCA
    CCTTTGGATG CTGACGTCAC CACACTGAGA GATGCAGCTG CCAATGTTCC TCCCCCTCAT
    GAGATCTCCG TTGAGACTCC TGCAGGTGAT ACCATCCATG AGCTTGACAA TGTAGTCCCT
    ACTATCAATA ATGAGATAAA GAAGCAGGAC GAAAAGCTAG TCAGACCCGT AACAGAGCAG
    ATGATTGAGT TCAACATTTT GATTGTTGGT GAACAGTACA GTGAGGAGCT GAAGGATCCA
    TCTGCTGCTG AGTATCAACT GCTGTCTCAA CGATTCATTT CTCAGATTAA AAGCGTGTTT
    GAAGGACTAC CTGGATACAA AAACATCCAT ATCCTGGATT ACAGCCCTTC AGAGGAAGAC
    AGTGGGGTGG AAGTTCACTA TGCTGTCACA TTTGATGGAA AAGCTATGAG CAATGCCACC
    TGGGACCTCA TTAACCTTCA TTCAAACAAG GTGGAGGACA ACTCCTTTAT GGGCATAGAG
    GATAATCCAA CAGTTGTGTA CACCATCAGT GATTTCCAAG ATTATATTGC TGAGATCCTC
    CAGAAGAATG CTCTGCTTGA AAATGCTTCC ATGATTTTAG ACCCGAAATC TCTCCAGCTT
    ACTAACGTGA AAGAAATACT GCATCCCACA TCAGAAGTCC CGTCCTGGAT TACTGAGAAT
    CCAGTTGTGC TGGCGCGCCC GGAGTTTGAT GACAGCACCT TTTTAGCTGA ACGTCCTTCT
    GCAGATGAAT CAACTGTCAG CAATGCTTTG CCCTTTGATT ACACCAAACC AGACTCCACC
    TCAGACAGTG AGCAGTCTAG TGACAATGAA ATCCAGCCAA GACCAGAGAA TATTGACTAT
    GAGGCCAGTT TGGCACCTGA AGCTCCACTT TCCTCAGAGG CTGACATCAC TGCTTTGCCT
    GATGGGCTGA ATTTAGAGAC TTCTCGTTTA GTCACTGTAC CAGTGTTAGA GCACGGTTCT
    ATGGACTCTC AGGAATGGCT TTCAGCCCCC AGTTCTTCAG AAGATACTGG ATTATCTGAA
    GAACTTTTGC CTTTAAGTCC TTCTCACCTT GTGCCTGAAG AATCTCCATC TACCGATGAC
    TATGTAGTTC CTCTGCTTTC TGCACCAACA GTGGCCTCTT CATCAGTTGT AGAGACTGAT
    ATTCAAGAGA AGGAAGAAGT AATCCAAGGT AGTCCTGAGG GCAGTGACAG TGCAGACTCT
    GTGGAAGAAA TTCCTTTTCC CTTAGAAGTG CCCCCTATGG AAGACGAAAC TGATATATTT
    CTTGGAGATA GAGTTATATA TGATGATGGG TCTGGTTCAG CTTTTGATGG TTCAGGAAAA
    GAAATGGAAT CAAGTATCTG GCCTTGGGAA GAAGCAACCT TGGAACCAGT TTTCTACCCT
    GGTCCTGATA GCTGGCTTGA AGATGACAAT GACTCTTTGT TAATCAAAAC TGAGGATATT
    CCTGAAGGCA TGATTTTAGA CTATATTCTT AACTCTGGGA ATAAATTAGA TTATGATCTT
    TCCAAAGATG AGAATGAAGG GATAGTCGAT ATAAAAGATT TCCTTGATGA ATCTGAAATA
    TTTGTCTTTC CAGAGACTAC AACTCTGCAA GTACCTCTGT TACAGACAGA AGAGCCATCG
    TCTGTGGAAC CATCTACACA GACAGAAACC CTGGGCATGT ATGACTCTTC TTTTGTCATG
    CCAGCTGGAG AGCCCCCTGT CTCACCACCA TATACAGATC TGTCTGTGGA AGATAGTCTC
    GTTATATCCA CAGGGACTGT CAGTATGGAG CAACCTGAGG AGTTTAGTGT AGGCCAGAAC
    ATAATCTCTG ATGTAGTTGA ACACCAAAGT GAAGACAGGG CAATGGCAGA AGAACTATTC
    ACAGTGAAGC AACCGGATGT AATGGAAGCT GCTACGATAG GACACTTGGA CACAACCTCT
    TCAGGAACTA TTCTGACTGC AGGTCCTTCC ATGGTAAAGC CTGATGCTTC CACAGAAGAG
    CAGCAAGCCC TAGATTCATC GCTGGCAGAC CAAGACGCTC CTGGATCAGC AGTGAAGGAG
    CCAGCTGATT TTTGGCCTAC TGACAGGGCA CTTGAGACCT CCTTAGATCA GACAGTGCAA
    CCAGCAATGC CAGCTGTTAC TCAAGGTTCA GCTGAAGTTC CTTCTGTAAC AGGTCACACC
    ACTGTCCTAG AGGGCTTTGC TGTGCAGGAT GGTACAGACC ATGACACGCA CATTTCCATG
    AGCTTCAGCA CTGTTATGGA TTATCAAACA GTGAGTGTAA CAACAAGCAC CGTTGAGCTT
    CCATCCCATC TCCCTCCTGT GGCATCCTCG CCATCATTGT CTGTGGCTAC CTCAACAAAG
    CTGGGAGATG AAACAACAAG AGTCCTGGAT GTTTCAGTAG ACCTGGATGG TGTTAGCACT
    GTCCACTTTT CTCCTGGGAG GACTGAGGAG GGAAGGAGAA TGACGGAAAG TCACATGGAG
    CTAACAACTC GTGTCCAGTC CACAGAGATG GCCAGCGTGG CTTGGGCCAC ACATGAAACT
    CACTATAGTA GCACAGTCCC GTCCCGAGCT CTAGTTGTGT TCTTCAGTCT TCGCGTTACC
    AACATGATGT TTTCAGAGGA CCTGTTTAAT AAAAACTCCC CTGAATACAA AGCCTTGGAG
    CAGCGATTCT TGGAACTGCT GGTGCCCTAC CTTCAGTCAA ATCTGACGGG ATTCCAGAAT
    CTGGAAATCC TGAACTTCAG AAATGGCAGC ATTGTGGTGA ACAGTCGAAT GAAATTTGCC
    AAACCTGTGC CTCGGAATGT CACCAACGCT GTGTACATGA TCCTGGAAGA TTTCTGCAAC
    ACTGCATATC ACACCATGAA CCTGGCCATT GATAAATACT CCCTGGATGT GGAATCAGGT
    GAGCAAGCAG ATCCGTGCAA GTTCCAGGCC TGCAATGAGT TCTCTGAGTG CTTAGTAAAT
    CGCTGGAGTG GGGAAGCTGA GTGTGTCTGC AACCCTGGCT ACCTCAGCAT TGATGGGCTG
    CCATGCAACA GCATTTGTGA TCTGCAACCA AACTTCTGCC TGAACGATGG CAAGTGTGAC
    ATAAGCCCTG GGCAAGGGGC CATCTGTAGG TGCCGTGTGG GAGAGAACTG GTGGTACAGA
    GGGGAGCACT GTGAGGAATA TGTGTCTGAG CCACTGGTTG TGGGTATTGC GATTGCTTCT
    GTGGCAGGAT TCCTTCTTGT GGCATCTGCT GTCATCTTCT TCTTGGCCAG GACCCTTCGA
    GACCAGTACA CAAAGAGTGA TACTGGGGAC TCACAGGGGC AGGGTGACAG CCTCTCGTCC
    ATTGAGAACG CAGTTAAATA CAATCCCATG TATGAAAGTG ATACGACTGG CTACAGCCAT
    TATTACCGGA GATATCCGCA GCTAACGTCC TACAGTTCCA CCAGTGCAGA GACATCCACA
    GACTACAGCA GTGAAGAGAT CAGGCACATT TATGAAAACA GTGAGCTTAC TAAGGAGGAA
    ATTCAGGACA GAATTCGAAT TATAGAGCTC TACGCTAAAG ACCGCCAGTT TGCAGAGTTT
    GTTAGGCAGC ATCAAATGAA GCTGCTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo102124
    Clone ID Related Accession (Same CDS sequence) XM_010396196.3
    Accession Version XM_010396196.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 4143bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product interphotoreceptor matrix proteoglycan 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018114014.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_010396196.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGTGG GACTCCTACT CCACCTTTGG ATGCTGACGT CACCACACTG
    AGAGATGCAG CTGCCAATGT TCCTCCCCCT CATGAGATCT CCGTTGAGAC TCCTGCAGGT
    GATACCATCC ATGAGCTTGA CAATGTAGTC CCTACTATCA ATAATGAGAT AAAGAAGCAG
    GACGAAAAGC TAGTCAGACC CGTAACAGAG CAGATGATTG AGTTCAACAT TTTGATTGTT
    GGTGAACAGT ACAGTGAGGA GCTGAAGGAT CCATCTGCTG CTGAGTATCA ACTGCTGTCT
    CAACGATTCA TTTCTCAGAT TAAAAGCGTG TTTGAAGGAC TACCTGGATA CAAAAACATC
    CATATCCTGG ATTACAGCCC TTCAGAGGAA GACAGTGGGG TGGAAGTTCA CTATGCTGTC
    ACATTTGATG GAAAAGCTAT GAGCAATGCC ACCTGGGACC TCATTAACCT TCATTCAAAC
    AAGGTGGAGG ACAACTCCTT TATGGGCATA GAGGATAATC CAACAGTTGT GTACACCATC
    AGTGATTTCC AAGATTATAT TGCTGAGATC CTCCAGAAGA ATGCTCTGCT TGAAAATGCT
    TCCATGATTT TAGACCCGAA ATCTCTCCAG CTTACTAACG TGAAAGAAAT ACTGCATCCC
    ACATCAGAAG TCCCGTCCTG GATTACTGAG AATCCAGTTG TGCTGGCGCG CCCGGAGTTT
    GATGACAGCA CCTTTTTAGC TGAACGTCCT TCTGCAGATG AATCAACTGT CAGCAATGCT
    TTGCCCTTTG ATTACACCAA ACCAGACTCC ACCTCAGACA GTGAGCAGTC TAGTGACAAT
    GAAATCCAGC CAAGACCAGA GAATATTGAC TATGAGGCCA GTTTGGCACC TGAAGCTCCA
    CTTTCCTCAG AGGCTGACAT CACTGCTTTG CCTGATGGGC TGAATTTAGA GACTTCTCGT
    TTAGTCACTG TACCAGTGTT AGAGCACGGT TCTATGGACT CTCAGGAATG GCTTTCAGCC
    CCCAGTTCTT CAGAAGATAC TGGATTATCT GAAGAACTTT TGCCTTTAAG TCCTTCTCAC
    CTTGTGCCTG AAGAATCTCC ATCTACCGAT GACTATGTAG TTCCTCTGCT TTCTGCACCA
    ACAGTGGCCT CTTCATCAGT TGTAGAGACT GATATTCAAG AGAAGGAAGA AGTAATCCAA
    GGTAGTCCTG AGGGCAGTGA CAGTGCAGAC TCTGTGGAAG AAATTCCTTT TCCCTTAGAA
    GTGCCCCCTA TGGAAGACGA AACTGATATA TTTCTTGGAG ATAGAGTTAT ATATGATGAT
    GGGTCTGGTT CAGCTTTTGA TGGTTCAGGA AAAGAAATGG AATCAAGTAT CTGGCCTTGG
    GAAGAAGCAA CCTTGGAACC AGTTTTCTAC CCTGGTCCTG ATAGCTGGCT TGAAGATGAC
    AATGACTCTT TGTTAATCAA AACTGAGGAT ATTCCTGAAG GCATGATTTT AGACTATATT
    CTTAACTCTG GGAATAAATT AGATTATGAT CTTTCCAAAG ATGAGAATGA AGGGATAGTC
    GATATAAAAG ATTTCCTTGA TGAATCTGAA ATATTTGTCT TTCCAGAGAC TACAACTCTG
    CAAGTACCTC TGTTACAGAC AGAAGAGCCA TCGTCTGTGG AACCATCTAC ACAGACAGAA
    ACCCTGGGCA TGTATGACTC TTCTTTTGTC ATGCCAGCTG GAGAGCCCCC TGTCTCACCA
    CCATATACAG ATCTGTCTGT GGAAGATAGT CTCGTTATAT CCACAGGGAC TGTCAGTATG
    GAGCAACCTG AGGAGTTTAG TGTAGGCCAG AACATAATCT CTGATGTAGT TGAACACCAA
    AGTGAAGACA GGGCAATGGC AGAAGAACTA TTCACAGTGA AGCAACCGGA TGTAATGGAA
    GCTGCTACGA TAGGACACTT GGACACAACC TCTTCAGGAA CTATTCTGAC TGCAGGTCCT
    TCCATGGTAA AGCCTGATGC TTCCACAGAA GAGCAGCAAG CCCTAGATTC ATCGCTGGCA
    GACCAAGACG CTCCTGGATC AGCAGTGAAG GAGCCAGCTG ATTTTTGGCC TACTGACAGG
    GCACTTGAGA CCTCCTTAGA TCAGACAGTG CAACCAGCAA TGCCAGCTGT TACTCAAGGT
    TCAGCTGAAG TTCCTTCTGT AACAGGTCAC ACCACTGTCC TAGAGGGCTT TGCTGTGCAG
    GATGGTACAG ACCATGACAC GCACATTTCC ATGAGCTTCA GCACTGTTAT GGATTATCAA
    ACAGTGAGTG TAACAACAAG CACCGTTGAG CTTCCATCCC ATCTCCCTCC TGTGGCATCC
    TCGCCATCAT TGTCTGTGGC TACCTCAACA AAGCTGGGAG ATGAAACAAC AAGAGTCCTG
    GATGTTTCAG TAGACCTGGA TGGTGTTAGC ACTGTCCACT TTTCTCCTGG GAGGACTGAG
    GAGGGAAGGA GAATGACGGA AAGTCACATG GAGCTAACAA CTCGTGTCCA GTCCACAGAG
    ATGGCCAGCG TGGCTTGGGC CACACATGAA ACTCACTATA GTAGCACAGT CCCGTCCCGA
    GCTCTAGTTG TGTTCTTCAG TCTTCGCGTT ACCAACATGA TGTTTTCAGA GGACCTGTTT
    AATAAAAACT CCCCTGAATA CAAAGCCTTG GAGCAGCGAT TCTTGGAACT GCTGGTGCCC
    TACCTTCAGT CAAATCTGAC GGGATTCCAG AATCTGGAAA TCCTGAACTT CAGAAATGGC
    AGCATTGTGG TGAACAGTCG AATGAAATTT GCCAAACCTG TGCCTCGGAA TGTCACCAAC
    GCTGTGTACA TGATCCTGGA AGATTTCTGC AACACTGCAT ATCACACCAT GAACCTGGCC
    ATTGATAAAT ACTCCCTGGA TGTGGAATCA GGTGAGCAAG CAGATCCGTG CAAGTTCCAG
    GCCTGCAATG AGTTCTCTGA GTGCTTAGTA AATCGCTGGA GTGGGGAAGC TGAGTGTGTC
    TGCAACCCTG GCTACCTCAG CATTGATGGG CTGCCATGCA ACAGCATTTG TGATCTGCAA
    CCAAACTTCT GCCTGAACGA TGGCAAGTGT GACATAAGCC CTGGGCAAGG GGCCATCTGT
    AGGTGCCGTG TGGGAGAGAA CTGGTGGTAC AGAGGGGAGC ACTGTGAGGA ATATGTGTCT
    GAGCCACTGG TTGTGGGTAT TGCGATTGCT TCTGTGGCAG GATTCCTTCT TGTGGCATCT
    GCTGTCATCT TCTTCTTGGC CAGGACCCTT CGAGACCAGT ACACAAAGAG TGATACTGGG
    GACTCACAGG GGCAGGGTGA CAGCCTCTCG TCCATTGAGA ACGCAGTTAA ATACAATCCC
    ATGTATGAAA GTGATACGAC TGGCTACAGC CATTATTACC GGAGATATCC GCAGCTAACG
    TCCTACAGTT CCACCAGTGC AGAGACATCC ACAGACTACA GCAGTGAAGA GATCAGGCAC
    ATTTATGAAA ACAGTGAGCT TACTAAGGAG GAAATTCAGG ACAGAATTCG AATTATAGAG
    CTCTACGCTA AAGACCGCCA GTTTGCAGAG TTTGTTAGGC AGCATCAAAT GAAGCTGCTT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_010394498.3
    CDS274..4416
    Translation

    Target ORF information:

    RefSeq Version XM_010396196.3
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010396196.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGTGG GACTCCTACT CCACCTTTGG ATGCTGACGT CACCACACTG
    AGAGATGCAG CTGCCAATGT TCCTCCCCCT CATGAGATCT CCGTTGAGAC TCCTGCAGGT
    GATACCATCC ATGAGCTTGA CAATGTAGTC CCTACTATCA ATAATGAGAT AAAGAAGCAG
    GACGAAAAGC TAGTCAGACC CGTAACAGAG CAGATGATTG AGTTCAACAT TTTGATTGTT
    GGTGAACAGT ACAGTGAGGA GCTGAAGGAT CCATCTGCTG CTGAGTATCA ACTGCTGTCT
    CAACGATTCA TTTCTCAGAT TAAAAGCGTG TTTGAAGGAC TACCTGGATA CAAAAACATC
    CATATCCTGG ATTACAGCCC TTCAGAGGAA GACAGTGGGG TGGAAGTTCA CTATGCTGTC
    ACATTTGATG GAAAAGCTAT GAGCAATGCC ACCTGGGACC TCATTAACCT TCATTCAAAC
    AAGGTGGAGG ACAACTCCTT TATGGGCATA GAGGATAATC CAACAGTTGT GTACACCATC
    AGTGATTTCC AAGATTATAT TGCTGAGATC CTCCAGAAGA ATGCTCTGCT TGAAAATGCT
    TCCATGATTT TAGACCCGAA ATCTCTCCAG CTTACTAACG TGAAAGAAAT ACTGCATCCC
    ACATCAGAAG TCCCGTCCTG GATTACTGAG AATCCAGTTG TGCTGGCGCG CCCGGAGTTT
    GATGACAGCA CCTTTTTAGC TGAACGTCCT TCTGCAGATG AATCAACTGT CAGCAATGCT
    TTGCCCTTTG ATTACACCAA ACCAGACTCC ACCTCAGACA GTGAGCAGTC TAGTGACAAT
    GAAATCCAGC CAAGACCAGA GAATATTGAC TATGAGGCCA GTTTGGCACC TGAAGCTCCA
    CTTTCCTCAG AGGCTGACAT CACTGCTTTG CCTGATGGGC TGAATTTAGA GACTTCTCGT
    TTAGTCACTG TACCAGTGTT AGAGCACGGT TCTATGGACT CTCAGGAATG GCTTTCAGCC
    CCCAGTTCTT CAGAAGATAC TGGATTATCT GAAGAACTTT TGCCTTTAAG TCCTTCTCAC
    CTTGTGCCTG AAGAATCTCC ATCTACCGAT GACTATGTAG TTCCTCTGCT TTCTGCACCA
    ACAGTGGCCT CTTCATCAGT TGTAGAGACT GATATTCAAG AGAAGGAAGA AGTAATCCAA
    GGTAGTCCTG AGGGCAGTGA CAGTGCAGAC TCTGTGGAAG AAATTCCTTT TCCCTTAGAA
    GTGCCCCCTA TGGAAGACGA AACTGATATA TTTCTTGGAG ATAGAGTTAT ATATGATGAT
    GGGTCTGGTT CAGCTTTTGA TGGTTCAGGA AAAGAAATGG AATCAAGTAT CTGGCCTTGG
    GAAGAAGCAA CCTTGGAACC AGTTTTCTAC CCTGGTCCTG ATAGCTGGCT TGAAGATGAC
    AATGACTCTT TGTTAATCAA AACTGAGGAT ATTCCTGAAG GCATGATTTT AGACTATATT
    CTTAACTCTG GGAATAAATT AGATTATGAT CTTTCCAAAG ATGAGAATGA AGGGATAGTC
    GATATAAAAG ATTTCCTTGA TGAATCTGAA ATATTTGTCT TTCCAGAGAC TACAACTCTG
    CAAGTACCTC TGTTACAGAC AGAAGAGCCA TCGTCTGTGG AACCATCTAC ACAGACAGAA
    ACCCTGGGCA TGTATGACTC TTCTTTTGTC ATGCCAGCTG GAGAGCCCCC TGTCTCACCA
    CCATATACAG ATCTGTCTGT GGAAGATAGT CTCGTTATAT CCACAGGGAC TGTCAGTATG
    GAGCAACCTG AGGAGTTTAG TGTAGGCCAG AACATAATCT CTGATGTAGT TGAACACCAA
    AGTGAAGACA GGGCAATGGC AGAAGAACTA TTCACAGTGA AGCAACCGGA TGTAATGGAA
    GCTGCTACGA TAGGACACTT GGACACAACC TCTTCAGGAA CTATTCTGAC TGCAGGTCCT
    TCCATGGTAA AGCCTGATGC TTCCACAGAA GAGCAGCAAG CCCTAGATTC ATCGCTGGCA
    GACCAAGACG CTCCTGGATC AGCAGTGAAG GAGCCAGCTG ATTTTTGGCC TACTGACAGG
    GCACTTGAGA CCTCCTTAGA TCAGACAGTG CAACCAGCAA TGCCAGCTGT TACTCAAGGT
    TCAGCTGAAG TTCCTTCTGT AACAGGTCAC ACCACTGTCC TAGAGGGCTT TGCTGTGCAG
    GATGGTACAG ACCATGACAC GCACATTTCC ATGAGCTTCA GCACTGTTAT GGATTATCAA
    ACAGTGAGTG TAACAACAAG CACCGTTGAG CTTCCATCCC ATCTCCCTCC TGTGGCATCC
    TCGCCATCAT TGTCTGTGGC TACCTCAACA AAGCTGGGAG ATGAAACAAC AAGAGTCCTG
    GATGTTTCAG TAGACCTGGA TGGTGTTAGC ACTGTCCACT TTTCTCCTGG GAGGACTGAG
    GAGGGAAGGA GAATGACGGA AAGTCACATG GAGCTAACAA CTCGTGTCCA GTCCACAGAG
    ATGGCCAGCG TGGCTTGGGC CACACATGAA ACTCACTATA GTAGCACAGT CCCGTCCCGA
    GCTCTAGTTG TGTTCTTCAG TCTTCGCGTT ACCAACATGA TGTTTTCAGA GGACCTGTTT
    AATAAAAACT CCCCTGAATA CAAAGCCTTG GAGCAGCGAT TCTTGGAACT GCTGGTGCCC
    TACCTTCAGT CAAATCTGAC GGGATTCCAG AATCTGGAAA TCCTGAACTT CAGAAATGGC
    AGCATTGTGG TGAACAGTCG AATGAAATTT GCCAAACCTG TGCCTCGGAA TGTCACCAAC
    GCTGTGTACA TGATCCTGGA AGATTTCTGC AACACTGCAT ATCACACCAT GAACCTGGCC
    ATTGATAAAT ACTCCCTGGA TGTGGAATCA GGTGAGCAAG CAGATCCGTG CAAGTTCCAG
    GCCTGCAATG AGTTCTCTGA GTGCTTAGTA AATCGCTGGA GTGGGGAAGC TGAGTGTGTC
    TGCAACCCTG GCTACCTCAG CATTGATGGG CTGCCATGCA ACAGCATTTG TGATCTGCAA
    CCAAACTTCT GCCTGAACGA TGGCAAGTGT GACATAAGCC CTGGGCAAGG GGCCATCTGT
    AGGTGCCGTG TGGGAGAGAA CTGGTGGTAC AGAGGGGAGC ACTGTGAGGA ATATGTGTCT
    GAGCCACTGG TTGTGGGTAT TGCGATTGCT TCTGTGGCAG GATTCCTTCT TGTGGCATCT
    GCTGTCATCT TCTTCTTGGC CAGGACCCTT CGAGACCAGT ACACAAAGAG TGATACTGGG
    GACTCACAGG GGCAGGGTGA CAGCCTCTCG TCCATTGAGA ACGCAGTTAA ATACAATCCC
    ATGTATGAAA GTGATACGAC TGGCTACAGC CATTATTACC GGAGATATCC GCAGCTAACG
    TCCTACAGTT CCACCAGTGC AGAGACATCC ACAGACTACA GCAGTGAAGA GATCAGGCAC
    ATTTATGAAA ACAGTGAGCT TACTAAGGAG GAAATTCAGG ACAGAATTCG AATTATAGAG
    CTCTACGCTA AAGACCGCCA GTTTGCAGAG TTTGTTAGGC AGCATCAAAT GAAGCTGCTT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCo102125
    Clone ID Related Accession (Same CDS sequence) XM_019283691.2
    Accession Version XM_019283691.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3768bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-03-21
    Organism Corvus cornix cornix
    Product interphotoreceptor matrix proteoglycan 2 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_018114014.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Mar 22, 2017 this sequence version replaced XM_019283691.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Corvus cornix cornix Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGCCA AGATGATCCA GGGAATCACT CATGCAGTGG GACTCCTACT
    CCACCTTTGG ATGCTGACGT CACCACACTG AGAGATGCAG CTGCCAATGT TCCTCCCCCT
    CATGAGATCT CCGTTGAGAC TCCTGCAGGT GATACCATCC ATGAGCTTGA CAATGTAGTC
    CCTACTATCA ATAATGAGAT AAAGAAGCAG GACGAAAAGC TAGTCAGACC CGTAACAGAG
    CAGATGATTG AGTTCAACAT TTTGATTGTT GGTGAACAGT ACAGTGAGGA GCTGAAGGAT
    CCATCTGCTG CTGAGTATCA ACTGCTGTCT CAACGATTCA TTTCTCAGAT TAAAAGCGTG
    TTTGAAGGAC TACCTGGATA CAAAAACATC CATATCCTGG ATTACAGCCC TTCAGAGGAA
    GACAGTGGGG TGGAAGTTCA CTATGCTGTC ACATTTGATG GAAAAGCTAT GAGCAATGCC
    ACCTGGGACC TCATTAACCT TCATTCAAAC AAGGTGGAGG ACAACTCCTT TATGGGCATA
    GAGGATAATC CAACAGTTGT GTACACCATC AGTGATTTCC AAGATTATAT TGCTGAGATC
    CTCCAGAAGA ATGCTCTGCT TGAAAATGCT TCCATGATTT TAGACCCGAA ATCTCTCCAG
    CTTACTAACG TGAAAGAAAT ACTGCATCCC ACATCAGAAG TCCCGTCCTG GATTACTGAG
    AATCCAGTTG TGCTGGCGCG CCCGGAGTTT GATGACAGCA CCTTTTTAGC TGAACGTCCT
    TCTGCAGATG AATCAACTGT CAGCAATGCT TTGCCCTTTG ATTACACCAA ACCAGACTCC
    ACCTCAGACA GTGAGCAGTC TAGTGACAAT GAAATCCAGC CAAGACCAGA GAATATTGAC
    TATGAGGCCA GTTTGGCACC TGAAGCTCCA CTTTCCTCAG AGGCTGACAT CACTGCTTTG
    CCTGATGGGC TGAATTTAGA GACTTCTCGT TTAGTCACTG TACCAGTGTT AGAGCACGGT
    TCTATGGACT CTCAGGAATG GCTTTCAGCC CCCAGTTCTT CAGAAGATAC TGGATTATCT
    GAAGAACTTT TGCCTTTAAG TCCTTCTCAC CTTGTGCCTG AAGAATCTCC ATCTACCGAT
    GACTATGTAG TTCCTCTGCT TTCTGCACCA ACAGTGGCCT CTTCATCAGT TGTAGAGACT
    GATATTCAAG AGAAGGAAGA AGTAATCCAA GAGACTACAA CTCTGCAAGT ACCTCTGTTA
    CAGACAGAAG AGCCATCGTC TGTGGAACCA TCTACACAGA CAGAAACCCT GGGCATGTAT
    GACTCTTCTT TTGTCATGCC AGCTGGAGAG CCCCCTGTCT CACCACCATA TACAGATCTG
    TCTGTGGAAG ATAGTCTCGT TATATCCACA GGGACTGTCA GTATGGAGCA ACCTGAGGAG
    TTTAGTGTAG GCCAGAACAT AATCTCTGAT GTAGTTGAAC ACCAAAGTGA AGACAGGGCA
    ATGGCAGAAG AACTATTCAC AGTGAAGCAA CCGGATGTAA TGGAAGCTGC TACGATAGGA
    CACTTGGACA CAACCTCTTC AGGAACTATT CTGACTGCAG GTCCTTCCAT GGTAAAGCCT
    GATGCTTCCA CAGAAGAGCA GCAAGCCCTA GATTCATCGC TGGCAGACCA AGACGCTCCT
    GGATCAGCAG TGAAGGAGCC AGCTGATTTT TGGCCTACTG ACAGGGCACT TGAGACCTCC
    TTAGATCAGA CAGTGCAACC AGCAATGCCA GCTGTTACTC AAGGTTCAGC TGAAGTTCCT
    TCTGTAACAG GTCACACCAC TGTCCTAGAG GGCTTTGCTG TGCAGGATGG TACAGACCAT
    GACACGCACA TTTCCATGAG CTTCAGCACT GTTATGGATT ATCAAACAGT GAGTGTAACA
    ACAAGCACCG TTGAGCTTCC ATCCCATCTC CCTCCTGTGG CATCCTCGCC ATCATTGTCT
    GTGGCTACCT CAACAAAGCT GGGAGATGAA ACAACAAGAG TCCTGGATGT TTCAGTAGAC
    CTGGATGGTG TTAGCACTGT CCACTTTTCT CCTGGGAGGA CTGAGGAGGG AAGGAGAATG
    ACGGAAAGTC ACATGGAGCT AACAACTCGT GTCCAGTCCA CAGAGATGGC CAGCGTGGCT
    TGGGCCACAC ATGAAACTCA CTATAGTAGC ACAGTCCCGT CCCGAGCTCT AGTTGTGTTC
    TTCAGTCTTC GCGTTACCAA CATGATGTTT TCAGAGGACC TGTTTAATAA AAACTCCCCT
    GAATACAAAG CCTTGGAGCA GCGATTCTTG GAACTGCTGG TGCCCTACCT TCAGTCAAAT
    CTGACGGGAT TCCAGAATCT GGAAATCCTG AACTTCAGAA ATGGCAGCAT TGTGGTGAAC
    AGTCGAATGA AATTTGCCAA ACCTGTGCCT CGGAATGTCA CCAACGCTGT GTACATGATC
    CTGGAAGATT TCTGCAACAC TGCATATCAC ACCATGAACC TGGCCATTGA TAAATACTCC
    CTGGATGTGG AATCAGGTGA GCAAGCAGAT CCGTGCAAGT TCCAGGCCTG CAATGAGTTC
    TCTGAGTGCT TAGTAAATCG CTGGAGTGGG GAAGCTGAGT GTGTCTGCAA CCCTGGCTAC
    CTCAGCATTG ATGGGCTGCC ATGCAACAGC ATTTGTGATC TGCAACCAAA CTTCTGCCTG
    AACGATGGCA AGTGTGACAT AAGCCCTGGG CAAGGGGCCA TCTGTAGGTG CCGTGTGGGA
    GAGAACTGGT GGTACAGAGG GGAGCACTGT GAGGAATATG TGTCTGAGCC ACTGGTTGTG
    GGTATTGCGA TTGCTTCTGT GGCAGGATTC CTTCTTGTGG CATCTGCTGT CATCTTCTTC
    TTGGCCAGGA CCCTTCGAGA CCAGTACACA AAGAGTGATA CTGGGGACTC ACAGGGGCAG
    GGTGACAGCC TCTCGTCCAT TGAGAACGCA GTTAAATACA ATCCCATGTA TGAAAGTGAT
    ACGACTGGCT ACAGCCATTA TTACCGGAGA TATCCGCAGC TAACGTCCTA CAGTTCCACC
    AGTGCAGAGA CATCCACAGA CTACAGCAGT GAAGAGATCA GGCACATTTA TGAAAACAGT
    GAGCTTACTA AGGAGGAAAT TCAGGACAGA ATTCGAATTA TAGAGCTCTA CGCTAAAGAC
    CGCCAGTTTG CAGAGTTTGT TAGGCAGCAT CAAATGAAGC TGCTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_019139236.2
    CDS274..4041
    Translation

    Target ORF information:

    RefSeq Version XM_019283691.2
    Organism Corvus cornix cornix
    Definition Corvus cornix cornix interphotoreceptor matrix proteoglycan 2 (IMPG2), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_019283691.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGTTTGGCT TCATTTGGAA AATCTTTCTT TGCCTTCCGG GAATGATTAA CACAGATCTT 
    CAAATAGTTG CAGCAGAAGC TTATTCAGCT GCAGAAGGAG GACAGGCTGA AGAAGTTTCA
    CCAGCCCCTC AGCTCAGTGA CTGGCAGCTG GCAAACCCTT CTCTGCCTCC TGGGTTGAAA
    AAGCCTAACA GCATCATGGA TGCTGAGCAG TTCCACAGGC ATTTGCAGTT ACGAAGGAAG
    CGGTCCATTC TGTTCCCCAG TGGAGTTAAG ATCTGCCCTG ATGAATCTGT TGAGCAGGCT
    ATTGCCAACC ATCTGAAGTA TTTCAGGCTC AGAGTGTGCC AGGAAACAGT CTGGGAGGTC
    TTCAAGACAT TCTGGGACAG ACTGCCGGAG CGTGAAGAGT ATAATGCCTG GATGAGCCTG
    TGTGAGGAAG GAATAATGAG CATCTTTGAA ATGGGCACCA ACTTCAGTCA GTCTGAGGAG
    CACCGGAGCC TGATCATGAA GAAACTGTCC TATACAAAGG AAGCAATGGG GAGTTCCTGC
    ACTGATTGGT CATGTGGCCA AGATGATCCA GGGAATCACT CATGCAGTGG GACTCCTACT
    CCACCTTTGG ATGCTGACGT CACCACACTG AGAGATGCAG CTGCCAATGT TCCTCCCCCT
    CATGAGATCT CCGTTGAGAC TCCTGCAGGT GATACCATCC ATGAGCTTGA CAATGTAGTC
    CCTACTATCA ATAATGAGAT AAAGAAGCAG GACGAAAAGC TAGTCAGACC CGTAACAGAG
    CAGATGATTG AGTTCAACAT TTTGATTGTT GGTGAACAGT ACAGTGAGGA GCTGAAGGAT
    CCATCTGCTG CTGAGTATCA ACTGCTGTCT CAACGATTCA TTTCTCAGAT TAAAAGCGTG
    TTTGAAGGAC TACCTGGATA CAAAAACATC CATATCCTGG ATTACAGCCC TTCAGAGGAA
    GACAGTGGGG TGGAAGTTCA CTATGCTGTC ACATTTGATG GAAAAGCTAT GAGCAATGCC
    ACCTGGGACC TCATTAACCT TCATTCAAAC AAGGTGGAGG ACAACTCCTT TATGGGCATA
    GAGGATAATC CAACAGTTGT GTACACCATC AGTGATTTCC AAGATTATAT TGCTGAGATC
    CTCCAGAAGA ATGCTCTGCT TGAAAATGCT TCCATGATTT TAGACCCGAA ATCTCTCCAG
    CTTACTAACG TGAAAGAAAT ACTGCATCCC ACATCAGAAG TCCCGTCCTG GATTACTGAG
    AATCCAGTTG TGCTGGCGCG CCCGGAGTTT GATGACAGCA CCTTTTTAGC TGAACGTCCT
    TCTGCAGATG AATCAACTGT CAGCAATGCT TTGCCCTTTG ATTACACCAA ACCAGACTCC
    ACCTCAGACA GTGAGCAGTC TAGTGACAAT GAAATCCAGC CAAGACCAGA GAATATTGAC
    TATGAGGCCA GTTTGGCACC TGAAGCTCCA CTTTCCTCAG AGGCTGACAT CACTGCTTTG
    CCTGATGGGC TGAATTTAGA GACTTCTCGT TTAGTCACTG TACCAGTGTT AGAGCACGGT
    TCTATGGACT CTCAGGAATG GCTTTCAGCC CCCAGTTCTT CAGAAGATAC TGGATTATCT
    GAAGAACTTT TGCCTTTAAG TCCTTCTCAC CTTGTGCCTG AAGAATCTCC ATCTACCGAT
    GACTATGTAG TTCCTCTGCT TTCTGCACCA ACAGTGGCCT CTTCATCAGT TGTAGAGACT
    GATATTCAAG AGAAGGAAGA AGTAATCCAA GAGACTACAA CTCTGCAAGT ACCTCTGTTA
    CAGACAGAAG AGCCATCGTC TGTGGAACCA TCTACACAGA CAGAAACCCT GGGCATGTAT
    GACTCTTCTT TTGTCATGCC AGCTGGAGAG CCCCCTGTCT CACCACCATA TACAGATCTG
    TCTGTGGAAG ATAGTCTCGT TATATCCACA GGGACTGTCA GTATGGAGCA ACCTGAGGAG
    TTTAGTGTAG GCCAGAACAT AATCTCTGAT GTAGTTGAAC ACCAAAGTGA AGACAGGGCA
    ATGGCAGAAG AACTATTCAC AGTGAAGCAA CCGGATGTAA TGGAAGCTGC TACGATAGGA
    CACTTGGACA CAACCTCTTC AGGAACTATT CTGACTGCAG GTCCTTCCAT GGTAAAGCCT
    GATGCTTCCA CAGAAGAGCA GCAAGCCCTA GATTCATCGC TGGCAGACCA AGACGCTCCT
    GGATCAGCAG TGAAGGAGCC AGCTGATTTT TGGCCTACTG ACAGGGCACT TGAGACCTCC
    TTAGATCAGA CAGTGCAACC AGCAATGCCA GCTGTTACTC AAGGTTCAGC TGAAGTTCCT
    TCTGTAACAG GTCACACCAC TGTCCTAGAG GGCTTTGCTG TGCAGGATGG TACAGACCAT
    GACACGCACA TTTCCATGAG CTTCAGCACT GTTATGGATT ATCAAACAGT GAGTGTAACA
    ACAAGCACCG TTGAGCTTCC ATCCCATCTC CCTCCTGTGG CATCCTCGCC ATCATTGTCT
    GTGGCTACCT CAACAAAGCT GGGAGATGAA ACAACAAGAG TCCTGGATGT TTCAGTAGAC
    CTGGATGGTG TTAGCACTGT CCACTTTTCT CCTGGGAGGA CTGAGGAGGG AAGGAGAATG
    ACGGAAAGTC ACATGGAGCT AACAACTCGT GTCCAGTCCA CAGAGATGGC CAGCGTGGCT
    TGGGCCACAC ATGAAACTCA CTATAGTAGC ACAGTCCCGT CCCGAGCTCT AGTTGTGTTC
    TTCAGTCTTC GCGTTACCAA CATGATGTTT TCAGAGGACC TGTTTAATAA AAACTCCCCT
    GAATACAAAG CCTTGGAGCA GCGATTCTTG GAACTGCTGG TGCCCTACCT TCAGTCAAAT
    CTGACGGGAT TCCAGAATCT GGAAATCCTG AACTTCAGAA ATGGCAGCAT TGTGGTGAAC
    AGTCGAATGA AATTTGCCAA ACCTGTGCCT CGGAATGTCA CCAACGCTGT GTACATGATC
    CTGGAAGATT TCTGCAACAC TGCATATCAC ACCATGAACC TGGCCATTGA TAAATACTCC
    CTGGATGTGG AATCAGGTGA GCAAGCAGAT CCGTGCAAGT TCCAGGCCTG CAATGAGTTC
    TCTGAGTGCT TAGTAAATCG CTGGAGTGGG GAAGCTGAGT GTGTCTGCAA CCCTGGCTAC
    CTCAGCATTG ATGGGCTGCC ATGCAACAGC ATTTGTGATC TGCAACCAAA CTTCTGCCTG
    AACGATGGCA AGTGTGACAT AAGCCCTGGG CAAGGGGCCA TCTGTAGGTG CCGTGTGGGA
    GAGAACTGGT GGTACAGAGG GGAGCACTGT GAGGAATATG TGTCTGAGCC ACTGGTTGTG
    GGTATTGCGA TTGCTTCTGT GGCAGGATTC CTTCTTGTGG CATCTGCTGT CATCTTCTTC
    TTGGCCAGGA CCCTTCGAGA CCAGTACACA AAGAGTGATA CTGGGGACTC ACAGGGGCAG
    GGTGACAGCC TCTCGTCCAT TGAGAACGCA GTTAAATACA ATCCCATGTA TGAAAGTGAT
    ACGACTGGCT ACAGCCATTA TTACCGGAGA TATCCGCAGC TAACGTCCTA CAGTTCCACC
    AGTGCAGAGA CATCCACAGA CTACAGCAGT GAAGAGATCA GGCACATTTA TGAAAACAGT
    GAGCTTACTA AGGAGGAAAT TCAGGACAGA ATTCGAATTA TAGAGCTCTA CGCTAAAGAC
    CGCCAGTTTG CAGAGTTTGT TAGGCAGCAT CAAATGAAGC TGCTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.