LOC105617074 cDNA ORF clone, Atta cephalotes

The following LOC105617074 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105617074 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt113264 XM_012198653.1
Latest version!
Atta cephalotes KN motif and ankyrin repeat domain-containing protein 2 (LOC105617074), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt113264
    Clone ID Related Accession (Same CDS sequence) XM_012198653.1
    Accession Version XM_012198653.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3192bp)
    Protein sequence
    SNP
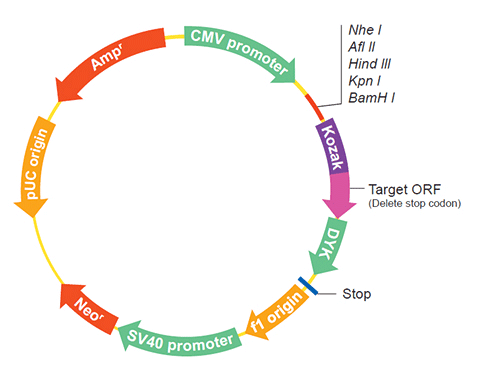
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
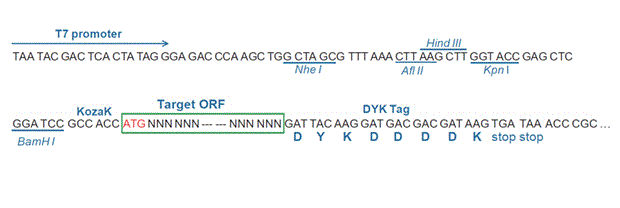
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product KN motif and ankyrin repeat domain-containing protein 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130075.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCCCTGA CTGTCGTTCC CTCGACCCGT GTTTTCAATG GAAATGTGGG GACGCAGGCG 
    TACGTTTCCG GTTCGAAATG CCTTTGTTGC CCTTATGGAT ATCACATCGA TCTGGATTTC
    GTGCGTTATT GCGAGGCTGT CGCAGCCGGA AGTGCCGGGG ACAGGCCCTG CACGGAACGG
    CGTAAGAAGC GAGAACGTCG TAGACAATGT CAGTCAATGG AGGTTCTTCT TGGCCTGGTG
    AGTCCGGCAC TGGCGGGCAT AGAGGCTGAA TTGCCGAAAA TACCACAAGA ATGTACGACC
    GCGAACGGGC TGACTACTCT GCCGAGATCA AATCATCCGC CGCCAAGACA GCAGAGAGAT
    TTGCATCCCT CGCCAGTCGT CGATCTCAGC GATGTCGTGG GTGATTTCGA AGCAACCCTC
    AAGCGATCTT GCAGGTCATC GAAAACTTCC GATTGTCGAC TTTTCACAGA AACCGATGGC
    ACAAATGGGA CGGCACCGGT GCAAAATGCG GCTCAGACAG ACCAGCCGGC AGATTCTGAC
    AACGCCAGCG TTGGAAGTGG CAATTCGAAT CTTAGTACCG GCGCACTTCA GAATATCAGG
    GAACAAATGG CGGCATCTCT GGAACGAATG AAAGAGTTGG AGGAACAGGT CAAGGCGATT
    CCCATGCTGC AGGTGCAAGT CTCGGTATTG AAAGAGGAGA AGCGTAATCT TCTACGGCAA
    GTGGACGAGC TGAGTAAAAC GAATTCCTAC AATGACACCC TACACAGGCA TCGCAGCCAG
    TCGTTTTCAG AACAATGTAC TCCCCTACGA AACCTGAAGA ACTCTGAAAG CGTATCTACC
    AGGGACATGG GAACCATGTG TGGCGTGATG ACAAGGGATG TCGGAGTATC GTACCAACCG
    GTTCGAACGA GAGACGTCGG TATGATAACA AGCACACCGA TCAAACCATC GTTACAAGAG
    AGTCATTTGC GAATCGAGGA GATTATACCC GAGATCCAAG ATCAGAGTAC TGTATTGGTC
    GACGAAACAT CGTCAAACCT CTCGAACCTT TGCAATTCTC AGTCTCGCAG CTGGAAATCG
    AGTTTAACCC GCAGTCAACT GATGCTGGAG GAGGTCCTGC CGGAAGTACG AAAAAAACAA
    TTAACGAGAA CTCCACTTCA AGTGGAATCG ATACTGCCTA ACAATGAGAA CAATGTGATT
    AATCGCAAAA CCATAAAGAA AACACGAGAC TTCGGTATTA ATACGGAAAA CAAATCCAGG
    AGTCTTGAAT ACAGTCACTT CCTAATTGAG GATATTGCAC CGGAAGTGAA GAAGGAGATA
    AAAAAACGTT CTTACGGCAC AACAACAAGA TTAAGTATGA AGGATCTTCT ATCGAAAGAA
    GATGCTGAAT TGCTTGTGGA ACATGCTTTA AGGAATTACA AGAACAATTT AATGAAAGAT
    ACTTCCTCCA GGAGCGTTCA ATGCAGTCCA GAAACGCCCA AAGTCGCTGA GAAGCGGGAT
    CGGTCGGTTC AAGTGACAGA ACAGTTTAAA ATGCGCTCAC ATGTGAGCGT AACTGCTAAG
    CCGATGACAT CGGAAGTCGG GATTGAAGTC AAACTCGGTG CTTGCATCAG AAGCATAGGC
    GTTGGACCAG ATCCAGTGCA GCCGCCTGTG TCGTTGAACT GGATAAATTT GAGGAGTCAT
    TCATTCAACT ATGGTGACAC GCGAATGAAG ACAAAAGCGA GCAAGTCGGT AGCGGTGATG
    GTGGAGGATT TGGTAAAAAC CATCGCTCGC GGTACCGATA CTTCCGGTCT CACGCCAAAG
    TGTCGAGATT TTGGTACCTC GACGATGAAG AAGACGTTGG TCGACGTGTC GGTCGGTGAT
    TCTGTGAGGC CGCACATCTC GATCTCTTGC GCGGCGAATT ATTGCGATAA TTGCAAGGAG
    ACAATCAAAA GTTTGGCGAA GCAAATAGCA AACAATGCAG AGAACAGCCT GAATCATCAG
    AACAGCAATA TGGTATCCAG GATCCCGAGG CCGTCCCATA TTCCTCTGAA CACCAGTGAT
    TATAGAAGAC AATTCAAACG CCAGGACACT TACACAAAAA TATCAGCCGC CGGTGTGATT
    AGATACGACG CGGACAATAA AGAGCAGTAC GACAGTAGCA ATCGTATTCA ACAACTGCAA
    TCCGAGAAAA CCAAGGATGA GAAGATTGTG TCAGAAGAGA TGTGTAACGT GGAGAAGGAG
    ACAGATAACG AGGAGAAATC GGAGCTACCA GAATCAGCTT TGTTTCAACC AATTCAAGAT
    AAGCCTAGGA AAAAGGTTGA GCCCTCGAAG GAGATGCAGG CCGCTATGAA GGTGCTCAAC
    GACAGTATCA AGAAATCACC TAGCAGAAAT ATCTCTCATC AGCTTAAAAA TGCTACCAAT
    ATTATACAAC AAGAATGGTT CAAAATATCC AGCACATCTA GCGCGAATCC GTTAGATGTC
    GAGGATTATT TGGACCGTTT TGAGGAATGC TCCAGCACTC TGCTGGAGTA CATTGTCAAT
    ATGACGGACA CCAGTGGAAA TACAGCGATG CACTATGCGG TCTCTCATGG CAATTTCGAC
    GTGGTGTCTA TATTATTAGA TTCGAAAGTC TGCGATATTA ATAAGGCGAA CGTGGCTGGT
    TACACGGCTG TGATGTTAGC TGCTCTGGCA GAAGTCAGAA ATTCCACGCA CGCCTCGGTA
    GCGAATAGAT TGTTCCAGCT TGCTGACGTC AACATCCGAG CAAAATTGCA TGGACAAACT
    GCGCTGATGT TGGCAGTATC ACACGGACGT AAGGATATGA CGCAACTGCT TCTAGATGCT
    GGAGCAGCAG TTAATATCCA GGATGAAGAC GGTAGCACCG CGCTAATGTG CGCAGCGGAA
    CACGGCCACA CTGAGATCGT GAGATTGCTC CTTGCACATC CGGACTGCGA TCCATCTATA
    GTCGACGTAG ATGGCAGTTC GGCCCTGAAG ATCGCCTTGG AGGCGGGTAA TCGGGATATT
    GGAGTGCTAC TTTATGCTCA TGAGCACGTT AATCGGGGCA TTAGCCCATA TTCTACTCTA
    AGACGAAGCA GAAGAGGTTC CAAGCCGACA ACACCCACTG GACCGTCTCC ATCGGCTCCA
    GCTAGCCCGG CGCCATCACG ACGTATTCAC TCGTCCAGCG TTTCTCTGAA CACATCGAAA
    TATTCCAAAT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012054043.1
    CDS1..3192
    Translation

    Target ORF information:

    RefSeq Version XM_012198653.1
    Organism Atta cephalotes
    Definition Atta cephalotes KN motif and ankyrin repeat domain-containing protein 2 (LOC105617074), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012198653.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGGCCCTGA CTGTCGTTCC CTCGACCCGT GTTTTCAATG GAAATGTGGG GACGCAGGCG 
    TACGTTTCCG GTTCGAAATG CCTTTGTTGC CCTTATGGAT ATCACATCGA TCTGGATTTC
    GTGCGTTATT GCGAGGCTGT CGCAGCCGGA AGTGCCGGGG ACAGGCCCTG CACGGAACGG
    CGTAAGAAGC GAGAACGTCG TAGACAATGT CAGTCAATGG AGGTTCTTCT TGGCCTGGTG
    AGTCCGGCAC TGGCGGGCAT AGAGGCTGAA TTGCCGAAAA TACCACAAGA ATGTACGACC
    GCGAACGGGC TGACTACTCT GCCGAGATCA AATCATCCGC CGCCAAGACA GCAGAGAGAT
    TTGCATCCCT CGCCAGTCGT CGATCTCAGC GATGTCGTGG GTGATTTCGA AGCAACCCTC
    AAGCGATCTT GCAGGTCATC GAAAACTTCC GATTGTCGAC TTTTCACAGA AACCGATGGC
    ACAAATGGGA CGGCACCGGT GCAAAATGCG GCTCAGACAG ACCAGCCGGC AGATTCTGAC
    AACGCCAGCG TTGGAAGTGG CAATTCGAAT CTTAGTACCG GCGCACTTCA GAATATCAGG
    GAACAAATGG CGGCATCTCT GGAACGAATG AAAGAGTTGG AGGAACAGGT CAAGGCGATT
    CCCATGCTGC AGGTGCAAGT CTCGGTATTG AAAGAGGAGA AGCGTAATCT TCTACGGCAA
    GTGGACGAGC TGAGTAAAAC GAATTCCTAC AATGACACCC TACACAGGCA TCGCAGCCAG
    TCGTTTTCAG AACAATGTAC TCCCCTACGA AACCTGAAGA ACTCTGAAAG CGTATCTACC
    AGGGACATGG GAACCATGTG TGGCGTGATG ACAAGGGATG TCGGAGTATC GTACCAACCG
    GTTCGAACGA GAGACGTCGG TATGATAACA AGCACACCGA TCAAACCATC GTTACAAGAG
    AGTCATTTGC GAATCGAGGA GATTATACCC GAGATCCAAG ATCAGAGTAC TGTATTGGTC
    GACGAAACAT CGTCAAACCT CTCGAACCTT TGCAATTCTC AGTCTCGCAG CTGGAAATCG
    AGTTTAACCC GCAGTCAACT GATGCTGGAG GAGGTCCTGC CGGAAGTACG AAAAAAACAA
    TTAACGAGAA CTCCACTTCA AGTGGAATCG ATACTGCCTA ACAATGAGAA CAATGTGATT
    AATCGCAAAA CCATAAAGAA AACACGAGAC TTCGGTATTA ATACGGAAAA CAAATCCAGG
    AGTCTTGAAT ACAGTCACTT CCTAATTGAG GATATTGCAC CGGAAGTGAA GAAGGAGATA
    AAAAAACGTT CTTACGGCAC AACAACAAGA TTAAGTATGA AGGATCTTCT ATCGAAAGAA
    GATGCTGAAT TGCTTGTGGA ACATGCTTTA AGGAATTACA AGAACAATTT AATGAAAGAT
    ACTTCCTCCA GGAGCGTTCA ATGCAGTCCA GAAACGCCCA AAGTCGCTGA GAAGCGGGAT
    CGGTCGGTTC AAGTGACAGA ACAGTTTAAA ATGCGCTCAC ATGTGAGCGT AACTGCTAAG
    CCGATGACAT CGGAAGTCGG GATTGAAGTC AAACTCGGTG CTTGCATCAG AAGCATAGGC
    GTTGGACCAG ATCCAGTGCA GCCGCCTGTG TCGTTGAACT GGATAAATTT GAGGAGTCAT
    TCATTCAACT ATGGTGACAC GCGAATGAAG ACAAAAGCGA GCAAGTCGGT AGCGGTGATG
    GTGGAGGATT TGGTAAAAAC CATCGCTCGC GGTACCGATA CTTCCGGTCT CACGCCAAAG
    TGTCGAGATT TTGGTACCTC GACGATGAAG AAGACGTTGG TCGACGTGTC GGTCGGTGAT
    TCTGTGAGGC CGCACATCTC GATCTCTTGC GCGGCGAATT ATTGCGATAA TTGCAAGGAG
    ACAATCAAAA GTTTGGCGAA GCAAATAGCA AACAATGCAG AGAACAGCCT GAATCATCAG
    AACAGCAATA TGGTATCCAG GATCCCGAGG CCGTCCCATA TTCCTCTGAA CACCAGTGAT
    TATAGAAGAC AATTCAAACG CCAGGACACT TACACAAAAA TATCAGCCGC CGGTGTGATT
    AGATACGACG CGGACAATAA AGAGCAGTAC GACAGTAGCA ATCGTATTCA ACAACTGCAA
    TCCGAGAAAA CCAAGGATGA GAAGATTGTG TCAGAAGAGA TGTGTAACGT GGAGAAGGAG
    ACAGATAACG AGGAGAAATC GGAGCTACCA GAATCAGCTT TGTTTCAACC AATTCAAGAT
    AAGCCTAGGA AAAAGGTTGA GCCCTCGAAG GAGATGCAGG CCGCTATGAA GGTGCTCAAC
    GACAGTATCA AGAAATCACC TAGCAGAAAT ATCTCTCATC AGCTTAAAAA TGCTACCAAT
    ATTATACAAC AAGAATGGTT CAAAATATCC AGCACATCTA GCGCGAATCC GTTAGATGTC
    GAGGATTATT TGGACCGTTT TGAGGAATGC TCCAGCACTC TGCTGGAGTA CATTGTCAAT
    ATGACGGACA CCAGTGGAAA TACAGCGATG CACTATGCGG TCTCTCATGG CAATTTCGAC
    GTGGTGTCTA TATTATTAGA TTCGAAAGTC TGCGATATTA ATAAGGCGAA CGTGGCTGGT
    TACACGGCTG TGATGTTAGC TGCTCTGGCA GAAGTCAGAA ATTCCACGCA CGCCTCGGTA
    GCGAATAGAT TGTTCCAGCT TGCTGACGTC AACATCCGAG CAAAATTGCA TGGACAAACT
    GCGCTGATGT TGGCAGTATC ACACGGACGT AAGGATATGA CGCAACTGCT TCTAGATGCT
    GGAGCAGCAG TTAATATCCA GGATGAAGAC GGTAGCACCG CGCTAATGTG CGCAGCGGAA
    CACGGCCACA CTGAGATCGT GAGATTGCTC CTTGCACATC CGGACTGCGA TCCATCTATA
    GTCGACGTAG ATGGCAGTTC GGCCCTGAAG ATCGCCTTGG AGGCGGGTAA TCGGGATATT
    GGAGTGCTAC TTTATGCTCA TGAGCACGTT AATCGGGGCA TTAGCCCATA TTCTACTCTA
    AGACGAAGCA GAAGAGGTTC CAAGCCGACA ACACCCACTG GACCGTCTCC ATCGGCTCCA
    GCTAGCCCGG CGCCATCACG ACGTATTCAC TCGTCCAGCG TTTCTCTGAA CACATCGAAA
    TATTCCAAAT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.