ARHGAP39 cDNA ORF clone, Anas platyrhynchos(mallard)

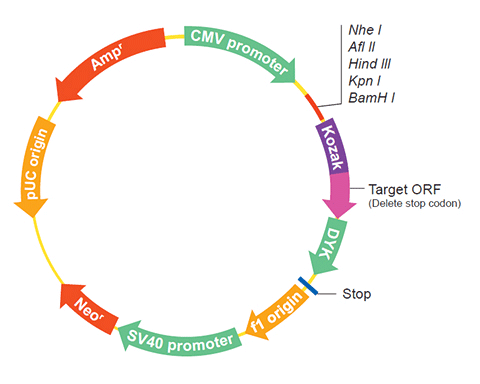
The following ARHGAP39 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ARHGAP39 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAn153824 XM_021276289.1
Latest version!
Anas platyrhynchos rho GTPase-activating protein 39-like (LOC101797856), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OAn116677 XM_013104985.1
Latest version!
Anas platyrhynchos rho GTPase-activating protein 39-like (LOC101797856), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00
OAn170646 XM_027452804.1
Latest version!
Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OAn170647 XM_027452805.1
Latest version!
Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OAn170648 XM_027452806.1
Latest version!
Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAn153824
    Clone ID Related Accession (Same CDS sequence) XM_021276289.1
    Accession Version XM_021276289.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2781bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
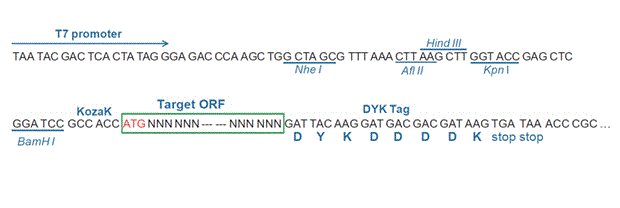
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2017-05-23
    Organism Anas platyrhynchos(mallard)
    Product LOW QUALITY PROTEIN: rho GTPase-activating protein 39-like
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_004677690.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Anas platyrhynchos Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases frameshifts :: corrected 2 indels ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCTGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACACCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GTACTCGCGC CGCCCCTCGG GGGGCCAGCA GTCCCCCAAC
    CTTCAGACCT TCACCCCCGA GGCCGACAAC TCCGTTTTCT TCCCGGAGAN GAAGCCCTCG
    CCCTTCTTGA AGAGGGCTGA GCACGTGGGC AGCTGCTCGC CGCTGCTGGG CCGGGGCGAT
    TCCTTCTGCT CCCCGCTGCA GACGCAGCAC CGCAAGCACT CGAGCGAGTC GCAGCCCTCC
    TCGCCCCGCT ACGCCTACGA GCCGCCGCTC TACGAGGAGC CCCCCATGGA GTACCAGGCG
    CCCATCTACG ACGAGCCCCC CGTGGACATG CAGTACGAAG CCAGCGGCAG CTACAAGGCC
    GGCTCGCCCC AAAAGTCGCC CATCCGCAAG CCTCACCCCT TCCTCCAGTC GCCCAAGCAA
    GGCTCCAACT CGCCCTACCA GCAGCTGGTG CTCACCAAGC AGAAGTGTCC CGNNNNNNNN
    NNNNNNNTCA TGAGCCTGGA GTACAGCCCC GCGGGCAAGG AGTACGTCCG GCAGCTGGTC
    TACGTCGAGC AGTCGGGCTC CAGCCCCAAG ATGAAGACGG GGTTGCGCCA CAAGTACTCG
    CCCAACCCCA TCGGCGGCTC CTACTCGCTG CAGCACAGCC CCTGCCTGCT CCGTGACCAG
    CGCCTGGACG TCAAATCGGG TGACTACAGC AGCATGGAAG GACCCGAATT TNNTGGCCNN
    CCCGGGCAAC CAGCGGGCCA GGCGGCCCCG GGCGAGGACT CTATGTCGTG GTCCAGCCAG
    CAGGACACCA TGTCCTCCAC CGGCTACTCC CCGGCCGTTC TCTCCCAGTC AGAAGACCTC
    GGCGCCTGCG CCCAGTTCGA GAGCAGCAGG CAGACCAGGA ACATGATGCC CAGCGCCAGC
    TGCGTCTTCC CCACCTTCAA CCTGCGGAAG CCCTCCTCGG AGACGGACAT TGAGAACTGG
    GCCTCCAAGC ACTTCAACAA GCACACGCAG GGGCTCTTCC GTAGGAAGGT GTCCATCGCC
    AACATGCTGG CCTGGAGCAG CGAGTCCATC AAGAAGCCCA TGATCATGAC CAACGACCGC
    AACGTCAAGA AGGAGGCGTG CGAGATATTT AAACTGATTC AGATGTACAT GGGGGACCGG
    CGGGCCAAGA CGGACCAACT CAACGTGGCC TTGGAGATCG CCACCAAGGG CTGGAGCATG
    CAGGGCCTGC GAGACGAGCT CTACATCCAG CTGTGCCGGC AGNNGCACAT CACCGAGAAC
    TTCCGATACG AGAGCCTGGC CCGGGGCTGG GAGCTCATGG CCATTTGTTT GGCCTTCTTC
    CCCCCCACCC CCAAATTCCA TTCCTACCTA GAAGGATATA TTTACAGGCA CATGGATCCG
    GTGAACGACA CCAAAGTGAC ACAGCACATT AAAGAGGTCC TGGAAAGGAA CAGTAAGAAG
    AAATCCAAAT TGAGAAAGAA ACCCAAGCCC TATATCGAAG AGCATGATGG GGTGGCCATC
    AGCACCTACG CCAAGTACTG CTACAACAAG CTGCAGAAGG CAGCCCTGAC CGGAGCCAAG
    AAGGGCCTGA AGAAGCCGAA CATCGAGGAG ATCCGCCACG CCAAGAACGC CGTCTTCAAC
    CCCTCCATGT TCGGGAGCTC CCTGCAGGAC ATCATCGCCA TGCAGAAGGA GCGCTACCCC
    GACCGGCAGC TGCCCTGGGT GCAAACGCGC CTCTCCGAGG AGGTGCTGGC GCTCAACGGG
    GACCAGACCG AGGGCATCTT CAGGGTCCCC GGGGACATCG ATGAGGTCAA CGCGCTCAAG
    CTGCAGGTGG ACCAGTGGAA GATCCCAACG GGCTTGGAGG ACCCCCACGT TCCCGCGTCC
    CTGCTGAAGC TGTGGTACCG GGAGCTGGAG GAGCCGCTGA TCCCCCACGA GTTCTACGAG
    CAGTGCATCA CCCACTACGA GAACCCCGAG GCAGCCATCG CTGTCGTCCA CTCTCTGCCC
    AGGATCAACA AAATGGTGCT GTGCTACCTC ATCCGCTTCC TACAGGTGTT CGTGCAGCCG
    GCCAACGTGG CCGTCACCAA GATGGACGTC AATAACCTGG CCATGGTGAT GGCCCCCAAC
    TGCCTGCGCT GCCANNNNNN NNNNNNNNNN TGCCAGTCGG ACGACCCGCG GATCATCTTC
    GAGAACACCC GCAAGGAGAT GTCCTTCATC CGGGTGCTCA TCCAGCACCT CGACACCAGC
    TTCATGGAGG GCGTCCTATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_021131964.1
    CDS1..2781
    Translation

    Target ORF information:

    RefSeq Version XM_021276289.1
    Organism Anas platyrhynchos(mallard)
    Definition Anas platyrhynchos rho GTPase-activating protein 39-like (LOC101797856), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_021276289.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCTGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACACCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GTACTCGCGC CGCCCCTCGG GGGGCCAGCA GTCCCCCAAC
    CTTCAGACCT TCACCCCCGA GGCCGACAAC TCCGTTTTCT TCCCGGAGAN GAAGCCCTCG
    CCCTTCTTGA AGAGGGCTGA GCACGTGGGC AGCTGCTCGC CGCTGCTGGG CCGGGGCGAT
    TCCTTCTGCT CCCCGCTGCA GACGCAGCAC CGCAAGCACT CGAGCGAGTC GCAGCCCTCC
    TCGCCCCGCT ACGCCTACGA GCCGCCGCTC TACGAGGAGC CCCCCATGGA GTACCAGGCG
    CCCATCTACG ACGAGCCCCC CGTGGACATG CAGTACGAAG CCAGCGGCAG CTACAAGGCC
    GGCTCGCCCC AAAAGTCGCC CATCCGCAAG CCTCACCCCT TCCTCCAGTC GCCCAAGCAA
    GGCTCCAACT CGCCCTACCA GCAGCTGGTG CTCACCAAGC AGAAGTGTCC CGNNNNNNNN
    NNNNNNNTCA TGAGCCTGGA GTACAGCCCC GCGGGCAAGG AGTACGTCCG GCAGCTGGTC
    TACGTCGAGC AGTCGGGCTC CAGCCCCAAG ATGAAGACGG GGTTGCGCCA CAAGTACTCG
    CCCAACCCCA TCGGCGGCTC CTACTCGCTG CAGCACAGCC CCTGCCTGCT CCGTGACCAG
    CGCCTGGACG TCAAATCGGG TGACTACAGC AGCATGGAAG GACCCGAATT TNNTGGCCNN
    CCCGGGCAAC CAGCGGGCCA GGCGGCCCCG GGCGAGGACT CTATGTCGTG GTCCAGCCAG
    CAGGACACCA TGTCCTCCAC CGGCTACTCC CCGGCCGTTC TCTCCCAGTC AGAAGACCTC
    GGCGCCTGCG CCCAGTTCGA GAGCAGCAGG CAGACCAGGA ACATGATGCC CAGCGCCAGC
    TGCGTCTTCC CCACCTTCAA CCTGCGGAAG CCCTCCTCGG AGACGGACAT TGAGAACTGG
    GCCTCCAAGC ACTTCAACAA GCACACGCAG GGGCTCTTCC GTAGGAAGGT GTCCATCGCC
    AACATGCTGG CCTGGAGCAG CGAGTCCATC AAGAAGCCCA TGATCATGAC CAACGACCGC
    AACGTCAAGA AGGAGGCGTG CGAGATATTT AAACTGATTC AGATGTACAT GGGGGACCGG
    CGGGCCAAGA CGGACCAACT CAACGTGGCC TTGGAGATCG CCACCAAGGG CTGGAGCATG
    CAGGGCCTGC GAGACGAGCT CTACATCCAG CTGTGCCGGC AGNNGCACAT CACCGAGAAC
    TTCCGATACG AGAGCCTGGC CCGGGGCTGG GAGCTCATGG CCATTTGTTT GGCCTTCTTC
    CCCCCCACCC CCAAATTCCA TTCCTACCTA GAAGGATATA TTTACAGGCA CATGGATCCG
    GTGAACGACA CCAAAGTGAC ACAGCACATT AAAGAGGTCC TGGAAAGGAA CAGTAAGAAG
    AAATCCAAAT TGAGAAAGAA ACCCAAGCCC TATATCGAAG AGCATGATGG GGTGGCCATC
    AGCACCTACG CCAAGTACTG CTACAACAAG CTGCAGAAGG CAGCCCTGAC CGGAGCCAAG
    AAGGGCCTGA AGAAGCCGAA CATCGAGGAG ATCCGCCACG CCAAGAACGC CGTCTTCAAC
    CCCTCCATGT TCGGGAGCTC CCTGCAGGAC ATCATCGCCA TGCAGAAGGA GCGCTACCCC
    GACCGGCAGC TGCCCTGGGT GCAAACGCGC CTCTCCGAGG AGGTGCTGGC GCTCAACGGG
    GACCAGACCG AGGGCATCTT CAGGGTCCCC GGGGACATCG ATGAGGTCAA CGCGCTCAAG
    CTGCAGGTGG ACCAGTGGAA GATCCCAACG GGCTTGGAGG ACCCCCACGT TCCCGCGTCC
    CTGCTGAAGC TGTGGTACCG GGAGCTGGAG GAGCCGCTGA TCCCCCACGA GTTCTACGAG
    CAGTGCATCA CCCACTACGA GAACCCCGAG GCAGCCATCG CTGTCGTCCA CTCTCTGCCC
    AGGATCAACA AAATGGTGCT GTGCTACCTC ATCCGCTTCC TACAGGTGTT CGTGCAGCCG
    GCCAACGTGG CCGTCACCAA GATGGACGTC AATAACCTGG CCATGGTGAT GGCCCCCAAC
    TGCCTGCGCT GCCANNNNNN NNNNNNNNNN TGCCAGTCGG ACGACCCGCG GATCATCTTC
    GAGAACACCC GCAAGGAGAT GTCCTTCATC CGGGTGCTCA TCCAGCACCT CGACACCAGC
    TTCATGGAGG GCGTCCTATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAn116677
    Clone ID Related Accession (Same CDS sequence) XM_013104985.1
    Accession Version XM_013104985.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3162bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-07-08
    Organism Anas platyrhynchos(Mallard)
    Product LOW QUALITY PROTEIN: rho GTPase-activating protein 39-like
    Comment MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_004677690.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Anas platyrhynchos Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.3 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases frameshifts :: corrected 3 indels internal stop codons :: corrected 4 genomic stop codons ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCTGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACACCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GTACTCGCGC CGCCCCTCGG GGGGCCAGCA GTCCCCCAAC
    CTTCAGACCT TCACCCCCGA GGCCGACAAC TCCGTTTTCT TCCCGGAGAN GAAGCCCTCG
    CCCTTCTTGA AGAGGGCTGA GCACGTGGGC AGCTGCTCGC CGCTGCTGGG CCGGGGCGAT
    TCCTTCTGCT CCCCGCTGCA GACGCAGCAC CGCAAGCACT CGAGCGAGTC GCAGCCCTCC
    TCGCCCCGCT ACGCCTACGA GCCGCCGCTC TACGAGGAGC CCCCCATGGA GTACCAGGCG
    CCCATCTACG ACGAGCCCCC CGTGGACATG CAGTACGAAG CCAGCGGCAG CTACAAGGCC
    GGCTCGCCCC AAAAGTCGCC CATCCGCAAG CCTCACCCCT TCCTCCAGTC GCCCAAGCAA
    GGCTCCAACT CGCCCTACCA GCAGCTGGTG CTCACCAAGC AGAAGTGTCC CGNNNNNNNN
    NNNNNNNTCA TGAGCCTGGA GTACAGCCCC GCGGGCAAGG AGTACGTCCG GCAGCTGGTC
    TACGTCGAGC AGTCGGGCTC CAGCCCCAAG ATGAAGACGG GGTTGCGCCA CAAGTACTCG
    CCCAACCCCA TCGGCGGCTC CTACTCGCTG CAGCACAGCC CCTGCCTGCT CCGTGACCAG
    CGCCTGGACG TCAAATCGGG TGACTACAGC AGCATGGAAG GACCCGAATT TNNTGGCCNN
    CCCGGGCAAC CAGCGGGCCA GGCGGCCCCG GGCGAGGACT CTATGTCGTG GTCCAGCCAG
    CAGGACACCA TGTCCTCCAC CGGCTACTCC ACTGGTACCA GTAGCAGGAG GACCCAAACC
    AGCACCAGGT CCTCACCAGT TGGGTGCTGT GCTAAATCCC AGTCACCCAC ATCCTTCTGC
    ACGTGGGGTC CAAGGGAAGA AAACCCTNNG ACAATGCCTT TTAGGGTCCC ACCTGCTCCT
    GGTGTCCACG AGAACGTGTC TGGCTCCCAA AGTCACTTGT CCCCAGCCTG GTGCTGGTGT
    CCACCAGCCT CCTCCTGGGC TTGGGGACAC CAGAAAACCG TGTGCGAAGG TGGCTTTGTG
    GACAGGGGGC TGGCCACCGT CGTCTGCTGT CCACAGTGGG TCAGGACTCA ATGATCTCGA
    GGTCTCTTCC AACCTAGAAA TTCTGTGATT CTGTGATTCT AATAACCCTG CCCGGCCGTT
    CTCTCCCAGT CAGAAGACCT CGGCGCCTGC GCCCAGTTCG AGAGCAGCAG GCAGACCAGG
    AACATGATGC CCAGCGCCAG CTGCGTCTTC CCCACCTTCA ACCTGCGGAA GCCCTCCTCG
    GAGACGGACA TTGAGAACTG GGCCTCCAAG CACTTCAACA AGCACACGCA GGGGCTCTTC
    CGTAGGAAGG TGTCCATCGC CAACATGCTG GCCTGGAGCA GCGAGTCCAT CAAGAAGCCC
    ATGATCATGA CCAACGACCG CAACGTCAAG AAGGAGGCGT GCGAGATATT TAAACTGATT
    CAGATGTACA TGGGGGACCG GCGGGCCAAG ACGGACCAAC TCAACGTGGC CTTGGAGATC
    GCCACCAAGG GCTGGAGCAT GCAGGGCCTG CGAGACGAGC TCTACATCCA GCTGTGCCGG
    CAGNNGCACA TCACCGAGAA CTTCCGATAC GAGAGCCTGG CCCGGGGCTG GGAGCTCATG
    GCCATTTGTT TGGCCTTCTT CCCCCCCACC CCCAAATTCC ATTCCTACCT AGAAGGATAT
    ATTTACAGGC ACATGGATCC GGTGAACGAC ACCAAAGTGA CACAGCACAT TAAAGAGGTC
    CTGGAAAGGA ACAGTAAGAA GAAATCCAAA TTGAGAAAGA AACCCAAGCC CTATATCGAA
    GAGCATGATG GGGTGGCCAT CAGCACCTAC GCCAAGTACT GCTACAACAA GCTGCAGAAG
    GCAGCCCTGA CCGGAGCCAA GAAGGGCCTG AAGAAGCCGA ACATCGAGGA GATCCGCCAC
    GCCAAGAACG CCGTCTTCAA CCCCTCCATG TTCGGGAGCT CCCTGCAGGA CATCATCGCC
    ATGCAGAAGG AGCGCTACCC CGACCGGCAG CTGCCCTGGG TGCAAACGCG CCTCTCCGAG
    GAGGTGCTGG CGCTCAACGG GGACCAGACC GAGGGCATCT TCAGGGTCCC CGGGGACATC
    GATGAGGTCA ACGCGCTCAA GCTGCAGGTG GACCAGTGGA AGATCCCAAC GGGCTTGGAG
    GACCCCCACG TTCCCGCGTC CCTGCTGAAG CTGTGGTACC GGGAGCTGGA GGAGCCGCTG
    ATCCCCCACG AGTTCTACGA GCAGTGCATC ACCCACTACG AGAACCCCGA GGCAGCCATC
    GCTGTCGTCC ACTCTCTGCC CAGGATCAAC AAAATGGTGC TGTGCTACCT CATCCGCTTC
    CTACAGGTGT TCGTGCAGCC GGCCAACGTG GCCGTCACCA AGATGGACGT CAATAACCTG
    GCCATGGTGA TGGCCCCCAA CTGCCTGCGC TGCCANNNNN NNNNNNNNNN NTGCCAGTCG
    GACGACCCGC GGATCATCTT CGAGAACACC CGCAAGGAGA TGTCCTTCAT CCGGGTGCTC
    ATCCAGCACC TCGACACCAG CTTCATGGAG GGCGTCCTAT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012960439.1
    CDS162..3323
    Translation

    Target ORF information:

    RefSeq Version XM_013104985.1
    Organism Anas platyrhynchos(Mallard)
    Definition Anas platyrhynchos rho GTPase-activating protein 39-like (LOC101797856), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_013104985.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGCTGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACACCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GTACTCGCGC CGCCCCTCGG GGGGCCAGCA GTCCCCCAAC
    CTTCAGACCT TCACCCCCGA GGCCGACAAC TCCGTTTTCT TCCCGGAGAN GAAGCCCTCG
    CCCTTCTTGA AGAGGGCTGA GCACGTGGGC AGCTGCTCGC CGCTGCTGGG CCGGGGCGAT
    TCCTTCTGCT CCCCGCTGCA GACGCAGCAC CGCAAGCACT CGAGCGAGTC GCAGCCCTCC
    TCGCCCCGCT ACGCCTACGA GCCGCCGCTC TACGAGGAGC CCCCCATGGA GTACCAGGCG
    CCCATCTACG ACGAGCCCCC CGTGGACATG CAGTACGAAG CCAGCGGCAG CTACAAGGCC
    GGCTCGCCCC AAAAGTCGCC CATCCGCAAG CCTCACCCCT TCCTCCAGTC GCCCAAGCAA
    GGCTCCAACT CGCCCTACCA GCAGCTGGTG CTCACCAAGC AGAAGTGTCC CGNNNNNNNN
    NNNNNNNTCA TGAGCCTGGA GTACAGCCCC GCGGGCAAGG AGTACGTCCG GCAGCTGGTC
    TACGTCGAGC AGTCGGGCTC CAGCCCCAAG ATGAAGACGG GGTTGCGCCA CAAGTACTCG
    CCCAACCCCA TCGGCGGCTC CTACTCGCTG CAGCACAGCC CCTGCCTGCT CCGTGACCAG
    CGCCTGGACG TCAAATCGGG TGACTACAGC AGCATGGAAG GACCCGAATT TNNTGGCCNN
    CCCGGGCAAC CAGCGGGCCA GGCGGCCCCG GGCGAGGACT CTATGTCGTG GTCCAGCCAG
    CAGGACACCA TGTCCTCCAC CGGCTACTCC ACTGGTACCA GTAGCAGGAG GACCCAAACC
    AGCACCAGGT CCTCACCAGT TGGGTGCTGT GCTAAATCCC AGTCACCCAC ATCCTTCTGC
    ACGTGGGGTC CAAGGGAAGA AAACCCTNNG ACAATGCCTT TTAGGGTCCC ACCTGCTCCT
    GGTGTCCACG AGAACGTGTC TGGCTCCCAA AGTCACTTGT CCCCAGCCTG GTGCTGGTGT
    CCACCAGCCT CCTCCTGGGC TTGGGGACAC CAGAAAACCG TGTGCGAAGG TGGCTTTGTG
    GACAGGGGGC TGGCCACCGT CGTCTGCTGT CCACAGTGGG TCAGGACTCA ATGATCTCGA
    GGTCTCTTCC AACCTAGAAA TTCTGTGATT CTGTGATTCT AATAACCCTG CCCGGCCGTT
    CTCTCCCAGT CAGAAGACCT CGGCGCCTGC GCCCAGTTCG AGAGCAGCAG GCAGACCAGG
    AACATGATGC CCAGCGCCAG CTGCGTCTTC CCCACCTTCA ACCTGCGGAA GCCCTCCTCG
    GAGACGGACA TTGAGAACTG GGCCTCCAAG CACTTCAACA AGCACACGCA GGGGCTCTTC
    CGTAGGAAGG TGTCCATCGC CAACATGCTG GCCTGGAGCA GCGAGTCCAT CAAGAAGCCC
    ATGATCATGA CCAACGACCG CAACGTCAAG AAGGAGGCGT GCGAGATATT TAAACTGATT
    CAGATGTACA TGGGGGACCG GCGGGCCAAG ACGGACCAAC TCAACGTGGC CTTGGAGATC
    GCCACCAAGG GCTGGAGCAT GCAGGGCCTG CGAGACGAGC TCTACATCCA GCTGTGCCGG
    CAGNNGCACA TCACCGAGAA CTTCCGATAC GAGAGCCTGG CCCGGGGCTG GGAGCTCATG
    GCCATTTGTT TGGCCTTCTT CCCCCCCACC CCCAAATTCC ATTCCTACCT AGAAGGATAT
    ATTTACAGGC ACATGGATCC GGTGAACGAC ACCAAAGTGA CACAGCACAT TAAAGAGGTC
    CTGGAAAGGA ACAGTAAGAA GAAATCCAAA TTGAGAAAGA AACCCAAGCC CTATATCGAA
    GAGCATGATG GGGTGGCCAT CAGCACCTAC GCCAAGTACT GCTACAACAA GCTGCAGAAG
    GCAGCCCTGA CCGGAGCCAA GAAGGGCCTG AAGAAGCCGA ACATCGAGGA GATCCGCCAC
    GCCAAGAACG CCGTCTTCAA CCCCTCCATG TTCGGGAGCT CCCTGCAGGA CATCATCGCC
    ATGCAGAAGG AGCGCTACCC CGACCGGCAG CTGCCCTGGG TGCAAACGCG CCTCTCCGAG
    GAGGTGCTGG CGCTCAACGG GGACCAGACC GAGGGCATCT TCAGGGTCCC CGGGGACATC
    GATGAGGTCA ACGCGCTCAA GCTGCAGGTG GACCAGTGGA AGATCCCAAC GGGCTTGGAG
    GACCCCCACG TTCCCGCGTC CCTGCTGAAG CTGTGGTACC GGGAGCTGGA GGAGCCGCTG
    ATCCCCCACG AGTTCTACGA GCAGTGCATC ACCCACTACG AGAACCCCGA GGCAGCCATC
    GCTGTCGTCC ACTCTCTGCC CAGGATCAAC AAAATGGTGC TGTGCTACCT CATCCGCTTC
    CTACAGGTGT TCGTGCAGCC GGCCAACGTG GCCGTCACCA AGATGGACGT CAATAACCTG
    GCCATGGTGA TGGCCCCCAA CTGCCTGCGC TGCCANNNNN NNNNNNNNNN NTGCCAGTCG
    GACGACCCGC GGATCATCTT CGAGAACACC CGCAAGGAGA TGTCCTTCAT CCGGGTGCTC
    ATCCAGCACC TCGACACCAG CTTCATGGAG GGCGTCCTAT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAn170646
    Clone ID Related Accession (Same CDS sequence) XM_027452804.1
    Accession Version XM_027452804.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3351bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-12-19
    Organism Anas platyrhynchos(mallard)
    Product rho GTPase-activating protein 39 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_040047.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Anas platyrhynchos Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GACGTCCTCC CTACGATGGA ACGCCGGCAC CAAGGAGCGG
    ATGCTGATCA AGGTGACCGA CCGCGAGCCC AGCTTCCTCA TGCACCAGGG CAACGGCTAC
    GCGCCCGACG GCCAACCGGG CACCCGCTCG CGCCGCCCCT CGGGGGGCCA GCAGTCCCCC
    AACCTTCAGA CCTTCACCCC CGAGGCCGAC AACTCCGTTT TCTTCCCGGA GAGGAAGCCC
    TCGCCCTTCT TGAAGAGGGC TGAGCACGTG GGCAGCTGCT CGCCGCTGCT GGGCCGGGGC
    GATTCCTTCT GCTCCCCGCT GCAGACGCAG CACCGCAAGC ACTCGAGCGA GTCGCAGCCC
    TCCTCGCCCC GCTACGCCTA CGAGCCGCCG CTCTACGAGG AGCCCCCCAT GGAGTACCAG
    GCGCCCATCT ACGACGAGCC CCCCGTGGAC ATGCAGTACG AAGCCAGCGG CAGCTACAAG
    GCCGGCTCGC CCCAAAAGTC GCCCATCCGC AAGCCTCACC CCTTCCTCCA GTCGCCCAAG
    CAAGGCTCCA ACTCGCCCTA CCAGCAGCTG GTGCTCACCA AGCAGAAGTG TCCCGACAGG
    TTCATGAGCC TGGAGTACAG CCCCGCGGGC AAGGAGTACG TCCGGCAGCT GGTCTACGTC
    GAGCAGTCGG GCTCCAGCCC CAAGATGAAG ACGGGGTTGC GCCACAAGTA CTCGCCCAAC
    CCCATCGGCG GCTCCTACTC GCTGCAGCAC AGCCCCTGCC TGCTCCGTGA CCAGCGCCTG
    GACGTCAAAT CGGGCGACTA CAGCAGCATG GAAGGACCCG AATTTTGCCC CGGGCAACCA
    GCGGGCCAGG CGGCCCCGGG CGAGGACTCT ATGTCGTGGT CCAGCCAGCA GGACACCATG
    TCCTCCACCG GCTACTCGCC CTCCACCAGG AAAAGGAAAA GCCGCAAGCC CTCGCTGCCC
    CACGAGCCCA ACGCCTCCTC CACGGACGGC TCGGGGGACC GGGAGGCTCT CGGCGAGCAG
    CCAGCGGCGG GCGAGGATCG TGCCGTGCCG GCGCGCTCGC AGATGAACCG GACGGAGAGC
    AAGGCGGCGG AGGCGGAGGC GGCGCGGGGC TTCCCCGAGC CCTTTTTGGC ACAAGCACGG
    CTGGCGTGGG AGGCACAGCA AGCTCACTAC CACATGAAGC AACGGAGCAG TTGGGATTCC
    CAAAAGGACG GCTCGGGCTA CGAGAGCGAC GGCGCGTTGC CCTTGCCCAT GCCGGGCCCG
    GTGGTGCGAG CCTTCAGCGA GGACGAGGCG CTGGCCCAGC AGGACAACAA GCACTGGAAG
    AGGAACACCT TCGAGAAGCT GGGCTTCCCC CAGATCCTGC TGGAGAAGAG CGTCTCCGTG
    CAGACCAACC TGGCATCCCC CGAGCCCTAC CTGCACCCAT CTCAGTCAGA AGACCTCGGC
    GCCTGCGCCC AGTTCGAGAG CAGCAGGCAG ACCAGGAACA TGATGCCCAG CGCCAGCTGC
    GTCTTCCCCA CCTTCAACCT GCGGAAGCCC TCCTCGGAGA CGGACATTGA GAACTGGGCC
    TCCAAGCACT TCAACAAGCA CACGCAGGGG CTCTTCCGTA GGAAGGTGTC CATCGCCAAC
    ATGCTGGCCT GGAGCAGCGA GTCCATCAAG AAGCCCATGA TCATGACCAA CGACCGCAAC
    GTCAAGAAGG AGGCGTGCGA GATATTTAAA CTGATTCAGA TGTACATGGG GGACCGGCGG
    GCCAAGACGG ACCAACTCAA CGTGGCCTTG GAGATCGCCA CCAAGGGCTG GAGCATGCAG
    GGCCTGCGAG ACGAGCTCTA CATCCAGCTG TGCCGGCAGA CCACCGAGAA CTTCCGATAC
    GAGAGCCTGG CCCGGGGCTG GGAGCTCATG GCCATTTGTT TGGCCTTCTT CCCCCCCACC
    CCCAAATTCC ATTCCTACCT AGAAGGATAT ATTTACAGGC ACATGGATCC GGTGAACGAC
    ACCAAAGTGA CACAGCACAT TAAAGAGGTC CTGGAAAGGA ACAGTAAGAA GAAATCCAAA
    TTGAGAAAGA AACCCAAGCC CTATATCGAA GAGCATGATG GGGTGGCCAT CAGCACCTAC
    GCCAAGTACT GCTACAACAA GCTGCAGAAG GCAGCCCTGA CCGGAGCCAA GAAGGGCCTG
    AAGAAGCCGA ACATCGAGGA GATCCGCCAC GCCAAGAACG CCGTCTTCAA CCCCTCCATG
    TTCGGGAGCT CCCTGCAGGA CATCATCGCC ATGCAGAAGG AGCGCTACCC CGACCGGCAG
    CTGCCCTGGG TGCAAACGCG CCTCTCCGAG GAGGTGCTGG CGCTCAACGG GGACCAGACC
    GAGGGCATCT TCAGGGTCCC CGGGGACATC GATGAGGTCA ACGCGCTCAA GCTGCAGGTG
    GACCAGTGGA AGATCCCCAC GGGCTTGGAG GACCCCCACG TTCCCGNNTC CCTGCTGAAG
    CTGTGGTACC GGGAGCTGGA GGAGCCGCTG ATCCCCCACG AGTTCTACGA GCAGTGCATC
    ACCCACTACG AGAACCCCGA GGCAGCCATC GCTGTCGTCC ACTCTCTGCC CAGGATCAAC
    AAAATGGTGC TGTGCTACCT CATCCGCTTC CTACAGGTGT TCGTGCAGCC GGCCAACGTG
    GCCGTCACCA AGATGGACGT CAATAACCTG GCCATGGTGA TGGCCCCCAA CTGCCTGCGC
    TGCCAGTCGG ACGACCCGCG GATCATCTTC GAGAACACCC GCAAGGAGAT GTCCTTCATC
    CGGGTGCTCA TCCAGCACCT CGACACCAGC TTCATGGAGG GCGTCCTATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_027308605.1
    CDS145..3495
    Translation

    Target ORF information:

    RefSeq Version XM_027452804.1
    Organism Anas platyrhynchos(mallard)
    Definition Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_027452804.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GACGTCCTCC CTACGATGGA ACGCCGGCAC CAAGGAGCGG
    ATGCTGATCA AGGTGACCGA CCGCGAGCCC AGCTTCCTCA TGCACCAGGG CAACGGCTAC
    GCGCCCGACG GCCAACCGGG CACCCGCTCG CGCCGCCCCT CGGGGGGCCA GCAGTCCCCC
    AACCTTCAGA CCTTCACCCC CGAGGCCGAC AACTCCGTTT TCTTCCCGGA GAGGAAGCCC
    TCGCCCTTCT TGAAGAGGGC TGAGCACGTG GGCAGCTGCT CGCCGCTGCT GGGCCGGGGC
    GATTCCTTCT GCTCCCCGCT GCAGACGCAG CACCGCAAGC ACTCGAGCGA GTCGCAGCCC
    TCCTCGCCCC GCTACGCCTA CGAGCCGCCG CTCTACGAGG AGCCCCCCAT GGAGTACCAG
    GCGCCCATCT ACGACGAGCC CCCCGTGGAC ATGCAGTACG AAGCCAGCGG CAGCTACAAG
    GCCGGCTCGC CCCAAAAGTC GCCCATCCGC AAGCCTCACC CCTTCCTCCA GTCGCCCAAG
    CAAGGCTCCA ACTCGCCCTA CCAGCAGCTG GTGCTCACCA AGCAGAAGTG TCCCGACAGG
    TTCATGAGCC TGGAGTACAG CCCCGCGGGC AAGGAGTACG TCCGGCAGCT GGTCTACGTC
    GAGCAGTCGG GCTCCAGCCC CAAGATGAAG ACGGGGTTGC GCCACAAGTA CTCGCCCAAC
    CCCATCGGCG GCTCCTACTC GCTGCAGCAC AGCCCCTGCC TGCTCCGTGA CCAGCGCCTG
    GACGTCAAAT CGGGCGACTA CAGCAGCATG GAAGGACCCG AATTTTGCCC CGGGCAACCA
    GCGGGCCAGG CGGCCCCGGG CGAGGACTCT ATGTCGTGGT CCAGCCAGCA GGACACCATG
    TCCTCCACCG GCTACTCGCC CTCCACCAGG AAAAGGAAAA GCCGCAAGCC CTCGCTGCCC
    CACGAGCCCA ACGCCTCCTC CACGGACGGC TCGGGGGACC GGGAGGCTCT CGGCGAGCAG
    CCAGCGGCGG GCGAGGATCG TGCCGTGCCG GCGCGCTCGC AGATGAACCG GACGGAGAGC
    AAGGCGGCGG AGGCGGAGGC GGCGCGGGGC TTCCCCGAGC CCTTTTTGGC ACAAGCACGG
    CTGGCGTGGG AGGCACAGCA AGCTCACTAC CACATGAAGC AACGGAGCAG TTGGGATTCC
    CAAAAGGACG GCTCGGGCTA CGAGAGCGAC GGCGCGTTGC CCTTGCCCAT GCCGGGCCCG
    GTGGTGCGAG CCTTCAGCGA GGACGAGGCG CTGGCCCAGC AGGACAACAA GCACTGGAAG
    AGGAACACCT TCGAGAAGCT GGGCTTCCCC CAGATCCTGC TGGAGAAGAG CGTCTCCGTG
    CAGACCAACC TGGCATCCCC CGAGCCCTAC CTGCACCCAT CTCAGTCAGA AGACCTCGGC
    GCCTGCGCCC AGTTCGAGAG CAGCAGGCAG ACCAGGAACA TGATGCCCAG CGCCAGCTGC
    GTCTTCCCCA CCTTCAACCT GCGGAAGCCC TCCTCGGAGA CGGACATTGA GAACTGGGCC
    TCCAAGCACT TCAACAAGCA CACGCAGGGG CTCTTCCGTA GGAAGGTGTC CATCGCCAAC
    ATGCTGGCCT GGAGCAGCGA GTCCATCAAG AAGCCCATGA TCATGACCAA CGACCGCAAC
    GTCAAGAAGG AGGCGTGCGA GATATTTAAA CTGATTCAGA TGTACATGGG GGACCGGCGG
    GCCAAGACGG ACCAACTCAA CGTGGCCTTG GAGATCGCCA CCAAGGGCTG GAGCATGCAG
    GGCCTGCGAG ACGAGCTCTA CATCCAGCTG TGCCGGCAGA CCACCGAGAA CTTCCGATAC
    GAGAGCCTGG CCCGGGGCTG GGAGCTCATG GCCATTTGTT TGGCCTTCTT CCCCCCCACC
    CCCAAATTCC ATTCCTACCT AGAAGGATAT ATTTACAGGC ACATGGATCC GGTGAACGAC
    ACCAAAGTGA CACAGCACAT TAAAGAGGTC CTGGAAAGGA ACAGTAAGAA GAAATCCAAA
    TTGAGAAAGA AACCCAAGCC CTATATCGAA GAGCATGATG GGGTGGCCAT CAGCACCTAC
    GCCAAGTACT GCTACAACAA GCTGCAGAAG GCAGCCCTGA CCGGAGCCAA GAAGGGCCTG
    AAGAAGCCGA ACATCGAGGA GATCCGCCAC GCCAAGAACG CCGTCTTCAA CCCCTCCATG
    TTCGGGAGCT CCCTGCAGGA CATCATCGCC ATGCAGAAGG AGCGCTACCC CGACCGGCAG
    CTGCCCTGGG TGCAAACGCG CCTCTCCGAG GAGGTGCTGG CGCTCAACGG GGACCAGACC
    GAGGGCATCT TCAGGGTCCC CGGGGACATC GATGAGGTCA ACGCGCTCAA GCTGCAGGTG
    GACCAGTGGA AGATCCCCAC GGGCTTGGAG GACCCCCACG TTCCCGNNTC CCTGCTGAAG
    CTGTGGTACC GGGAGCTGGA GGAGCCGCTG ATCCCCCACG AGTTCTACGA GCAGTGCATC
    ACCCACTACG AGAACCCCGA GGCAGCCATC GCTGTCGTCC ACTCTCTGCC CAGGATCAAC
    AAAATGGTGC TGTGCTACCT CATCCGCTTC CTACAGGTGT TCGTGCAGCC GGCCAACGTG
    GCCGTCACCA AGATGGACGT CAATAACCTG GCCATGGTGA TGGCCCCCAA CTGCCTGCGC
    TGCCAGTCGG ACGACCCGCG GATCATCTTC GAGAACACCC GCAAGGAGAT GTCCTTCATC
    CGGGTGCTCA TCCAGCACCT CGACACCAGC TTCATGGAGG GCGTCCTATA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAn170647
    Clone ID Related Accession (Same CDS sequence) XM_027452805.1
    Accession Version XM_027452805.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3270bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-12-19
    Organism Anas platyrhynchos(mallard)
    Product rho GTPase-activating protein 39 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_040047.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Anas platyrhynchos Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGG
    ACGTCCTCCC TACGATGGAA CGCCGGCACC AAGGAGCGGA TGCTGATCAA GGTGACCGAC
    CGCGAGCCCA GCTTCCTCAT GCACCAGGGC AACGGCTACG CGCCCGACGG CCAACCGGGC
    ACCCGCTCGC GCCGCCCCTC GGGGGGCCAG CAGTCCCCCA ACCTTCAGAC CTTCACCCCC
    GAGGCCGACA ACTCCGTTTT CTTCCCGGAG AGGAAGCCCT CGCCCTTCTT GAAGAGGGCT
    GAGCACGTGG GCAGCTGCTC GCCGCTGCTG GGCCGGGGCG ATTCCTTCTG CTCCCCGCTG
    CAGACGCAGC ACCGCAAGCA CTCGAGCGAG TCGCAGCCCT CCTCGCCCCG CTACGCCTAC
    GAGCCGCCGC TCTACGAGGA GCCCCCCATG GAGTACCAGG CGCCCATCTA CGACGAGCCC
    CCCGTGGACA TGCAGTACGA AGCCAGCGGC AGCTACAAGG CCGGCTCGCC CCAAAAGTCG
    CCCATCCGCA AGCCTCACCC CTTCCTCCAG TCGCCCAAGC AAGGCTCCAA CTCGCCCTAC
    CAGCAGCTGG TGCTCACCAA GCAGAAGTGT CCCGACAGGT TCATGAGCCT GGAGTACAGC
    CCCGCGGGCA AGGAGTACGT CCGGCAGCTG GTCTACGTCG AGCAGTCGGG CTCCAGCCCC
    AAGATGAAGA CGGGGTTGCG CCACAAGTAC TCGCCCAACC CCATCGGCGG CTCCTACTCG
    CTGCAGCACA GCCCCTGCCT GCTCCGTGAC CAGCGCCTGG ACGTCAAATC GGGCGACTAC
    AGCAGCATGG AAGGACCCGA ATTTTGCCCC GGGCAACCAG CGGGCCAGGC GGCCCCGGGC
    GAGGACTCTA TGTCGTGGTC CAGCCAGCAG GACACCATGT CCTCCACCGG CTACTCGCCC
    TCCACCAGGA AAAGGAAAAG CCGCAAGCCC TCGCTGCCCC ACGAGCCCAA CGCCTCCTCC
    ACGGACGGCT CGGGGGACCG GGAGGCTCTC GGCGAGCAGC CAGCGGCGGG CGAGGATCGT
    GCCGTGCCGG CGCGCTCGCA GATGAACCGG ACGGAGAGCA AGGCGGCGGA GGCGGAGGCG
    GCGCGGGGCT TCCCCGAGCC CTTTTTGGCA CAAGCACGGC TGGCGTGGGA GGCACAGCAA
    GCTCACTACC ACATGAAGCA ACGGAGCAGT TGGGATTCCC AAAAGGACGG CTCGGGCTAC
    GAGAGCGACG GCGCGTTGCC CTTGCCCATG CCGGGCCCGG TGGTGCGAGC CTTCAGCGAG
    GACGAGGCGC TGGCCCAGCA GGACAACAAG CACTGGAAGA GGAACACCTT CGAGAAGCTG
    GGCTTCCCCC AGATCCTGCT GGAGAAGAGC GTCTCCGTGC AGACCAACCT GGCATCCCCC
    GAGCCCTACC TGCACCCATC TCAGTCAGAA GACCTCGGCG CCTGCGCCCA GTTCGAGAGC
    AGCAGGCAGA CCAGGAACAT GATGCCCAGC GCCAGCTGCG TCTTCCCCAC CTTCAACCTG
    CGGAAGCCCT CCTCGGAGAC GGACATTGAG AACTGGGCCT CCAAGCACTT CAACAAGCAC
    ACGCAGGGGC TCTTCCGTAG GAAGGTGTCC ATCGCCAACA TGCTGGCCTG GAGCAGCGAG
    TCCATCAAGA AGCCCATGAT CATGACCAAC GACCGCAACG TCAAGAAGGA GGCGTGCGAG
    ATATTTAAAC TGATTCAGAT GTACATGGGG GACCGGCGGG CCAAGACGGA CCAACTCAAC
    GTGGCCTTGG AGATCGCCAC CAAGGGCTGG AGCATGCAGG GCCTGCGAGA CGAGCTCTAC
    ATCCAGCTGT GCCGGCAGAC CACCGAGAAC TTCCGATACG AGAGCCTGGC CCGGGGCTGG
    GAGCTCATGG CCATTTGTTT GGCCTTCTTC CCCCCCACCC CCAAATTCCA TTCCTACCTA
    GAAGGATATA TTTACAGGCA CATGGATCCG GTGAACGACA CCAAAGTGAC ACAGCACATT
    AAAGAGGTCC TGGAAAGGAA CAGTAAGAAG AAATCCAAAT TGAGAAAGAA ACCCAAGCCC
    TATATCGAAG AGCATGATGG GGTGGCCATC AGCACCTACG CCAAGTACTG CTACAACAAG
    CTGCAGAAGG CAGCCCTGAC CGGAGCCAAG AAGGGCCTGA AGAAGCCGAA CATCGAGGAG
    ATCCGCCACG CCAAGAACGC CGTCTTCAAC CCCTCCATGT TCGGGAGCTC CCTGCAGGAC
    ATCATCGCCA TGCAGAAGGA GCGCTACCCC GACCGGCAGC TGCCCTGGGT GCAAACGCGC
    CTCTCCGAGG AGGTGCTGGC GCTCAACGGG GACCAGACCG AGGGCATCTT CAGGGTCCCC
    GGGGACATCG ATGAGGTCAA CGCGCTCAAG CTGCAGGTGG ACCAGTGGAA GATCCCCACG
    GGCTTGGAGG ACCCCCACGT TCCCGNNTCC CTGCTGAAGC TGTGGTACCG GGAGCTGGAG
    GAGCCGCTGA TCCCCCACGA GTTCTACGAG CAGTGCATCA CCCACTACGA GAACCCCGAG
    GCAGCCATCG CTGTCGTCCA CTCTCTGCCC AGGATCAACA AAATGGTGCT GTGCTACCTC
    ATCCGCTTCC TACAGGTGTT CGTGCAGCCG GCCAACGTGG CCGTCACCAA GATGGACGTC
    AATAACCTGG CCATGGTGAT GGCCCCCAAC TGCCTGCGCT GCCAGTCGGA CGACCCGCGG
    ATCATCTTCG AGAACACCCG CAAGGAGATG TCCTTCATCC GGGTGCTCAT CCAGCACCTC
    GACACCAGCT TCATGGAGGG CGTCCTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_027308606.1
    CDS146..3415
    Translation

    Target ORF information:

    RefSeq Version XM_027452805.1
    Organism Anas platyrhynchos(mallard)
    Definition Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_027452805.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGG
    ACGTCCTCCC TACGATGGAA CGCCGGCACC AAGGAGCGGA TGCTGATCAA GGTGACCGAC
    CGCGAGCCCA GCTTCCTCAT GCACCAGGGC AACGGCTACG CGCCCGACGG CCAACCGGGC
    ACCCGCTCGC GCCGCCCCTC GGGGGGCCAG CAGTCCCCCA ACCTTCAGAC CTTCACCCCC
    GAGGCCGACA ACTCCGTTTT CTTCCCGGAG AGGAAGCCCT CGCCCTTCTT GAAGAGGGCT
    GAGCACGTGG GCAGCTGCTC GCCGCTGCTG GGCCGGGGCG ATTCCTTCTG CTCCCCGCTG
    CAGACGCAGC ACCGCAAGCA CTCGAGCGAG TCGCAGCCCT CCTCGCCCCG CTACGCCTAC
    GAGCCGCCGC TCTACGAGGA GCCCCCCATG GAGTACCAGG CGCCCATCTA CGACGAGCCC
    CCCGTGGACA TGCAGTACGA AGCCAGCGGC AGCTACAAGG CCGGCTCGCC CCAAAAGTCG
    CCCATCCGCA AGCCTCACCC CTTCCTCCAG TCGCCCAAGC AAGGCTCCAA CTCGCCCTAC
    CAGCAGCTGG TGCTCACCAA GCAGAAGTGT CCCGACAGGT TCATGAGCCT GGAGTACAGC
    CCCGCGGGCA AGGAGTACGT CCGGCAGCTG GTCTACGTCG AGCAGTCGGG CTCCAGCCCC
    AAGATGAAGA CGGGGTTGCG CCACAAGTAC TCGCCCAACC CCATCGGCGG CTCCTACTCG
    CTGCAGCACA GCCCCTGCCT GCTCCGTGAC CAGCGCCTGG ACGTCAAATC GGGCGACTAC
    AGCAGCATGG AAGGACCCGA ATTTTGCCCC GGGCAACCAG CGGGCCAGGC GGCCCCGGGC
    GAGGACTCTA TGTCGTGGTC CAGCCAGCAG GACACCATGT CCTCCACCGG CTACTCGCCC
    TCCACCAGGA AAAGGAAAAG CCGCAAGCCC TCGCTGCCCC ACGAGCCCAA CGCCTCCTCC
    ACGGACGGCT CGGGGGACCG GGAGGCTCTC GGCGAGCAGC CAGCGGCGGG CGAGGATCGT
    GCCGTGCCGG CGCGCTCGCA GATGAACCGG ACGGAGAGCA AGGCGGCGGA GGCGGAGGCG
    GCGCGGGGCT TCCCCGAGCC CTTTTTGGCA CAAGCACGGC TGGCGTGGGA GGCACAGCAA
    GCTCACTACC ACATGAAGCA ACGGAGCAGT TGGGATTCCC AAAAGGACGG CTCGGGCTAC
    GAGAGCGACG GCGCGTTGCC CTTGCCCATG CCGGGCCCGG TGGTGCGAGC CTTCAGCGAG
    GACGAGGCGC TGGCCCAGCA GGACAACAAG CACTGGAAGA GGAACACCTT CGAGAAGCTG
    GGCTTCCCCC AGATCCTGCT GGAGAAGAGC GTCTCCGTGC AGACCAACCT GGCATCCCCC
    GAGCCCTACC TGCACCCATC TCAGTCAGAA GACCTCGGCG CCTGCGCCCA GTTCGAGAGC
    AGCAGGCAGA CCAGGAACAT GATGCCCAGC GCCAGCTGCG TCTTCCCCAC CTTCAACCTG
    CGGAAGCCCT CCTCGGAGAC GGACATTGAG AACTGGGCCT CCAAGCACTT CAACAAGCAC
    ACGCAGGGGC TCTTCCGTAG GAAGGTGTCC ATCGCCAACA TGCTGGCCTG GAGCAGCGAG
    TCCATCAAGA AGCCCATGAT CATGACCAAC GACCGCAACG TCAAGAAGGA GGCGTGCGAG
    ATATTTAAAC TGATTCAGAT GTACATGGGG GACCGGCGGG CCAAGACGGA CCAACTCAAC
    GTGGCCTTGG AGATCGCCAC CAAGGGCTGG AGCATGCAGG GCCTGCGAGA CGAGCTCTAC
    ATCCAGCTGT GCCGGCAGAC CACCGAGAAC TTCCGATACG AGAGCCTGGC CCGGGGCTGG
    GAGCTCATGG CCATTTGTTT GGCCTTCTTC CCCCCCACCC CCAAATTCCA TTCCTACCTA
    GAAGGATATA TTTACAGGCA CATGGATCCG GTGAACGACA CCAAAGTGAC ACAGCACATT
    AAAGAGGTCC TGGAAAGGAA CAGTAAGAAG AAATCCAAAT TGAGAAAGAA ACCCAAGCCC
    TATATCGAAG AGCATGATGG GGTGGCCATC AGCACCTACG CCAAGTACTG CTACAACAAG
    CTGCAGAAGG CAGCCCTGAC CGGAGCCAAG AAGGGCCTGA AGAAGCCGAA CATCGAGGAG
    ATCCGCCACG CCAAGAACGC CGTCTTCAAC CCCTCCATGT TCGGGAGCTC CCTGCAGGAC
    ATCATCGCCA TGCAGAAGGA GCGCTACCCC GACCGGCAGC TGCCCTGGGT GCAAACGCGC
    CTCTCCGAGG AGGTGCTGGC GCTCAACGGG GACCAGACCG AGGGCATCTT CAGGGTCCCC
    GGGGACATCG ATGAGGTCAA CGCGCTCAAG CTGCAGGTGG ACCAGTGGAA GATCCCCACG
    GGCTTGGAGG ACCCCCACGT TCCCGNNTCC CTGCTGAAGC TGTGGTACCG GGAGCTGGAG
    GAGCCGCTGA TCCCCCACGA GTTCTACGAG CAGTGCATCA CCCACTACGA GAACCCCGAG
    GCAGCCATCG CTGTCGTCCA CTCTCTGCCC AGGATCAACA AAATGGTGCT GTGCTACCTC
    ATCCGCTTCC TACAGGTGTT CGTGCAGCCG GCCAACGTGG CCGTCACCAA GATGGACGTC
    AATAACCTGG CCATGGTGAT GGCCCCCAAC TGCCTGCGCT GCCAGTCGGA CGACCCGCGG
    ATCATCTTCG AGAACACCCG CAAGGAGATG TCCTTCATCC GGGTGCTCAT CCAGCACCTC
    GACACCAGCT TCATGGAGGG CGTCCTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAn170648
    Clone ID Related Accession (Same CDS sequence) XM_027452806.1
    Accession Version XM_027452806.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3258bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-12-19
    Organism Anas platyrhynchos(mallard)
    Product rho GTPase-activating protein 39 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_040047.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Anas platyrhynchos Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GACGTCCTCC CTACGATGGA ACGCCGGCAC CAAGGAGCGG
    ATGCTGATCA AGGTGACCGA CCGCGAGCCC AGCTTCCTCA TGCACCAGGG CAACGGCTAC
    GCGCCCGACG GCCAACCGGG CACCCGCTCG CGCCGCCCCT CGGGGGGCCA GCAGTCCCCC
    AACCTTCAGA CCTTCACCCC CGAGGCCGAC AACTCCGTTT TCTTCCCGGA GAGGAAGCCC
    TCGCCCTTCT TGAAGAGGGC TGAGCACGTG GGCAGCTGCT CGCCGCTGCT GGGCCGGGGC
    GATTCCTTCT GCTCCCCGCT GCAGACGCAG CACCGCAAGC ACTCGAGCGA GTCGCAGCCC
    TCCTCGCCCC GCTACGCCTA CGAGCCGCCG CTCTACGAGG AGCCCCCCAT GGAGTACCAG
    GCGCCCATCT ACGACGAGCC CCCCGTGGAC ATGCAGTACG AAGCCAGCGG CAGCTACAAG
    GCCGGCTCGC CCCAAAAGTC GCCCATCCGC AAGCCTCACC CCTTCCTCCA GTCGCCCAAG
    CAAGGCTCCA ACTCGCCCTA CCAGCAGCTG GTGCTCACCA AGCAGAAGTG TCCCGACAGG
    TTCATGAGCC TGGAGTACAG CCCCGCGGGC AAGGAGTACG TCCGGCAGCT GGTCTACGTC
    GAGCAGTCGG GCTCCAGCCC CAAGATGAAG ACGGGGTTGC GCCACAAGTA CTCGCCCAAC
    CCCATCGGCG GCTCCTACTC GCTGCAGCAC AGCCCCTGCC TGCTCCGTGA CCAGCGCCTG
    GACGTCAAAT CGGGCGACTA CAGCAGCATG GAAGGACCCG AATTTTGCCC CGGGCAACCA
    GCGGGCCAGG CGGCCCCGGG CGAGGACTCT ATGTCGTGGT CCAGCCAGCA GGACACCATG
    TCCTCCACCG GCTACTCGCC CTCCACCAGG AAAAGGAAAA GCCGCAAGCC CTCGCTGCCC
    CACGAGCCCA ACGCCTCCTC CACGGACGGC TCGGGGGACC GGGAGGCTCT CGGCGAGCAG
    CCAGCGGCGG GCGAGGATCG TGCCGTGCCG GCGCGCTCGC AGATGAACCG GACGGAGAGC
    AAGGCGGCGG AGGCGGAGGC GGCGCGGGGC TTCCCCGAGC CCTTTTTGGC ACAAGCACGG
    CTGGCGTGGG AGGCACAGCA AGCTCACTAC CACATGAAGC AACGGAGCAG TTGGGATTCC
    CAAAAGGACG GCTCGGGCTA CGAGAGCGAC GGCGCGTTGC CCTTGCCCAT GCCGGGCCCG
    GTGGTGCGAG CCTTCAGCGA GGACGAGGCG CTGGCCCAGC AGGACAACAA GCACTGGAAG
    AGGAACACCT TCGAGAAGCT GGGCTTCCCC CAGATCCTGC TGGAGAAGAG CGTCTCCGTG
    CAGACCAACC TGGCATCCCC CGAGCCCTAC CTGCACCCAT CTCAGTCAGA AGACCTCGGC
    GCCTGCGCCC AGTTCGAGAG CAGCAGGCAG ACCAGGAACA TGATGCCCAG CGCCAGCTGC
    GTCTTCCCCA CCTTCAACCT GCGGAAGCCC TCCTCGGAGA CGGACATTGA GAACTGGGCC
    TCCAAGCACT TCAACAAGCA CACGCAGGGG CTCTTCCGTA GGAAGGTGTC CATCGCCAAC
    ATGCTGGCCT GGAGCAGCGA GTCCATCAAG AAGCCCATGA TCATGACCAA CGACCGCAAC
    GTCAAGAAGG AGGCGTGCGA GATATTTAAA CTGATTCAGA TGTACATGGG GGACCGGCGG
    GCCAAGACGG ACCAACTCAA CGTGGCCTTG GAGATCGCCA CCAAGGGCTG GAGCATGCAG
    GGCCTGCGAG ACGAGCTCTA CATCCAGCTG TGCCGGCAGA CCACCGAGAA CTTCCGATAC
    GAGAGCCTGG CCCGGGGCTG GGAGCTCATG GCCATTTGTT TGGCCTTCTT CCCCCCCACC
    CCCAAATTCC ATTCCTACCT AGAAGGATAT ATTTACAGGC ACATGGATCC GGTGAACGAC
    ACCAAAGGGG TGGCCATCAG CACCTACGCC AAGTACTGCT ACAACAAGCT GCAGAAGGCA
    GCCCTGACCG GAGCCAAGAA GGGCCTGAAG AAGCCGAACA TCGAGGAGAT CCGCCACGCC
    AAGAACGCCG TCTTCAACCC CTCCATGTTC GGGAGCTCCC TGCAGGACAT CATCGCCATG
    CAGAAGGAGC GCTACCCCGA CCGGCAGCTG CCCTGGGTGC AAACGCGCCT CTCCGAGGAG
    GTGCTGGCGC TCAACGGGGA CCAGACCGAG GGCATCTTCA GGGTCCCCGG GGACATCGAT
    GAGGTCAACG CGCTCAAGCT GCAGGTGGAC CAGTGGAAGA TCCCCACGGG CTTGGAGGAC
    CCCCACGTTC CCGNNTCCCT GCTGAAGCTG TGGTACCGGG AGCTGGAGGA GCCGCTGATC
    CCCCACGAGT TCTACGAGCA GTGCATCACC CACTACGAGA ACCCCGAGGC AGCCATCGCT
    GTCGTCCACT CTCTGCCCAG GATCAACAAA ATGGTGCTGT GCTACCTCAT CCGCTTCCTA
    CAGGTGTTCG TGCAGCCGGC CAACGTGGCC GTCACCAAGA TGGACGTCAA TAACCTGGCC
    ATGGTGATGG CCCCCAACTG CCTGCGCTGC CAGTCGGACG ACCCGCGGAT CATCTTCGAG
    AACACCCGCA AGGAGATGTC CTTCATCCGG GTGCTCATCC AGCACCTCGA CACCAGCTTC
    ATGGAGGGCG TCCTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_027308607.1
    CDS144..3401
    Translation

    Target ORF information:

    RefSeq Version XM_027452806.1
    Organism Anas platyrhynchos(mallard)
    Definition Anas platyrhynchos Rho GTPase activating protein 39 (ARHGAP39), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_027452806.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGCCGTTTA AACCCCCCTC CTCTCTCTGC TTGCTCCCCC GCAGGCTGGA ATGGGTGGAA 
    ATCATCGAGC CTCGGACGCG GGAGCGCATG TACGCCAACC TCATCACGGG GGAGTGCGTC
    TGGGACCCGC CGGCCGGTGT GCGCATCAAG CGCACGAATG AGAACCAGTG GTGGGAGCTC
    TTCGACCCCA ACACCTCCCG CTTCTACTAC TACAATGCCA CCACGCAGCG GACGGTGTGG
    CACCGGCCGC AGAACTGCGA CATCATCCCC TTGGCCAAGC TGCAGACCTT GAAGCAGAAC
    ACGGAGTCGC CGCGAGCCTC GACGGAGAAC AGCCCCGGGC GGAGCAGCAA TGTCAGCAGG
    GAGGGCAGCA CCAGCTCCTC ATTGGAGCAG GAGCTGGAGG GCGGCGAGAA GGTGCCCGAG
    CAGACGAGGT CGGGCCGCCA GTCCACCCAG TACGCCGTGG TGAAGGAGGA AACGGAGAGT
    TCGCCGCCCT CCGGAGTGTT TGAGAAAGAA TATGACATTT ATCGGGATTA CAATGCGGAA
    GGTCAACTCC TCCACTACAG GACGTCCTCC CTACGATGGA ACGCCGGCAC CAAGGAGCGG
    ATGCTGATCA AGGTGACCGA CCGCGAGCCC AGCTTCCTCA TGCACCAGGG CAACGGCTAC
    GCGCCCGACG GCCAACCGGG CACCCGCTCG CGCCGCCCCT CGGGGGGCCA GCAGTCCCCC
    AACCTTCAGA CCTTCACCCC CGAGGCCGAC AACTCCGTTT TCTTCCCGGA GAGGAAGCCC
    TCGCCCTTCT TGAAGAGGGC TGAGCACGTG GGCAGCTGCT CGCCGCTGCT GGGCCGGGGC
    GATTCCTTCT GCTCCCCGCT GCAGACGCAG CACCGCAAGC ACTCGAGCGA GTCGCAGCCC
    TCCTCGCCCC GCTACGCCTA CGAGCCGCCG CTCTACGAGG AGCCCCCCAT GGAGTACCAG
    GCGCCCATCT ACGACGAGCC CCCCGTGGAC ATGCAGTACG AAGCCAGCGG CAGCTACAAG
    GCCGGCTCGC CCCAAAAGTC GCCCATCCGC AAGCCTCACC CCTTCCTCCA GTCGCCCAAG
    CAAGGCTCCA ACTCGCCCTA CCAGCAGCTG GTGCTCACCA AGCAGAAGTG TCCCGACAGG
    TTCATGAGCC TGGAGTACAG CCCCGCGGGC AAGGAGTACG TCCGGCAGCT GGTCTACGTC
    GAGCAGTCGG GCTCCAGCCC CAAGATGAAG ACGGGGTTGC GCCACAAGTA CTCGCCCAAC
    CCCATCGGCG GCTCCTACTC GCTGCAGCAC AGCCCCTGCC TGCTCCGTGA CCAGCGCCTG
    GACGTCAAAT CGGGCGACTA CAGCAGCATG GAAGGACCCG AATTTTGCCC CGGGCAACCA
    GCGGGCCAGG CGGCCCCGGG CGAGGACTCT ATGTCGTGGT CCAGCCAGCA GGACACCATG
    TCCTCCACCG GCTACTCGCC CTCCACCAGG AAAAGGAAAA GCCGCAAGCC CTCGCTGCCC
    CACGAGCCCA ACGCCTCCTC CACGGACGGC TCGGGGGACC GGGAGGCTCT CGGCGAGCAG
    CCAGCGGCGG GCGAGGATCG TGCCGTGCCG GCGCGCTCGC AGATGAACCG GACGGAGAGC
    AAGGCGGCGG AGGCGGAGGC GGCGCGGGGC TTCCCCGAGC CCTTTTTGGC ACAAGCACGG
    CTGGCGTGGG AGGCACAGCA AGCTCACTAC CACATGAAGC AACGGAGCAG TTGGGATTCC
    CAAAAGGACG GCTCGGGCTA CGAGAGCGAC GGCGCGTTGC CCTTGCCCAT GCCGGGCCCG
    GTGGTGCGAG CCTTCAGCGA GGACGAGGCG CTGGCCCAGC AGGACAACAA GCACTGGAAG
    AGGAACACCT TCGAGAAGCT GGGCTTCCCC CAGATCCTGC TGGAGAAGAG CGTCTCCGTG
    CAGACCAACC TGGCATCCCC CGAGCCCTAC CTGCACCCAT CTCAGTCAGA AGACCTCGGC
    GCCTGCGCCC AGTTCGAGAG CAGCAGGCAG ACCAGGAACA TGATGCCCAG CGCCAGCTGC
    GTCTTCCCCA CCTTCAACCT GCGGAAGCCC TCCTCGGAGA CGGACATTGA GAACTGGGCC
    TCCAAGCACT TCAACAAGCA CACGCAGGGG CTCTTCCGTA GGAAGGTGTC CATCGCCAAC
    ATGCTGGCCT GGAGCAGCGA GTCCATCAAG AAGCCCATGA TCATGACCAA CGACCGCAAC
    GTCAAGAAGG AGGCGTGCGA GATATTTAAA CTGATTCAGA TGTACATGGG GGACCGGCGG
    GCCAAGACGG ACCAACTCAA CGTGGCCTTG GAGATCGCCA CCAAGGGCTG GAGCATGCAG
    GGCCTGCGAG ACGAGCTCTA CATCCAGCTG TGCCGGCAGA CCACCGAGAA CTTCCGATAC
    GAGAGCCTGG CCCGGGGCTG GGAGCTCATG GCCATTTGTT TGGCCTTCTT CCCCCCCACC
    CCCAAATTCC ATTCCTACCT AGAAGGATAT ATTTACAGGC ACATGGATCC GGTGAACGAC
    ACCAAAGGGG TGGCCATCAG CACCTACGCC AAGTACTGCT ACAACAAGCT GCAGAAGGCA
    GCCCTGACCG GAGCCAAGAA GGGCCTGAAG AAGCCGAACA TCGAGGAGAT CCGCCACGCC
    AAGAACGCCG TCTTCAACCC CTCCATGTTC GGGAGCTCCC TGCAGGACAT CATCGCCATG
    CAGAAGGAGC GCTACCCCGA CCGGCAGCTG CCCTGGGTGC AAACGCGCCT CTCCGAGGAG
    GTGCTGGCGC TCAACGGGGA CCAGACCGAG GGCATCTTCA GGGTCCCCGG GGACATCGAT
    GAGGTCAACG CGCTCAAGCT GCAGGTGGAC CAGTGGAAGA TCCCCACGGG CTTGGAGGAC
    CCCCACGTTC CCGNNTCCCT GCTGAAGCTG TGGTACCGGG AGCTGGAGGA GCCGCTGATC
    CCCCACGAGT TCTACGAGCA GTGCATCACC CACTACGAGA ACCCCGAGGC AGCCATCGCT
    GTCGTCCACT CTCTGCCCAG GATCAACAAA ATGGTGCTGT GCTACCTCAT CCGCTTCCTA
    CAGGTGTTCG TGCAGCCGGC CAACGTGGCC GTCACCAAGA TGGACGTCAA TAACCTGGCC
    ATGGTGATGG CCCCCAACTG CCTGCGCTGC CAGTCGGACG ACCCGCGGAT CATCTTCGAG
    AACACCCGCA AGGAGATGTC CTTCATCCGG GTGCTCATCC AGCACCTCGA CACCAGCTTC
    ATGGAGGGCG TCCTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.