LOC105153139 cDNA ORF clone, Acromyrmex echinatior(Panamanian leafcutter ant)

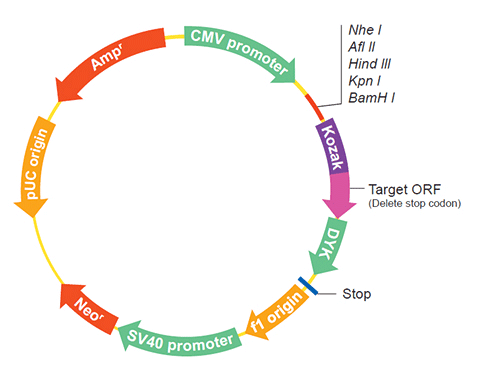
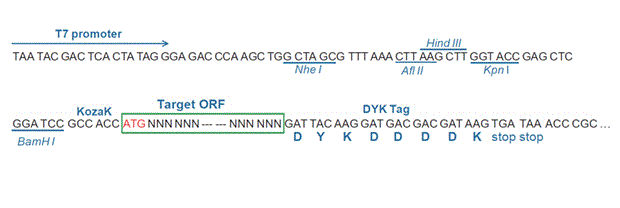
The following LOC105153139 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105153139 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAc137796 XM_011067811.1
Latest version!
Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OAc137797 XM_011067813.1
Latest version!
Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OAc137798 XM_011067814.1
Latest version!
Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAc137796
    Clone ID Related Accession (Same CDS sequence) XM_011067811.1
    Accession Version XM_011067811.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3720bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-01-12
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Product collagen alpha-2(IV) chain-like isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011627660.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Acromyrmex echinatior Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CAGCACCTAT TGGAAGCGGA TCAATGATTC AAACAAAACC AACTCGACCT
    CCTTATAGGC CTGACTCATC AGGACATCCA GGCATTCCCG GTATTCCAAG TACACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGACT CCTGGCTTCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GCATACCAGG AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATCAAGGG AGTCCTGGCA TCCCTGGTAC TCCAGGGACA
    CCTGGAATTC CAGGAATACC AGTAAAACCA GGAACACCGT CATATCCAGG GCATTCAGGG
    ACACCTGGAA TTCCAGGGAC ATCAGGAAAA CCAGGAATAC CGTCATATCC AGGACATCAA
    GGAACTCCTG GCATCCCTGG TACTCCAGGG ACACCTGGAA TTCCAGGAAT ACCAGTAAAA
    CCAGGAACAC CGTCATATCC AGGGCATTCA GGGATTCCTG GTACATCAGT GACACCAGGA
    AAACCAGGAA CACCGTCATA TCCAGAGCAT CAAGGGACTC CTGGCATCCC TAGTACTCCA
    GGGACACCTG GAATTCCAGG CATACCAGAA AAACCAGGAG CACCGTCATA TCCAGGGCAT
    CAAGGGATTC CTGGTTTCCC TGGTACTCCA GGCACACCAG GAAAACCAGG AGCACCATCA
    TATCCAGGGC ATCAAGGGAC TCCTGGCATC CCTAGTACTC CAGGGACACC TGGAATTCCA
    GGCATACCAG TAAAACCAGG AACACCGTCA TATCCAGGGC ATTCAGGGAC ACCTGGAATT
    CCAGGGACAT CAGGAAAACC AGGAATACCG TCATATCCAG GACATCAAGG AACTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGCATAC CAGGAAAACC AGGAACACCG
    TCATATCCAG GGCATCAAGG GAGTCCTGGC ATCCCTGGTA CTCCAGGGAC ACCTGGAATT
    CCAGGAATAC CAGTAAAACC AGGAACACCG TCATATCCAG GGCATCAAGG GAGTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGAATAC CAGTAAAACC AGGAACACCG
    TCATATCCAG GGCATTCAGG GACACCTGGA ATTCCAGGGA CATCAGGAAA ACCAGGAATA
    CCGTCATATC CAGGACATCA AGGAACTCCT GGCATCCCTG GTACTCCAGG GACACCTGGA
    ATTCCAGGAA TACCAGTAAA ACCAGGAACA CCGTCATATC CAGGGCATCA AGGAAGTCCT
    GGCATCCCTG GTACTCCAGG GACACCTGGA ATTCCAGGCA TACCAGGAAA ACCAGGAACA
    CCGTCATATC CAGGACATCA AGGGACTCCT GGTTTTCCTG GTACTCCAGG CATACCAGGA
    AAACCAGGAG CACCGTCATA TCCAGGACAT CAAGGGACTC CTGGCATCCC TGGTACTCCA
    GGGACACCTG GATTTCCAGG CATACCAGAA AAACCAGGAG CACCGTCATA TCCAGGGCAT
    CAAGGGACTC CTGGTTTCCC TGGTACTTCA GGCACACCAG GAAAACCAGG AACATCGTTA
    TATCCAGGGC ATCCAGGGAC TCCTGGCATC TCTGGTATTT CAGGTAAACC AGATGATTTA
    TTATATCCCG GGATTACCAC TACTCCAAAT AGGCCAAGCA TTTCTTTCAA GCCGAGTAAA
    CCAGGTTATC CAGGTTATCC TACGTATCCA GAATATACAG AAAATTCAAA GTATCCAGAA
    GGGCCAATAG GACCTGAAGG TCCAGTGGGA AATGTAGGTC CAATTGGTGA TATTGGTGGC
    ATTGGAGGTA CCGGTGGCGT TGGTCCTGAT GGTCCCGACG GACCATGGCC AACCGGTTCC
    CCAGGTCCTG ATGGACCATG GCCTGGTGAT CCAGATTATA TACCCGGAAT AAAACCAACA
    AGAAAACCTT CGCATAAAAG TTCAATAAAT CATCCTACCA TTGAATCATT TGACACAGAC
    AGATATAACT CCATCTCAAA ATATAGTTTT AATAATAAAA CTGATTCTTC GTATACGGGC
    TATACTCTAA AGGATATCAA ATTGTCGAAA TTGTCACATC CAACAAAAGT TAATACATCA
    TTATATATAA AGCATAGTCA GCATAGACCT CAATACGAAA CTCAATCCAC ATCATCAATT
    TATGGGGAAA AAGAAACTAT CTACAACGCA AATAAAATCA ATTCACTGTT GCAAACAGAT
    CTGACACCGT CATCATTGAA ATATGAGATT GAAGATTATC AATATACAGA TGTGTTAAAA
    CCGAATTTAC AATTTTATGA TCACTTGATA CATACAGAAT CACAACAAAT AAAGAAACCT
    TCGAAAAATA ACTTGAAGCA ATTTTCTATG CACGATCAGG ATCAGTATCA AAAGTCAATA
    TTTTATCCAT CTTATAACTC ACAACAGCAA AAGCCTCCTA AAGGCTCAGA TCAATCTGAT
    AAATTAAAAC AACAAGAAGA CAAATTTAAT GTGGATGGAC AATATAATAA TTCTGCCGAT
    GTGGATGGCA AATTTATTTC TAACGTGTCC TTTCAGTCGG ATGGACCTTC CTCTGCTCTA
    AACAGACAGG TAAATGCACG CCTTGAGCAG ACATTCCGGA TGAATCCCGT TCTCGACGCT
    ATACGGGTTC AGCCGCCCAG CTCCATCAAC GTCAAGCCCT TATCGTTACC TATAGGGCCA
    AATTCACAAG CATGTCCCTG TTACTTAGTC GAGCCGAATA ACAACACAAA CGTAGCAACC
    AGTTCGACTG TCACCTCTGT CATTGGGCAA TTGGGATTCA TTCCTGTTAT CTTCGTACCA
    TACTGTCCTG GCAAAGAGAT GGACAGCAAT AAGATGAAAC TTATGTTCCC GTCCGCTACT
    CCTGTTCCAT ATGCATGCGA CACATGTGAT GCACAAGACA ACAAATTTGT TGTAAAAATG
    CTCGATATAA ATCAACTTGG CAATATCGAC TATCTCAAAG AGGCATTATA TCAATCCAAT
    CTTGGCTTTT TGAATGTTCC AGTTAAGACC AACATCAAGC GAAGAAGAAA GGCGAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011066113.1
    CDS85..3804
    Translation

    Target ORF information:

    RefSeq Version XM_011067811.1
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Definition Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011067811.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CAGCACCTAT TGGAAGCGGA TCAATGATTC AAACAAAACC AACTCGACCT
    CCTTATAGGC CTGACTCATC AGGACATCCA GGCATTCCCG GTATTCCAAG TACACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGACT CCTGGCTTCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GCATACCAGG AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATCAAGGG AGTCCTGGCA TCCCTGGTAC TCCAGGGACA
    CCTGGAATTC CAGGAATACC AGTAAAACCA GGAACACCGT CATATCCAGG GCATTCAGGG
    ACACCTGGAA TTCCAGGGAC ATCAGGAAAA CCAGGAATAC CGTCATATCC AGGACATCAA
    GGAACTCCTG GCATCCCTGG TACTCCAGGG ACACCTGGAA TTCCAGGAAT ACCAGTAAAA
    CCAGGAACAC CGTCATATCC AGGGCATTCA GGGATTCCTG GTACATCAGT GACACCAGGA
    AAACCAGGAA CACCGTCATA TCCAGAGCAT CAAGGGACTC CTGGCATCCC TAGTACTCCA
    GGGACACCTG GAATTCCAGG CATACCAGAA AAACCAGGAG CACCGTCATA TCCAGGGCAT
    CAAGGGATTC CTGGTTTCCC TGGTACTCCA GGCACACCAG GAAAACCAGG AGCACCATCA
    TATCCAGGGC ATCAAGGGAC TCCTGGCATC CCTAGTACTC CAGGGACACC TGGAATTCCA
    GGCATACCAG TAAAACCAGG AACACCGTCA TATCCAGGGC ATTCAGGGAC ACCTGGAATT
    CCAGGGACAT CAGGAAAACC AGGAATACCG TCATATCCAG GACATCAAGG AACTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGCATAC CAGGAAAACC AGGAACACCG
    TCATATCCAG GGCATCAAGG GAGTCCTGGC ATCCCTGGTA CTCCAGGGAC ACCTGGAATT
    CCAGGAATAC CAGTAAAACC AGGAACACCG TCATATCCAG GGCATCAAGG GAGTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGAATAC CAGTAAAACC AGGAACACCG
    TCATATCCAG GGCATTCAGG GACACCTGGA ATTCCAGGGA CATCAGGAAA ACCAGGAATA
    CCGTCATATC CAGGACATCA AGGAACTCCT GGCATCCCTG GTACTCCAGG GACACCTGGA
    ATTCCAGGAA TACCAGTAAA ACCAGGAACA CCGTCATATC CAGGGCATCA AGGAAGTCCT
    GGCATCCCTG GTACTCCAGG GACACCTGGA ATTCCAGGCA TACCAGGAAA ACCAGGAACA
    CCGTCATATC CAGGACATCA AGGGACTCCT GGTTTTCCTG GTACTCCAGG CATACCAGGA
    AAACCAGGAG CACCGTCATA TCCAGGACAT CAAGGGACTC CTGGCATCCC TGGTACTCCA
    GGGACACCTG GATTTCCAGG CATACCAGAA AAACCAGGAG CACCGTCATA TCCAGGGCAT
    CAAGGGACTC CTGGTTTCCC TGGTACTTCA GGCACACCAG GAAAACCAGG AACATCGTTA
    TATCCAGGGC ATCCAGGGAC TCCTGGCATC TCTGGTATTT CAGGTAAACC AGATGATTTA
    TTATATCCCG GGATTACCAC TACTCCAAAT AGGCCAAGCA TTTCTTTCAA GCCGAGTAAA
    CCAGGTTATC CAGGTTATCC TACGTATCCA GAATATACAG AAAATTCAAA GTATCCAGAA
    GGGCCAATAG GACCTGAAGG TCCAGTGGGA AATGTAGGTC CAATTGGTGA TATTGGTGGC
    ATTGGAGGTA CCGGTGGCGT TGGTCCTGAT GGTCCCGACG GACCATGGCC AACCGGTTCC
    CCAGGTCCTG ATGGACCATG GCCTGGTGAT CCAGATTATA TACCCGGAAT AAAACCAACA
    AGAAAACCTT CGCATAAAAG TTCAATAAAT CATCCTACCA TTGAATCATT TGACACAGAC
    AGATATAACT CCATCTCAAA ATATAGTTTT AATAATAAAA CTGATTCTTC GTATACGGGC
    TATACTCTAA AGGATATCAA ATTGTCGAAA TTGTCACATC CAACAAAAGT TAATACATCA
    TTATATATAA AGCATAGTCA GCATAGACCT CAATACGAAA CTCAATCCAC ATCATCAATT
    TATGGGGAAA AAGAAACTAT CTACAACGCA AATAAAATCA ATTCACTGTT GCAAACAGAT
    CTGACACCGT CATCATTGAA ATATGAGATT GAAGATTATC AATATACAGA TGTGTTAAAA
    CCGAATTTAC AATTTTATGA TCACTTGATA CATACAGAAT CACAACAAAT AAAGAAACCT
    TCGAAAAATA ACTTGAAGCA ATTTTCTATG CACGATCAGG ATCAGTATCA AAAGTCAATA
    TTTTATCCAT CTTATAACTC ACAACAGCAA AAGCCTCCTA AAGGCTCAGA TCAATCTGAT
    AAATTAAAAC AACAAGAAGA CAAATTTAAT GTGGATGGAC AATATAATAA TTCTGCCGAT
    GTGGATGGCA AATTTATTTC TAACGTGTCC TTTCAGTCGG ATGGACCTTC CTCTGCTCTA
    AACAGACAGG TAAATGCACG CCTTGAGCAG ACATTCCGGA TGAATCCCGT TCTCGACGCT
    ATACGGGTTC AGCCGCCCAG CTCCATCAAC GTCAAGCCCT TATCGTTACC TATAGGGCCA
    AATTCACAAG CATGTCCCTG TTACTTAGTC GAGCCGAATA ACAACACAAA CGTAGCAACC
    AGTTCGACTG TCACCTCTGT CATTGGGCAA TTGGGATTCA TTCCTGTTAT CTTCGTACCA
    TACTGTCCTG GCAAAGAGAT GGACAGCAAT AAGATGAAAC TTATGTTCCC GTCCGCTACT
    CCTGTTCCAT ATGCATGCGA CACATGTGAT GCACAAGACA ACAAATTTGT TGTAAAAATG
    CTCGATATAA ATCAACTTGG CAATATCGAC TATCTCAAAG AGGCATTATA TCAATCCAAT
    CTTGGCTTTT TGAATGTTCC AGTTAAGACC AACATCAAGC GAAGAAGAAA GGCGAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAc137797
    Clone ID Related Accession (Same CDS sequence) XM_011067813.1
    Accession Version XM_011067813.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3717bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-01-12
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Product collagen alpha-2(IV) chain-like isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011627660.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Acromyrmex echinatior Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CACCTATTGG AAGCGGATCA ATGATTCAAA CAAAACCAAC TCGACCTCCT
    TATAGGCCTG ACTCATCAGG ACATCCAGGC ATTCCCGGTA TTCCAAGTAC ACCAGGAACA
    CCGTCATATC CAGGGCATCA AGGGACTCCT GGCTTCCCTG GTACTCCAGG GACACCTGGA
    ATTCCAGGCA TACCAGGAAA ACCAGGAACA CCGTCATATC CAGGGCATTC AGGGACACCT
    GGAATTCCAG GGACATCAGG AAAACCAGGA ATACCGTCAT ATCCAGGACA TCAAGGAACT
    CCTGGCATCC CTGGTACTCC AGGGACACCT GGAATTCCAG GAATACCAGT AAAACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGAGT CCTGGCATCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GAATACCAGT AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATTCAGGG ATTCCTGGTA CATCAGTGAC ACCAGGAAAA
    CCAGGAACAC CGTCATATCC AGAGCATCAA GGGACTCCTG GCATCCCTAG TACTCCAGGG
    ACACCTGGAA TTCCAGGCAT ACCAGAAAAA CCAGGAGCAC CGTCATATCC AGGGCATCAA
    GGGATTCCTG GTTTCCCTGG TACTCCAGGC ACACCAGGAA AACCAGGAGC ACCATCATAT
    CCAGGGCATC AAGGGACTCC TGGCATCCCT AGTACTCCAG GGACACCTGG AATTCCAGGC
    ATACCAGTAA AACCAGGAAC ACCGTCATAT CCAGGGCATT CAGGGACACC TGGAATTCCA
    GGGACATCAG GAAAACCAGG AATACCGTCA TATCCAGGAC ATCAAGGAAC TCCTGGCATC
    CCTGGTACTC CAGGGACACC TGGAATTCCA GGCATACCAG GAAAACCAGG AACACCGTCA
    TATCCAGGGC ATCAAGGGAG TCCTGGCATC CCTGGTACTC CAGGGACACC TGGAATTCCA
    GGAATACCAG TAAAACCAGG AACACCGTCA TATCCAGGGC ATCAAGGGAG TCCTGGCATC
    CCTGGTACTC CAGGGACACC TGGAATTCCA GGAATACCAG TAAAACCAGG AACACCGTCA
    TATCCAGGGC ATTCAGGGAC ACCTGGAATT CCAGGGACAT CAGGAAAACC AGGAATACCG
    TCATATCCAG GACATCAAGG AACTCCTGGC ATCCCTGGTA CTCCAGGGAC ACCTGGAATT
    CCAGGAATAC CAGTAAAACC AGGAACACCG TCATATCCAG GGCATCAAGG AAGTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGCATAC CAGGAAAACC AGGAACACCG
    TCATATCCAG GACATCAAGG GACTCCTGGT TTTCCTGGTA CTCCAGGCAT ACCAGGAAAA
    CCAGGAGCAC CGTCATATCC AGGACATCAA GGGACTCCTG GCATCCCTGG TACTCCAGGG
    ACACCTGGAT TTCCAGGCAT ACCAGAAAAA CCAGGAGCAC CGTCATATCC AGGGCATCAA
    GGGACTCCTG GTTTCCCTGG TACTTCAGGC ACACCAGGAA AACCAGGAAC ATCGTTATAT
    CCAGGGCATC CAGGGACTCC TGGCATCTCT GGTATTTCAG GTAAACCAGA TGATTTATTA
    TATCCCGGGA TTACCACTAC TCCAAATAGG CCAAGCATTT CTTTCAAGCC GAGTAAACCA
    GGTTATCCAG GTTATCCTAC GTATCCAGAA TATACAGAAA ATTCAAAGTA TCCAGAAGGG
    CCAATAGGAC CTGAAGGTCC AGTGGGAAAT GTAGGTCCAA TTGGTGATAT TGGTGGCATT
    GGAGGTACCG GTGGCGTTGG TCCTGATGGT CCCGACGGAC CATGGCCAAC CGGTTCCCCA
    GGTCCTGATG GACCATGGCC TGGTGATCCA GATTATATAC CCGGAATAAA ACCAACAAGA
    AAACCTTCGC ATAAAAGTTC AATAAATCAT CCTACCATTG AATCATTTGA CACAGACAGA
    TATAACTCCA TCTCAAAATA TAGTTTTAAT AATAAAACTG ATTCTTCGTA TACGGGCTAT
    ACTCTAAAGG ATATCAAATT GTCGAAATTG TCACATCCAA CAAAAGTTAA TACATCATTA
    TATATAAAGC ATAGTCAGCA TAGACCTCAA TACGAAACTC AATCCACATC ATCAATTTAT
    GGGGAAAAAG AAACTATCTA CAACGCAAAT AAAATCAATT CACTGTTGCA AACAGATCTG
    ACACCGTCAT CATTGAAATA TGAGATTGAA GATTATCAAT ATACAGATGT GTTAAAACCG
    AATTTACAAT TTTATGATCA CTTGATACAT ACAGAATCAC AACAAATAAA GAAACCTTCG
    AAAAATAACT TGAAGCAATT TTCTATGCAC GATCAGGATC AGTATCAAAA GTCAATATTT
    TATCCATCTT ATAACTCACA ACAGCAAAAG CCTCCTAAAG GCTCAGATCA ATCTGATAAA
    TTAAAACAAC AAGAAGACAA ATTTAATGTG GATGGACAAT ATAATAATTC TGCCGATGTG
    GATGGCAAAT TTATTTCTAA CGTGTCCTTT CAGTCGGATG GACCTTCCTC TGCTCTAAAC
    AGACAGGTAA ATGCACGCCT TGAGCAGACA TTCCGGATGA ATCCCGTTCT CGACGCTATA
    CGGGTTCAGC CGCCCAGCTC CATCAACGTC AAGCCCTTAT CGTTACCTAT AGGGCCAAAT
    TCACAAGCAT GTCCCTGTTA CTTAGTCGAG CCGAATAACA ACACAAACGT AGCAACCAGT
    TCGACTGTCA CCTCTGTCAT TGGGCAATTG GGATTCATTC CTGTTATCTT CGTACCATAC
    TGTCCTGGCA AAGAGATGGA CAGCAATAAG ATGAAACTTA TGTTCCCGTC CGCTACTCCT
    GTTCCATATG CATGCGACAC ATGTGATGCA CAAGACAACA AATTTGTTGT AAAAATGCTC
    GATATAAATC AACTTGGCAA TATCGACTAT CTCAAAGAGG CATTATATCA ATCCAATCTT
    GGCTTTTTGA ATGTTCCAGT TAAGACCAAC ATCAAGCGAA GAAGAAAGGC GAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011066115.1
    CDS85..3801
    Translation

    Target ORF information:

    RefSeq Version XM_011067813.1
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Definition Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011067813.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CACCTATTGG AAGCGGATCA ATGATTCAAA CAAAACCAAC TCGACCTCCT
    TATAGGCCTG ACTCATCAGG ACATCCAGGC ATTCCCGGTA TTCCAAGTAC ACCAGGAACA
    CCGTCATATC CAGGGCATCA AGGGACTCCT GGCTTCCCTG GTACTCCAGG GACACCTGGA
    ATTCCAGGCA TACCAGGAAA ACCAGGAACA CCGTCATATC CAGGGCATTC AGGGACACCT
    GGAATTCCAG GGACATCAGG AAAACCAGGA ATACCGTCAT ATCCAGGACA TCAAGGAACT
    CCTGGCATCC CTGGTACTCC AGGGACACCT GGAATTCCAG GAATACCAGT AAAACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGAGT CCTGGCATCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GAATACCAGT AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATTCAGGG ATTCCTGGTA CATCAGTGAC ACCAGGAAAA
    CCAGGAACAC CGTCATATCC AGAGCATCAA GGGACTCCTG GCATCCCTAG TACTCCAGGG
    ACACCTGGAA TTCCAGGCAT ACCAGAAAAA CCAGGAGCAC CGTCATATCC AGGGCATCAA
    GGGATTCCTG GTTTCCCTGG TACTCCAGGC ACACCAGGAA AACCAGGAGC ACCATCATAT
    CCAGGGCATC AAGGGACTCC TGGCATCCCT AGTACTCCAG GGACACCTGG AATTCCAGGC
    ATACCAGTAA AACCAGGAAC ACCGTCATAT CCAGGGCATT CAGGGACACC TGGAATTCCA
    GGGACATCAG GAAAACCAGG AATACCGTCA TATCCAGGAC ATCAAGGAAC TCCTGGCATC
    CCTGGTACTC CAGGGACACC TGGAATTCCA GGCATACCAG GAAAACCAGG AACACCGTCA
    TATCCAGGGC ATCAAGGGAG TCCTGGCATC CCTGGTACTC CAGGGACACC TGGAATTCCA
    GGAATACCAG TAAAACCAGG AACACCGTCA TATCCAGGGC ATCAAGGGAG TCCTGGCATC
    CCTGGTACTC CAGGGACACC TGGAATTCCA GGAATACCAG TAAAACCAGG AACACCGTCA
    TATCCAGGGC ATTCAGGGAC ACCTGGAATT CCAGGGACAT CAGGAAAACC AGGAATACCG
    TCATATCCAG GACATCAAGG AACTCCTGGC ATCCCTGGTA CTCCAGGGAC ACCTGGAATT
    CCAGGAATAC CAGTAAAACC AGGAACACCG TCATATCCAG GGCATCAAGG AAGTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGAATT CCAGGCATAC CAGGAAAACC AGGAACACCG
    TCATATCCAG GACATCAAGG GACTCCTGGT TTTCCTGGTA CTCCAGGCAT ACCAGGAAAA
    CCAGGAGCAC CGTCATATCC AGGACATCAA GGGACTCCTG GCATCCCTGG TACTCCAGGG
    ACACCTGGAT TTCCAGGCAT ACCAGAAAAA CCAGGAGCAC CGTCATATCC AGGGCATCAA
    GGGACTCCTG GTTTCCCTGG TACTTCAGGC ACACCAGGAA AACCAGGAAC ATCGTTATAT
    CCAGGGCATC CAGGGACTCC TGGCATCTCT GGTATTTCAG GTAAACCAGA TGATTTATTA
    TATCCCGGGA TTACCACTAC TCCAAATAGG CCAAGCATTT CTTTCAAGCC GAGTAAACCA
    GGTTATCCAG GTTATCCTAC GTATCCAGAA TATACAGAAA ATTCAAAGTA TCCAGAAGGG
    CCAATAGGAC CTGAAGGTCC AGTGGGAAAT GTAGGTCCAA TTGGTGATAT TGGTGGCATT
    GGAGGTACCG GTGGCGTTGG TCCTGATGGT CCCGACGGAC CATGGCCAAC CGGTTCCCCA
    GGTCCTGATG GACCATGGCC TGGTGATCCA GATTATATAC CCGGAATAAA ACCAACAAGA
    AAACCTTCGC ATAAAAGTTC AATAAATCAT CCTACCATTG AATCATTTGA CACAGACAGA
    TATAACTCCA TCTCAAAATA TAGTTTTAAT AATAAAACTG ATTCTTCGTA TACGGGCTAT
    ACTCTAAAGG ATATCAAATT GTCGAAATTG TCACATCCAA CAAAAGTTAA TACATCATTA
    TATATAAAGC ATAGTCAGCA TAGACCTCAA TACGAAACTC AATCCACATC ATCAATTTAT
    GGGGAAAAAG AAACTATCTA CAACGCAAAT AAAATCAATT CACTGTTGCA AACAGATCTG
    ACACCGTCAT CATTGAAATA TGAGATTGAA GATTATCAAT ATACAGATGT GTTAAAACCG
    AATTTACAAT TTTATGATCA CTTGATACAT ACAGAATCAC AACAAATAAA GAAACCTTCG
    AAAAATAACT TGAAGCAATT TTCTATGCAC GATCAGGATC AGTATCAAAA GTCAATATTT
    TATCCATCTT ATAACTCACA ACAGCAAAAG CCTCCTAAAG GCTCAGATCA ATCTGATAAA
    TTAAAACAAC AAGAAGACAA ATTTAATGTG GATGGACAAT ATAATAATTC TGCCGATGTG
    GATGGCAAAT TTATTTCTAA CGTGTCCTTT CAGTCGGATG GACCTTCCTC TGCTCTAAAC
    AGACAGGTAA ATGCACGCCT TGAGCAGACA TTCCGGATGA ATCCCGTTCT CGACGCTATA
    CGGGTTCAGC CGCCCAGCTC CATCAACGTC AAGCCCTTAT CGTTACCTAT AGGGCCAAAT
    TCACAAGCAT GTCCCTGTTA CTTAGTCGAG CCGAATAACA ACACAAACGT AGCAACCAGT
    TCGACTGTCA CCTCTGTCAT TGGGCAATTG GGATTCATTC CTGTTATCTT CGTACCATAC
    TGTCCTGGCA AAGAGATGGA CAGCAATAAG ATGAAACTTA TGTTCCCGTC CGCTACTCCT
    GTTCCATATG CATGCGACAC ATGTGATGCA CAAGACAACA AATTTGTTGT AAAAATGCTC
    GATATAAATC AACTTGGCAA TATCGACTAT CTCAAAGAGG CATTATATCA ATCCAATCTT
    GGCTTTTTGA ATGTTCCAGT TAAGACCAAC ATCAAGCGAA GAAGAAAGGC GAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAc137798
    Clone ID Related Accession (Same CDS sequence) XM_011067814.1
    Accession Version XM_011067814.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3315bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-01-12
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Product collagen alpha-2(IV) chain-like isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011627660.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Acromyrmex echinatior Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CAGCACCTAT TGGAAGCGGA TCAATGATTC AAACAAAACC AACTCGACCT
    CCTTATAGGC CTGACTCATC AGGACATCCA GGCATTCCCG GTATTCCAAG TACACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGACT CCTGGCTTCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GCATACCAGG AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATCAAGGG AGTCCTGGCA TCCCTGGTAC TCCAGGGACA
    CCTGGAATTC CAGGAATACC AGTAAAACCA GGAACACCGT CATATCCAGG GCATTCAGGG
    ACACCTGGAA TTCCAGGGAC ATCAGGAAAA CCAGGAATAC CGTCATATCC AGGACATCAA
    GGAACTCCTG GCATCCCTGG TACTCCAGGG ACACCTGGAA TTCCAGGAAT ACCAGTAAAA
    CCAGGAACAC CGTCATATCC AGGGCATTCA GGGATTCCTG GTACATCAGT GACACCAGGA
    AAACCAGGAA CACCGTCATA TCCAGGGCAT CAAGGGAGTC CTGGCATCCC TGGTACTCCA
    GGGACACCTG GAATTCCAGG AATACCAGTA AAACCAGGAA CACCGTCATA TCCAGGGCAT
    CAAGGGAGTC CTGGCATCCC TGGTACTCCA GGGACACCTG GAATTCCAGG AATACCAGTA
    AAACCAGGAA CACCGTCATA TCCAGGGCAT TCAGGGACAC CTGGAATTCC AGGGACATCA
    GGAAAACCAG GAATACCGTC ATATCCAGGA CATCAAGGAA CTCCTGGCAT CCCTGGTACT
    CCAGGGACAC CTGGAATTCC AGGAATACCA GTAAAACCAG GAACACCGTC ATATCCAGGG
    CATCAAGGAA GTCCTGGCAT CCCTGGTACT CCAGGGACAC CTGGAATTCC AGGCATACCA
    GGAAAACCAG GAACACCGTC ATATCCAGGA CATCAAGGGA CTCCTGGTTT TCCTGGTACT
    CCAGGCATAC CAGGAAAACC AGGAGCACCG TCATATCCAG GACATCAAGG GACTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGATTT CCAGGCATAC CAGAAAAACC AGGAGCACCG
    TCATATCCAG GGCATCAAGG GACTCCTGGT TTCCCTGGTA CTTCAGGCAC ACCAGGAAAA
    CCAGGAACAT CGTTATATCC AGGGCATCCA GGGACTCCTG GCATCTCTGG TATTTCAGGT
    AAACCAGATG ATTTATTATA TCCCGGGATT ACCACTACTC CAAATAGGCC AAGCATTTCT
    TTCAAGCCGA GTAAACCAGG TTATCCAGGT TATCCTACGT ATCCAGAATA TACAGAAAAT
    TCAAAGTATC CAGAAGGGCC AATAGGACCT GAAGGTCCAG TGGGAAATGT AGGTCCAATT
    GGTGATATTG GTGGCATTGG AGGTACCGGT GGCGTTGGTC CTGATGGTCC CGACGGACCA
    TGGCCAACCG GTTCCCCAGG TCCTGATGGA CCATGGCCTG GTGATCCAGA TTATATACCC
    GGAATAAAAC CAACAAGAAA ACCTTCGCAT AAAAGTTCAA TAAATCATCC TACCATTGAA
    TCATTTGACA CAGACAGATA TAACTCCATC TCAAAATATA GTTTTAATAA TAAAACTGAT
    TCTTCGTATA CGGGCTATAC TCTAAAGGAT ATCAAATTGT CGAAATTGTC ACATCCAACA
    AAAGTTAATA CATCATTATA TATAAAGCAT AGTCAGCATA GACCTCAATA CGAAACTCAA
    TCCACATCAT CAATTTATGG GGAAAAAGAA ACTATCTACA ACGCAAATAA AATCAATTCA
    CTGTTGCAAA CAGATCTGAC ACCGTCATCA TTGAAATATG AGATTGAAGA TTATCAATAT
    ACAGATGTGT TAAAACCGAA TTTACAATTT TATGATCACT TGATACATAC AGAATCACAA
    CAAATAAAGA AACCTTCGAA AAATAACTTG AAGCAATTTT CTATGCACGA TCAGGATCAG
    TATCAAAAGT CAATATTTTA TCCATCTTAT AACTCACAAC AGCAAAAGCC TCCTAAAGGC
    TCAGATCAAT CTGATAAATT AAAACAACAA GAAGACAAAT TTAATGTGGA TGGACAATAT
    AATAATTCTG CCGATGTGGA TGGCAAATTT ATTTCTAACG TGTCCTTTCA GTCGGATGGA
    CCTTCCTCTG CTCTAAACAG ACAGGTAAAT GCACGCCTTG AGCAGACATT CCGGATGAAT
    CCCGTTCTCG ACGCTATACG GGTTCAGCCG CCCAGCTCCA TCAACGTCAA GCCCTTATCG
    TTACCTATAG GGCCAAATTC ACAAGCATGT CCCTGTTACT TAGTCGAGCC GAATAACAAC
    ACAAACGTAG CAACCAGTTC GACTGTCACC TCTGTCATTG GGCAATTGGG ATTCATTCCT
    GTTATCTTCG TACCATACTG TCCTGGCAAA GAGATGGACA GCAATAAGAT GAAACTTATG
    TTCCCGTCCG CTACTCCTGT TCCATATGCA TGCGACACAT GTGATGCACA AGACAACAAA
    TTTGTTGTAA AAATGCTCGA TATAAATCAA CTTGGCAATA TCGACTATCT CAAAGAGGCA
    TTATATCAAT CCAATCTTGG CTTTTTGAAT GTTCCAGTTA AGACCAACAT CAAGCGAAGA
    AGAAAGGCGA AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_011066116.1
    CDS86..3400
    Translation

    Target ORF information:

    RefSeq Version XM_011067814.1
    Organism Acromyrmex echinatior(Panamanian leafcutter ant)
    Definition Acromyrmex echinatior collagen alpha-2(IV) chain-like (LOC105153139), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011067814.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    ATGCTGCGGC ATGTAACTGC AGCCCTCTTC ATCTTGGTGA TTGCTACTTC CATGTCGCAA 
    CTCACTCAGG AATTAACAAG CACCAATCGA GATGGCGATG TGATTTTAAG CATCAGCGAT
    GAACAAAAAA TTCAGTACTT AAGCCAAAAC TTCGAAGCAG ATGCATACAA ATATGGTTAC
    GATGTCAATC CACATGGACA ATTTCATCAC GAAATACGTG GCCTACATGG GATTACCTAT
    GGATGTTATG GCTATGTTGA TCCTTTTGGT CACCTAAAAA CAACGTTTTA TATCAGTGAC
    GGATGGGGTT ATCGCATTGT TCAACCAGAG AAGGACGTGG AACTTTTCCT TCACAAGCAT
    GAACATCATG AAAACGGAGA CAAACATGAT CATCACGAGC ATCATGGTGT GATTACACCA
    TGGCGAGAGT TACATTTCCC CATGGTGTGT GCGCAATACA CAAACACGAA CATTCTACCA
    AGTGAAGAAA CAGCACCTAT TGGAAGCGGA TCAATGATTC AAACAAAACC AACTCGACCT
    CCTTATAGGC CTGACTCATC AGGACATCCA GGCATTCCCG GTATTCCAAG TACACCAGGA
    ACACCGTCAT ATCCAGGGCA TCAAGGGACT CCTGGCTTCC CTGGTACTCC AGGGACACCT
    GGAATTCCAG GCATACCAGG AAAACCAGGA ACACCGTCAT ATCCAGGGCA TTCAGGGACA
    CCTGGAATTC CAGGGACATC AGGAAAACCA GGAATACCGT CATATCCAGG ACATCAAGGA
    ACTCCTGGCA TCCCTGGTAC TCCAGGGACA CCTGGAATTC CAGGAATACC AGTAAAACCA
    GGAACACCGT CATATCCAGG GCATCAAGGG AGTCCTGGCA TCCCTGGTAC TCCAGGGACA
    CCTGGAATTC CAGGAATACC AGTAAAACCA GGAACACCGT CATATCCAGG GCATTCAGGG
    ACACCTGGAA TTCCAGGGAC ATCAGGAAAA CCAGGAATAC CGTCATATCC AGGACATCAA
    GGAACTCCTG GCATCCCTGG TACTCCAGGG ACACCTGGAA TTCCAGGAAT ACCAGTAAAA
    CCAGGAACAC CGTCATATCC AGGGCATTCA GGGATTCCTG GTACATCAGT GACACCAGGA
    AAACCAGGAA CACCGTCATA TCCAGGGCAT CAAGGGAGTC CTGGCATCCC TGGTACTCCA
    GGGACACCTG GAATTCCAGG AATACCAGTA AAACCAGGAA CACCGTCATA TCCAGGGCAT
    CAAGGGAGTC CTGGCATCCC TGGTACTCCA GGGACACCTG GAATTCCAGG AATACCAGTA
    AAACCAGGAA CACCGTCATA TCCAGGGCAT TCAGGGACAC CTGGAATTCC AGGGACATCA
    GGAAAACCAG GAATACCGTC ATATCCAGGA CATCAAGGAA CTCCTGGCAT CCCTGGTACT
    CCAGGGACAC CTGGAATTCC AGGAATACCA GTAAAACCAG GAACACCGTC ATATCCAGGG
    CATCAAGGAA GTCCTGGCAT CCCTGGTACT CCAGGGACAC CTGGAATTCC AGGCATACCA
    GGAAAACCAG GAACACCGTC ATATCCAGGA CATCAAGGGA CTCCTGGTTT TCCTGGTACT
    CCAGGCATAC CAGGAAAACC AGGAGCACCG TCATATCCAG GACATCAAGG GACTCCTGGC
    ATCCCTGGTA CTCCAGGGAC ACCTGGATTT CCAGGCATAC CAGAAAAACC AGGAGCACCG
    TCATATCCAG GGCATCAAGG GACTCCTGGT TTCCCTGGTA CTTCAGGCAC ACCAGGAAAA
    CCAGGAACAT CGTTATATCC AGGGCATCCA GGGACTCCTG GCATCTCTGG TATTTCAGGT
    AAACCAGATG ATTTATTATA TCCCGGGATT ACCACTACTC CAAATAGGCC AAGCATTTCT
    TTCAAGCCGA GTAAACCAGG TTATCCAGGT TATCCTACGT ATCCAGAATA TACAGAAAAT
    TCAAAGTATC CAGAAGGGCC AATAGGACCT GAAGGTCCAG TGGGAAATGT AGGTCCAATT
    GGTGATATTG GTGGCATTGG AGGTACCGGT GGCGTTGGTC CTGATGGTCC CGACGGACCA
    TGGCCAACCG GTTCCCCAGG TCCTGATGGA CCATGGCCTG GTGATCCAGA TTATATACCC
    GGAATAAAAC CAACAAGAAA ACCTTCGCAT AAAAGTTCAA TAAATCATCC TACCATTGAA
    TCATTTGACA CAGACAGATA TAACTCCATC TCAAAATATA GTTTTAATAA TAAAACTGAT
    TCTTCGTATA CGGGCTATAC TCTAAAGGAT ATCAAATTGT CGAAATTGTC ACATCCAACA
    AAAGTTAATA CATCATTATA TATAAAGCAT AGTCAGCATA GACCTCAATA CGAAACTCAA
    TCCACATCAT CAATTTATGG GGAAAAAGAA ACTATCTACA ACGCAAATAA AATCAATTCA
    CTGTTGCAAA CAGATCTGAC ACCGTCATCA TTGAAATATG AGATTGAAGA TTATCAATAT
    ACAGATGTGT TAAAACCGAA TTTACAATTT TATGATCACT TGATACATAC AGAATCACAA
    CAAATAAAGA AACCTTCGAA AAATAACTTG AAGCAATTTT CTATGCACGA TCAGGATCAG
    TATCAAAAGT CAATATTTTA TCCATCTTAT AACTCACAAC AGCAAAAGCC TCCTAAAGGC
    TCAGATCAAT CTGATAAATT AAAACAACAA GAAGACAAAT TTAATGTGGA TGGACAATAT
    AATAATTCTG CCGATGTGGA TGGCAAATTT ATTTCTAACG TGTCCTTTCA GTCGGATGGA
    CCTTCCTCTG CTCTAAACAG ACAGGTAAAT GCACGCCTTG AGCAGACATT CCGGATGAAT
    CCCGTTCTCG ACGCTATACG GGTTCAGCCG CCCAGCTCCA TCAACGTCAA GCCCTTATCG
    TTACCTATAG GGCCAAATTC ACAAGCATGT CCCTGTTACT TAGTCGAGCC GAATAACAAC
    ACAAACGTAG CAACCAGTTC GACTGTCACC TCTGTCATTG GGCAATTGGG ATTCATTCCT
    GTTATCTTCG TACCATACTG TCCTGGCAAA GAGATGGACA GCAATAAGAT GAAACTTATG
    TTCCCGTCCG CTACTCCTGT TCCATATGCA TGCGACACAT GTGATGCACA AGACAACAAA
    TTTGTTGTAA AAATGCTCGA TATAAATCAA CTTGGCAATA TCGACTATCT CAAAGAGGCA
    TTATATCAAT CCAATCTTGG CTTTTTGAAT GTTCCAGTTA AGACCAACAT CAAGCGAAGA
    AGAAAGGCGA AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.