GRIN1 cDNA ORF clone, Taeniopygia guttata(zebra finch)

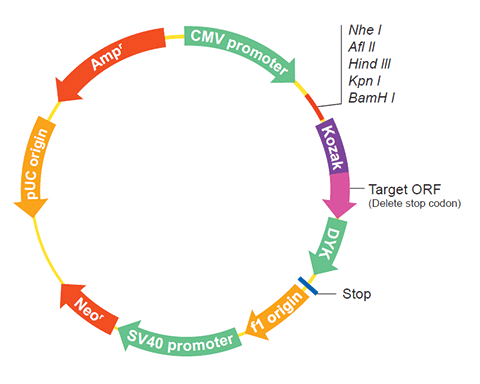
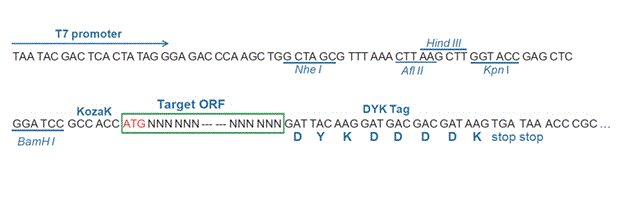
The following GRIN1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the GRIN1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OTd00665 NM_001076693.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 12-14 $510.30
$729.00
OTd30532 XM_030286295.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30533 XM_030286296.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30534 XM_030286297.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X9, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30535 XM_030286298.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X10, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30536 XM_030286299.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X11, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30537 XM_030286300.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X12, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30538 XM_030286301.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X13, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30539 XM_030286302.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X14, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30540 XM_030286303.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X15, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30541 XM_030286304.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X16, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30541 XM_030286305.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X17, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30541 XM_030286306.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X18, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30542 XM_030286307.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X19, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
OTd30527 XM_030286289.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd30528 XM_030286291.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd30529 XM_030286292.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd30530 XM_030286293.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
OTd30531 XM_030286294.1
Latest version!
Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OTd00665
    Clone ID Related Accession (Same CDS sequence) NM_001076693.1
    Accession Version NM_001076693.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2898bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-09-10
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 precursor
    Comment Comment: PROVISIONAL REFSEQ: This record has not yet been subject to final NCBI review. The reference sequence was derived from AY642587.1. ##Evidence-Data-START## Transcript exon combination :: AY642587.1, SRR8695299.22532.1 [ECO:0000332] RNAseq introns :: single sample supports all introns SAMEA4820058, SAMN07269982 [ECO:0000348] ##Evidence-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTGTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGC CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACCTGTG GCTGGTGGGG GAACGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACCGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTGATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATCGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCA
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGCGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACGAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGGATAGAA AAAGTGGTAG AGCAGAACCT GACCCTAAAA AGAAAGCCAC TTTTAGGTCC
    ATCACCTCCA CCCTGGCCTC CAGCTTCAAG AGACGTAGGT CCTCCAAGGA TACGCCCTGC
    AGAATGGTCC CTCAGGAGTG CCAGAGAGAC AGGCTGGCAC CATGGAGCCA AGACAGCCCT
    GGGAAGCTTC CACCCCACTC TGAACGTCCT AGCGCCCACC ATCACCCGAG CTGCACAGCC
    TCTCCGCGGC ACATCATCCC CACCGCCCCA GGAGGAGATG CATGTGTTCC CCATAGGCAG
    CTCCTGCAAC TCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq NP_001070161.1
    CDS16..2913
    Translation

    Target ORF information:

    RefSeq Version NM_001076693.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    NM_001076693.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTGTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGC CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACCTGTG GCTGGTGGGG GAACGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACCGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTGATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATCGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCA
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGCGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACGAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGGATAGAA AAAGTGGTAG AGCAGAACCT GACCCTAAAA AGAAAGCCAC TTTTAGGTCC
    ATCACCTCCA CCCTGGCCTC CAGCTTCAAG AGACGTAGGT CCTCCAAGGA TACGCCCTGC
    AGAATGGTCC CTCAGGAGTG CCAGAGAGAC AGGCTGGCAC CATGGAGCCA AGACAGCCCT
    GGGAAGCTTC CACCCCACTC TGAACGTCCT AGCGCCCACC ATCACCCGAG CTGCACAGCC
    TCTCCGCGGC ACATCATCCC CACCGCCCCA GGAGGAGATG CATGTGTTCC CCATAGGCAG
    CTCCTGCAAC TCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30532
    Clone ID Related Accession (Same CDS sequence) XM_030286295.1
    Accession Version XM_030286295.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2967bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGCA GTATCACCCC ACCGACATCA CTGGCCAGCT CAACCTCTCC
    GACCCCTCAG TCAGCACTGT GGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142155.1
    CDS1..2967
    Translation

    Target ORF information:

    RefSeq Version XM_030286295.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286295.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGCA GTATCACCCC ACCGACATCA CTGGCCAGCT CAACCTCTCC
    GACCCCTCAG TCAGCACTGT GGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30533
    Clone ID Related Accession (Same CDS sequence) XM_030286296.1
    Accession Version XM_030286296.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2964bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X7
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGTA TCACCCCACC GACATCACTG GCCAGCTCAA CCTCTCCGAC
    CCCTCAGTCA GCACTGTGGT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142156.1
    CDS1..2964
    Translation

    Target ORF information:

    RefSeq Version XM_030286296.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286296.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGTA TCACCCCACC GACATCACTG GCCAGCTCAA CCTCTCCGAC
    CCCTCAGTCA GCACTGTGGT GTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30534
    Clone ID Related Accession (Same CDS sequence) XM_030286297.1
    Accession Version XM_030286297.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2961bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X8
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGATA GAAAAAGTGG TAGAGCAGAA CCTGACCCTA AAAAGAAAGC CACTTTTAGG
    TCCATCACCT CCACCCTGGC CTCCAGCTTC AAGAGACGTA GGTCCTCCAA GGATACGCCC
    TGCAGAATGG TCCCTCAGGA GTGCCAGAGA GACAGGCTGG CACCATGGAG CCAAGACAGC
    CCTGGGAAGC TTCCACCCCA CTCTGAACGT CCTAGCGCCC ACCATCACCC GAGCTGCACA
    GCCTCTCCGC GGCACATCAT CCCCACCGCC CCAGGAGGAG ATGCATGTGT TCCCCATAGG
    CAGCTCCTGC AACTCGAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142157.1
    CDS1..2961
    Translation

    Target ORF information:

    RefSeq Version XM_030286297.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X9, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286297.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGATA GAAAAAGTGG TAGAGCAGAA CCTGACCCTA AAAAGAAAGC CACTTTTAGG
    TCCATCACCT CCACCCTGGC CTCCAGCTTC AAGAGACGTA GGTCCTCCAA GGATACGCCC
    TGCAGAATGG TCCCTCAGGA GTGCCAGAGA GACAGGCTGG CACCATGGAG CCAAGACAGC
    CCTGGGAAGC TTCCACCCCA CTCTGAACGT CCTAGCGCCC ACCATCACCC GAGCTGCACA
    GCCTCTCCGC GGCACATCAT CCCCACCGCC CCAGGAGGAG ATGCATGTGT TCCCCATAGG
    CAGCTCCTGC AACTCGAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30535
    Clone ID Related Accession (Same CDS sequence) XM_030286298.1
    Accession Version XM_030286298.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2850bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X9
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGCCCT GCAGAATGGT CCCTCAGGAG TGCCAGAGAG ACAGGCTGGC ACCATGGAGC
    CAAGACAGCC CTGGGAAGCT TCCACCCCAC TCTGAACGTC CTAGCGCCCA CCATCACCCG
    AGCTGCACAG CCTCTCCGCG GCACATCATC CCCACCGCCC CAGGAGGAGA TGCATGTGTT
    CCCCATAGGC AGCTCCTGCA ACTCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142158.1
    CDS1..2850
    Translation

    Target ORF information:

    RefSeq Version XM_030286298.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X10, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286298.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGCCCT GCAGAATGGT CCCTCAGGAG TGCCAGAGAG ACAGGCTGGC ACCATGGAGC
    CAAGACAGCC CTGGGAAGCT TCCACCCCAC TCTGAACGTC CTAGCGCCCA CCATCACCCG
    AGCTGCACAG CCTCTCCGCG GCACATCATC CCCACCGCCC CAGGAGGAGA TGCATGTGTT
    CCCCATAGGC AGCTCCTGCA ACTCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30536
    Clone ID Related Accession (Same CDS sequence) XM_030286299.1
    Accession Version XM_030286299.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2826bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X10
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGATA GAAAAAGTGG TAGAGCAGAA CCTGACCCTA AAAAGAAAGC CACTTTTAGG
    TCCATCACCT CCACCCTGGC CTCCAGCTTC AAGAGACGTA GGTCCTCCAA GGATACGCAG
    TATCACCCCA CCGACATCAC TGGCCAGCTC AACCTCTCCG ACCCCTCAGT CAGCACTGTG
    GTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142159.1
    CDS1..2826
    Translation

    Target ORF information:

    RefSeq Version XM_030286299.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X11, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286299.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGATA GAAAAAGTGG TAGAGCAGAA CCTGACCCTA AAAAGAAAGC CACTTTTAGG
    TCCATCACCT CCACCCTGGC CTCCAGCTTC AAGAGACGTA GGTCCTCCAA GGATACGCAG
    TATCACCCCA CCGACATCAC TGGCCAGCTC AACCTCTCCG ACCCCTCAGT CAGCACTGTG
    GTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30537
    Clone ID Related Accession (Same CDS sequence) XM_030286300.1
    Accession Version XM_030286300.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2763bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X11
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGGATAGAA AAAGTGGTAG AGCAGAACCT GACCCTAAAA AGAAAGCCAC TTTTAGGTCC
    ATCACCTCCA CCCTGGCCTC CAGCTTCAAG AGACGTAGGT CCTCCAAGGA TACGCAGTAT
    CACCCCACCG ACATCACTGG CCAGCTCAAC CTCTCCGACC CCTCAGTCAG CACTGTGGTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142160.1
    CDS1..2763
    Translation

    Target ORF information:

    RefSeq Version XM_030286300.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X12, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286300.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGGATAGAA AAAGTGGTAG AGCAGAACCT GACCCTAAAA AGAAAGCCAC TTTTAGGTCC
    ATCACCTCCA CCCTGGCCTC CAGCTTCAAG AGACGTAGGT CCTCCAAGGA TACGCAGTAT
    CACCCCACCG ACATCACTGG CCAGCTCAAC CTCTCCGACC CCTCAGTCAG CACTGTGGTG
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30538
    Clone ID Related Accession (Same CDS sequence) XM_030286301.1
    Accession Version XM_030286301.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2748bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X12
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GGGGTGTTTT GCTCCCTCTC
    CTGAGACACC ACTCCAGAAA TGTCAGGCCC GAGGGCTGCA GGCAGCAAGG ACAGCACAGA
    GCTGTGTGTG TGGCTGTGCC TCCTGATGAG CCAAACCGGA GCACCAGGGC TGCGTTCTGG
    CACAAACGGC CCCAGGGTCC TGGGGATGGG GTCTGCTCTG GGGCTCGCTG TGCCTGTCCC
    CTGCATCGCT GCAGCTCAGT GCCCTGTGCC CCCCAGAGCT GGCACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142161.1
    CDS194..2941
    Translation

    Target ORF information:

    RefSeq Version XM_030286301.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X13, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286301.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GGGGTGTTTT GCTCCCTCTC
    CTGAGACACC ACTCCAGAAA TGTCAGGCCC GAGGGCTGCA GGCAGCAAGG ACAGCACAGA
    GCTGTGTGTG TGGCTGTGCC TCCTGATGAG CCAAACCGGA GCACCAGGGC TGCGTTCTGG
    CACAAACGGC CCCAGGGTCC TGGGGATGGG GTCTGCTCTG GGGCTCGCTG TGCCTGTCCC
    CTGCATCGCT GCAGCTCAGT GCCCTGTGCC CCCCAGAGCT GGCACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30539
    Clone ID Related Accession (Same CDS sequence) XM_030286302.1
    Accession Version XM_030286302.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2715bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X13
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGCAGT ATCACCCCAC CGACATCACT GGCCAGCTCA ACCTCTCCGA CCCCTCAGTC
    AGCACTGTGG TGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142162.1
    CDS1..2715
    Translation

    Target ORF information:

    RefSeq Version XM_030286302.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X14, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286302.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGCAGT ATCACCCCAC CGACATCACT GGCCAGCTCA ACCTCTCCGA CCCCTCAGTC
    AGCACTGTGG TGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30540
    Clone ID Related Accession (Same CDS sequence) XM_030286303.1
    Accession Version XM_030286303.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2712bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X14
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGTATC ACCCCACCGA CATCACTGGC CAGCTCAACC TCTCCGACCC CTCAGTCAGC
    ACTGTGGTGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142163.1
    CDS1..2712
    Translation

    Target ORF information:

    RefSeq Version XM_030286303.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X15, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286303.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGTATC ACCCCACCGA CATCACTGGC CAGCTCAACC TCTCCGACCC CTCAGTCAGC
    ACTGTGGTGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30541
    Clone ID Related Accession (Same CDS sequence) XM_030286304.1 , XM_030286306.1 , XM_030286305.1
    Accession Version XM_030286304.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2667bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X15
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142164.1
    CDS1..2667
    Translation

    Target ORF information:

    RefSeq Version XM_030286304.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X16, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286304.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30541
    Clone ID Related Accession (Same CDS sequence) XM_030286304.1 , XM_030286306.1 , XM_030286305.1
    Accession Version XM_030286306.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2667bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X15
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142166.1
    CDS1..2667
    Translation

    Target ORF information:

    RefSeq Version XM_030286306.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X18, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286306.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30541
    Clone ID Related Accession (Same CDS sequence) XM_030286304.1 , XM_030286306.1 , XM_030286305.1
    Accession Version XM_030286305.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2667bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X15
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142165.1
    CDS1..2667
    Translation

    Target ORF information:

    RefSeq Version XM_030286305.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X17, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286305.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGGAGG AAACGTCAGA GCACTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30542
    Clone ID Related Accession (Same CDS sequence) XM_030286307.1
    Accession Version XM_030286307.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2652bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X16
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGCAGTATC ACCCCACCGA CATCACTGGC CAGCTCAACC TCTCCGACCC CTCAGTCAGC
    ACTGTGGTGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142167.1
    CDS1..2652
    Translation

    Target ORF information:

    RefSeq Version XM_030286307.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X19, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286307.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGCAGTATC ACCCCACCGA CATCACTGGC CAGCTCAACC TCTCCGACCC CTCAGTCAGC
    ACTGTGGTGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30527
    Clone ID Related Accession (Same CDS sequence) XM_030286289.1
    Accession Version XM_030286289.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3213bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGC CCTGCAGAAT GGTCCCTCAG GAGTGCCAGA GAGACAGGCT GGCACCATGG
    AGCCAAGACA GCCCTGGGAA GCTTCCACCC CACTCTGAAC GTCCTAGCGC CCACCATCAC
    CCGAGCTGCA CAGCCTCTCC GCGGCACATC ATCCCCACCG CCCCAGGAGG AGATGCATGT
    GTTCCCCATA GGCAGCTCCT GCAACTCGAG TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142149.1
    CDS194..3406
    Translation

    Target ORF information:

    RefSeq Version XM_030286289.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286289.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGC CCTGCAGAAT GGTCCCTCAG GAGTGCCAGA GAGACAGGCT GGCACCATGG
    AGCCAAGACA GCCCTGGGAA GCTTCCACCC CACTCTGAAC GTCCTAGCGC CCACCATCAC
    CCGAGCTGCA CAGCCTCTCC GCGGCACATC ATCCCCACCG CCCCAGGAGG AGATGCATGT
    GTTCCCCATA GGCAGCTCCT GCAACTCGAG TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30528
    Clone ID Related Accession (Same CDS sequence) XM_030286291.1
    Accession Version XM_030286291.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3150bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGAGAGAAC TGAGAAGGAG GAGCAAATGT ATCCCCGAGC ATGCTCTACG CACCAGCGGG
    ATACATTTTG GTTACCCCCG TGCGGTAGCA GAGCCAGACC TGGTCACTCC GTCCCCCGTC
    GGAAAGGTCA CACTCATTGG CACGAAAGCA ATTGGGGAGG ACTCGTTGCC AGCGCCCAGC
    GCCGAGCGCG GCCGGGCCCC CCGGCCCGCG GCCCCCGCAC CATGGCGGCT GGTGCTCCCA
    GCCTGCGCCA ACCAGGATAG AAAAAGTGGT AGAGCAGAAC CTGACCCTAA AAAGAAAGCC
    ACTTTTAGGT CCATCACCTC CACCCTGGCC TCCAGCTTCA AGAGACGTAG GTCCTCCAAG
    GATACGCCCT GCAGAATGGT CCCTCAGGAG TGCCAGAGAG ACAGGCTGGC ACCATGGAGC
    CAAGACAGCC CTGGGAAGCT TCCACCCCAC TCTGAACGTC CTAGCGCCCA CCATCACCCG
    AGCTGCACAG CCTCTCCGCG GCACATCATC CCCACCGCCC CAGGAGGAGA TGCATGTGTT
    CCCCATAGGC AGCTCCTGCA ACTCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142151.1
    CDS1..3150
    Translation

    Target ORF information:

    RefSeq Version XM_030286291.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286291.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG GCTGAGAAAG TGCTTCAGTT TGACCCTGGG
    ACCAAAAATG TGACAGCGCT GCTGCTGGAG GCCAAGGAGC TGGAGGCCAG GGTCATCATC
    CTCTCTGCCA GCGAGGATGA CGCGGCCACG GTGTACAGAT CAGCAGCCAT GCTCAACATG
    ACGGGCTCGG GCTACGTGTG GCTGGTGGGG GAGCGGGAGA TCTCGGGCAA TGCCCTGCGC
    TACGCCCCGG ACGGAGTGAT CGGTCTGCAG CTCATCAACG GCAAGAACGA GTCAGCCCAC
    ATCAGTGACG CTGTCGCCGT GGTGGCCCAG GCCGTGCACG ACTTGTTTGA GAAGGAGAAT
    ATCACAGACC CACCGCGGGG CTGCGTGGGC AACACCAACA TCTGGAAGAC AGGACCGCTT
    TTTAAGAGGG TGTTGATGTC CTCCAAGTAT TCCGAAGGTG TCACAGGCCG GGTGGAGTTC
    AATGAGGACG GGGACAGGAA ATTTGCCAAC TACAGCATCA TGAACCTGCA GAATCGGAAA
    CTGGTCCAGG TTGGGATTTA CAACGGCAGC AATGTCCTGA CCAACGACAG GAAGATCATC
    TGGCCAGGCG GGGAAACTGA GAAACCTCAA GGTTATCAGA TGTCAACCAA GTTGAAGATT
    GTGACCATCC ACCAAGAGCC CTTTGTGTAT GTGAAGCCCA CTCAGGCAGA TGGGACGTGC
    AGGGAGGAAT TCACTATCAA TGGAGATCCT GTCAAAAAAG TCTTCTGCAC TGGACCCAAC
    GAGACCATCC CAGGCCGTCC CACCGTGGCA CTGTGCTGCT ACGGCTTCTG CATCGACCTG
    CTCATCCGCC TGGCAGGCGT GATGAACTTC ACCTATGAGG TTCACCTGGT GGCTGATGGT
    AAATTTGGTA CCCAAGAGCG GGTGAACAAC AGCAACAAGA AGGAGTGGAA CGGGATGATG
    GGGGAGCTGC TGAGTGGCCA GGCTGACATG ATTGTGGCTC CCCTCACCAT CAACAACGAG
    CGGGCTCAGT ACATTGAGTT CTCCAAGCCC TTCAAGTACC AGGGCCTCAC CATCCTCGTG
    AAGAAGGAAA TCCCCCGCAG CACCCTGGAC TCGTTCATGC AGCCCTTCCA GAGCACGCTC
    TGGCTGCTGG TGGGGCTGTC TGTGCACGTG GTGGCAGTGA TGTTGTACCT CCTAGACCGA
    TTCAGCCCAT TTGGCCGGTT CAAAGTAAAC AGTGAGGAGG AGGAAGAAGA TGCCCTGACT
    CTCTCCTCAG CCATGTGGTT CTCCTGGGGA GTCCTGCTGA ACTCTGGCAT TGGAGAAGGT
    GCTCCCCGGA GTTTCTCTGC CCGTATCCTT GGCATGGTGT GGGCTGGCTT TGCTATGATC
    ATTGTGGCTT CATACACTGC CAACCTGGCA GCTTTCCTGG TGTTAGACCG ACCTGAGGAG
    AGGATCACAG GCATTAACGA CCCCCGGCTG CGCAACCCCT CGGATAAGTT CATCTACGCC
    ACGGTGAAGC AGAGCTCCGT GGACATCTAC TTCCGACGGC AGGTGGAGCT GAGCACCATG
    TACAGGCACA TGGAGAAGCA CAACTACGAG AGCGCTGCCG AGGCCATCCA GGCAGTGAGG
    GACAACAAGC TCCACGCCTT CATCTGGGAC TCGGCGGTGC TGGAGTTCGA GGCCTCCCAG
    AAGTGTGACC TGGTGACAAC GGGGGAGCTC TTCTTCCGCT CCGGCTTCGG GATCGGGATG
    CGCAAGGACA GCCCCTGGAA GCAGAACGTC TCCCTGGCCA TCCTCAAGTC CCACGAGAAC
    GGCTTCATGG AGGATTTGGA CAAGACTTGG GTGAGGTATC AAGAGTGTGA TTCCCGTAGC
    AATGCCCCAG CAACACTCAC CTTTGAAAAT ATGGCAGGTG TGTTTATGCT GGTGGCTGGA
    GGTATTGTTG CCGGGATATT TTTAATATTC ATAGAGATAG CTTACAAAAG GCATAAGGAC
    GCGCGGAGGA AGCAGATGCA GCTGGCGTTT GCGGCCGTTA ATGTGTGGAG GAAAAACCTG
    CAGAGAGAAC TGAGAAGGAG GAGCAAATGT ATCCCCGAGC ATGCTCTACG CACCAGCGGG
    ATACATTTTG GTTACCCCCG TGCGGTAGCA GAGCCAGACC TGGTCACTCC GTCCCCCGTC
    GGAAAGGTCA CACTCATTGG CACGAAAGCA ATTGGGGAGG ACTCGTTGCC AGCGCCCAGC
    GCCGAGCGCG GCCGGGCCCC CCGGCCCGCG GCCCCCGCAC CATGGCGGCT GGTGCTCCCA
    GCCTGCGCCA ACCAGGATAG AAAAAGTGGT AGAGCAGAAC CTGACCCTAA AAAGAAAGCC
    ACTTTTAGGT CCATCACCTC CACCCTGGCC TCCAGCTTCA AGAGACGTAG GTCCTCCAAG
    GATACGCCCT GCAGAATGGT CCCTCAGGAG TGCCAGAGAG ACAGGCTGGC ACCATGGAGC
    CAAGACAGCC CTGGGAAGCT TCCACCCCAC TCTGAACGTC CTAGCGCCCA CCATCACCCG
    AGCTGCACAG CCTCTCCGCG GCACATCATC CCCACCGCCC CAGGAGGAGA TGCATGTGTT
    CCCCATAGGC AGCTCCTGCA ACTCGAGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30529
    Clone ID Related Accession (Same CDS sequence) XM_030286292.1
    Accession Version XM_030286292.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3102bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGCC CTGCAGAATG GTCCCTCAGG AGTGCCAGAG AGACAGGCTG
    GCACCATGGA GCCAAGACAG CCCTGGGAAG CTTCCACCCC ACTCTGAACG TCCTAGCGCC
    CACCATCACC CGAGCTGCAC AGCCTCTCCG CGGCACATCA TCCCCACCGC CCCAGGAGGA
    GATGCATGTG TTCCCCATAG GCAGCTCCTG CAACTCGAGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142152.1
    CDS1..3102
    Translation

    Target ORF information:

    RefSeq Version XM_030286292.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286292.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGCC CTGCAGAATG GTCCCTCAGG AGTGCCAGAG AGACAGGCTG
    GCACCATGGA GCCAAGACAG CCCTGGGAAG CTTCCACCCC ACTCTGAACG TCCTAGCGCC
    CACCATCACC CGAGCTGCAC AGCCTCTCCG CGGCACATCA TCCCCACCGC CCCAGGAGGA
    GATGCATGTG TTCCCCATAG GCAGCTCCTG CAACTCGAGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30530
    Clone ID Related Accession (Same CDS sequence) XM_030286293.1
    Accession Version XM_030286293.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3078bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGC AGTATCACCC CACCGACATC ACTGGCCAGC TCAACCTCTC CGACCCCTCA
    GTCAGCACTG TGGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142153.1
    CDS1..3078
    Translation

    Target ORF information:

    RefSeq Version XM_030286293.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286293.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGC AGTATCACCC CACCGACATC ACTGGCCAGC TCAACCTCTC CGACCCCTCA
    GTCAGCACTG TGGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OTd30531
    Clone ID Related Accession (Same CDS sequence) XM_030286294.1
    Accession Version XM_030286294.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3075bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-08
    Organism Taeniopygia guttata(zebra finch)
    Product glutamate receptor ionotropic, NMDA 1 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_044229.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Taeniopygia guttata Annotation Release 104 Annotation Version :: 104 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGT ATCACCCCAC CGACATCACT GGCCAGCTCA ACCTCTCCGA CCCCTCAGTC
    AGCACTGTGG TGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030142154.1
    CDS1..3075
    Translation

    Target ORF information:

    RefSeq Version XM_030286294.1
    Organism Taeniopygia guttata(zebra finch)
    Definition Taeniopygia guttata glutamate ionotropic receptor NMDA type subunit 1 (GRIN1), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030286294.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    ATGAGCACCA TGCGGCTGCT GCTGCTCGCC CTCCTCTTCT CCTCGTCCTT CGCCCGCGCC 
    GGCTGCGACC CTAAGATCGT CAATATCGGC GCGGTGCTGA GCACCAAGAA GCACGAGCAG
    ATCTTCCGCG AGGCGGTGAA CCAGGCCAAC AAGCGGCACG GCACCTGGAA GCTTCAGCTC
    AACGCCACCT CCGTCACCCA CAAGCCCAAT GCCATCCAGA TGGCCCTCTC CGTCTGCGAG
    GACCTCATCT CCAGCCAGGT CTATGCAATA TTAGTTAGTC ACCCTCCTGC TCCCAACGAT
    CACCTAACAC CAACACCTGT ATCATACACA GCTGGCTTCT ACAGGATCCC TGTCATTGGT
    CTGACAACAC GCATGTCTAT ATATTCTGAT AAGAGCATCC ACCTGTCCTT TTTGCGCACG
    GTCCCACCCT ACTCTCACCA GGCCAACGTC TGGTTTGAGA TGATGAGAGT CTTCAACTGG
    AACCACGTCA TTCTGATAGT CAGCGACGAC CACGAGGGTC GTGCTGCACA AAAGAAGCTG
    GAGACCCTCC TGGAGGAGAA AGAGTCCAAG AGTAAAAAAA GGAACTATGA AAACCTCGAC
    CAACTTTCCT ATGACAACAA GCGAGGACCC AAGGCTGAGA AAGTGCTTCA GTTTGACCCT
    GGGACCAAAA ATGTGACAGC GCTGCTGCTG GAGGCCAAGG AGCTGGAGGC CAGGGTCATC
    ATCCTCTCTG CCAGCGAGGA TGACGCGGCC ACGGTGTACA GATCAGCAGC CATGCTCAAC
    ATGACGGGCT CGGGCTACGT GTGGCTGGTG GGGGAGCGGG AGATCTCGGG CAATGCCCTG
    CGCTACGCCC CGGACGGAGT GATCGGTCTG CAGCTCATCA ACGGCAAGAA CGAGTCAGCC
    CACATCAGTG ACGCTGTCGC CGTGGTGGCC CAGGCCGTGC ACGACTTGTT TGAGAAGGAG
    AATATCACAG ACCCACCGCG GGGCTGCGTG GGCAACACCA ACATCTGGAA GACAGGACCG
    CTTTTTAAGA GGGTGTTGAT GTCCTCCAAG TATTCCGAAG GTGTCACAGG CCGGGTGGAG
    TTCAATGAGG ACGGGGACAG GAAATTTGCC AACTACAGCA TCATGAACCT GCAGAATCGG
    AAACTGGTCC AGGTTGGGAT TTACAACGGC AGCAATGTCC TGACCAACGA CAGGAAGATC
    ATCTGGCCAG GCGGGGAAAC TGAGAAACCT CAAGGTTATC AGATGTCAAC CAAGTTGAAG
    ATTGTGACCA TCCACCAAGA GCCCTTTGTG TATGTGAAGC CCACTCAGGC AGATGGGACG
    TGCAGGGAGG AATTCACTAT CAATGGAGAT CCTGTCAAAA AAGTCTTCTG CACTGGACCC
    AACGAGACCA TCCCAGGCCG TCCCACCGTG GCACTGTGCT GCTACGGCTT CTGCATCGAC
    CTGCTCATCC GCCTGGCAGG CGTGATGAAC TTCACCTATG AGGTTCACCT GGTGGCTGAT
    GGTAAATTTG GTACCCAAGA GCGGGTGAAC AACAGCAACA AGAAGGAGTG GAACGGGATG
    ATGGGGGAGC TGCTGAGTGG CCAGGCTGAC ATGATTGTGG CTCCCCTCAC CATCAACAAC
    GAGCGGGCTC AGTACATTGA GTTCTCCAAG CCCTTCAAGT ACCAGGGCCT CACCATCCTC
    GTGAAGAAGG AAATCCCCCG CAGCACCCTG GACTCGTTCA TGCAGCCCTT CCAGAGCACG
    CTCTGGCTGC TGGTGGGGCT GTCTGTGCAC GTGGTGGCAG TGATGTTGTA CCTCCTAGAC
    CGATTCAGCC CATTTGGCCG GTTCAAAGTA AACAGTGAGG AGGAGGAAGA AGATGCCCTG
    ACTCTCTCCT CAGCCATGTG GTTCTCCTGG GGAGTCCTGC TGAACTCTGG CATTGGAGAA
    GGTGCTCCCC GGAGTTTCTC TGCCCGTATC CTTGGCATGG TGTGGGCTGG CTTTGCTATG
    ATCATTGTGG CTTCATACAC TGCCAACCTG GCAGCTTTCC TGGTGTTAGA CCGACCTGAG
    GAGAGGATCA CAGGCATTAA CGACCCCCGG CTGCGCAACC CCTCGGATAA GTTCATCTAC
    GCCACGGTGA AGCAGAGCTC CGTGGACATC TACTTCCGAC GGCAGGTGGA GCTGAGCACC
    ATGTACAGGC ACATGGAGAA GCACAACTAC GAGAGCGCTG CCGAGGCCAT CCAGGCAGTG
    AGGGACAACA AGCTCCACGC CTTCATCTGG GACTCGGCGG TGCTGGAGTT CGAGGCCTCC
    CAGAAGTGTG ACCTGGTGAC AACGGGGGAG CTCTTCTTCC GCTCCGGCTT CGGGATCGGG
    ATGCGCAAGG ACAGCCCCTG GAAGCAGAAC GTCTCCCTGG CCATCCTCAA GTCCCACGAG
    AACGGCTTCA TGGAGGATTT GGACAAGACT TGGGTGAGGT ATCAAGAGTG TGATTCCCGT
    AGCAATGCCC CAGCAACACT CACCTTTGAA AATATGGCAG GTGTGTTTAT GCTGGTGGCT
    GGAGGTATTG TTGCCGGGAT ATTTTTAATA TTCATAGAGA TAGCTTACAA AAGGCATAAG
    GACGCGCGGA GGAAGCAGAT GCAGCTGGCG TTTGCGGCCG TTAATGTGTG GAGGAAAAAC
    CTGCAGAGAG AACTGAGAAG GAGGAGCAAA TGTATCCCCG AGCATGCTCT ACGCACCAGC
    GGGATACATT TTGGTTACCC CCGTGCGGTA GCAGAGCCAG ACCTGGTCAC TCCGTCCCCC
    GTCGGAAAGG TCACACTCAT TGGCACGAAA GCAATTGGGG AGGACTCGTT GCCAGCGCCC
    AGCGCCGAGC GCGGCCGGGC CCCCCGGCCC GCGGCCCCCG CACCATGGCG GCTGGTGCTC
    CCAGCCTGCG CCAACCAGGA TAGAAAAAGT GGTAGAGCAG AACCTGACCC TAAAAAGAAA
    GCCACTTTTA GGTCCATCAC CTCCACCCTG GCCTCCAGCT TCAAGAGACG TAGGTCCTCC
    AAGGATACGT ATCACCCCAC CGACATCACT GGCCAGCTCA ACCTCTCCGA CCCCTCAGTC
    AGCACTGTGG TGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.