RAP1GAP2 cDNA ORF clone, Pongo abelii(Sumatran orangutan)

The following RAP1GAP2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the RAP1GAP2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OSa12882 XM_002826829.2
Latest version!
Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 12-14 $426.30
$609.00
OSa12883 XM_003778705.1
Latest version!
Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 12-14 $426.30
$609.00
OSa172857 XM_024235608.1
Latest version!
Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $307.30
$439.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OSa12882
    Clone ID Related Accession (Same CDS sequence) XM_002826829.2
    Accession Version XM_002826829.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2193bp)
    Protein sequence
    SNP
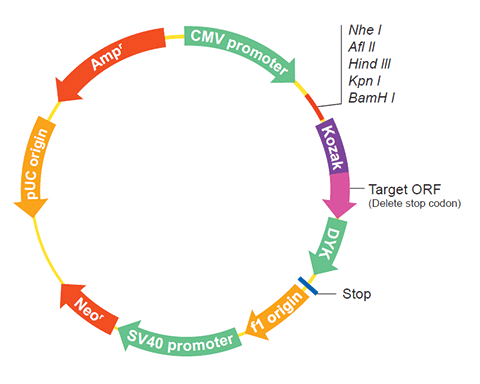
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
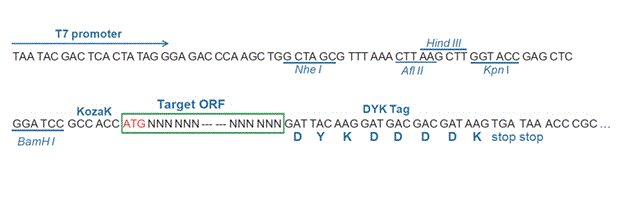
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-09-22
    Organism Pongo abelii(Sumatran orangutan)
    Product rap1 GTPase-activating protein 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002888489.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Jul 17, 2012 this sequence version replaced XM_002826829.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pongo abelii Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTTTGGCC GGAAGCGCAG TGTCTCCTTT GGGGGCTTTG GATGGATCGA CAAGACCATG 
    CTGGCAAGTC TGAAGGTCAA GAAGCAGGAG CTGGCCAACA GCTCGGATGT GACCCTCCCA
    GACCGGCCGC TGTCCCCTCC TCTCACGGCA CCTCCCACCA TGAAGTCGTC GGAGTTCTTT
    GAGATGCTGG AGAAAATGCA GGGGATCAAG CTTGAAGAGC AGAAGCCGGG ACCCCAGAAG
    AACAAGGATG ACTATATCCC ATACCCCAGC ATCGACGAGG TTGTGGAGAA GGGAGGCCCA
    TACCCTCAGG TCATCCTGCC ACAGTTTGGG GGCTATTGGA TCGAGGACCC GGAGAATGTG
    GGCACCCCAA CATCACTGGG GAGCAGCATC TGTGAGGAGG AGGAAGAGGA CAACCTCAGC
    CCCAACACGT TTGGCTACAA GCTCGAGTGC AAGGGTGAAG CCAGGGCCTA CCGGAGGCAC
    TTCCTGGGGA AGGATCATCT AAACTTTTAC TGTACTGGCA GCAGCCTGGG GAACTTGATC
    CTGTCCGTCA AGTGCGAGGA AGCAGAGGGG ATCGAGTACC TTCGGATCAT CCTCAGGTCC
    AAACTGAAGA CGGTACATGA GAGGATCCCC TTGGCTGGAC TGAGCAAGCT TCCCAGTGTC
    CCTCAGATTG CAAAGGCTTT CTGTGATGAT GCAGTGGGAC TGAGATTCAA CCCTGTCCTG
    TACCCCAAGG CCTCCCAAAT GATTGTGTCC TATGATGAGC ATGAAGTCAA CAACACATTC
    AAATTCGGAG TCATTTATCA AAAAGCCAGG CAGACCCTGG AGGAGGAGCT ATTTGGGAAC
    AATGAGGAGA GCCCAGCTTT TAAGGAGTTC TTGGACCTGC TGGGGGACAC GATCACACTG
    CAGGATTTCA AAGGTTTCCG AGGAGGCCTG GATGTGACCC ACGGACAGAC AGGGGTGGAA
    TCAGTGTACA CGACATTCCG GGACAGGGAG ATCATGTTTC ACGTTTCCAC AAAGCTGCCA
    TTTACCGAGG GAGACGCCCA GCAGCTCCAG AGAAAGAGAC ACATTGGAAA TGACATTGTG
    GCCATCATCT TCCAAGAGGA AAACACGCCG TTTGTCCCAG ACATGATAGC CTCCAATTTC
    TTACATGCCT ACATCGTCGT GCAGATCGAG ACCCCGGGCA CAGAGACCCC ATCCTACAAG
    GTCTCTGTCA CTGCGCGGGA AGATGTGCCC ACCTTTGGTC CACCTCTGCC CAGCCCCCCC
    GTTTTCCAGA AGGGCCCAGA GTTCAGGGAG TTTCTGCTCA CTAAGCTCAC CAATGCTGAG
    AACGCCTGCT GCAAGTCGGA CAAGTTTGCA AAGTTGGAGG ACCGGACCAG GGCTGCCCTC
    CTGGACAACC TTCACGATGA GCTCCACGCC CACACACAGG CCATGCTGGG ACTGGGCCCA
    GAGGAGGACA AGTTTGAGAA TGGAGGCCAC GGGGGGTTCC TGGAGTCTTT TAAGAGGGCC
    ATCCGTGTAC GCAGCCACTC CATGGAGACC ATGGTGGGCG GCCAGAAGAA GTCGCACAGT
    GGGGGCATCC CTGGCAGCCT CAGCGGGGGC ATCTCTCACA ACAGCATGGA GGTCACCAAG
    ACCACCTTCT CGCCTCCAGT GGTGGCGGCA ACGGTGAAGA ACCAGTCACG GAGTCCCATC
    AAGCGACGCT CGGGGCTCTT CCCCCGCCTG CACACGGGCT CAGAAGGCCA GGGCGACAGC
    CGGGCACGAT GTGACAGCAC ATCCAGCACA CCCAAGACCC CGGATGGTGG ACACTCCTCT
    CAGGAGATAA AGTCTGAGAC CTCATCCAAT CCCAGCTCTC CGGAAATCTG CCCCAACAAG
    GAGAAGCCCT TCATGAAGTT GAAGGAAAAC GGCCGCGCCA TCTCCCGCTC CTCCTCCAGC
    ACCAGCAGCG TCAGCAGCAC TGCAGGGGAG GGCGAGGCCA TGGAGGAGGG CGACAGTGGG
    GGCAGCCAGC CATCCACAAC CTCACCCTTC AAGCAGGAGG TGTTTGTCTA CAGCCCGTCC
    CCGAGCAGTG AGAGCCCCAG CCTGGGGGCA GCTGCCACCC CGATCATCAT GAGCCGGAGT
    CCCACAGATG CCAAAAGCAG AAACTCCCCG AGATCGAACC TGAAATTCCG CTTTGACAAG
    CTCAGCCATG CCAGCTCTGG TGCGGGTCAC TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_002826875.1
    CDS85..2277
    Translation

    Target ORF information:

    RefSeq Version XM_002826829.2
    Organism Pongo abelii(Sumatran orangutan)
    Definition Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_002826829.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGTTTGGCC GGAAGCGCAG TGTCTCCTTT GGGGGCTTTG GATGGATCGA CAAGACCATG 
    CTGGCAAGTC TGAAGGTCAA GAAGCAGGAG CTGGCCAACA GCTCGGATGT GACCCTCCCA
    GACCGGCCGC TGTCCCCTCC TCTCACGGCA CCTCCCACCA TGAAGTCGTC GGAGTTCTTT
    GAGATGCTGG AGAAAATGCA GGGGATCAAG CTTGAAGAGC AGAAGCCGGG ACCCCAGAAG
    AACAAGGATG ACTATATCCC ATACCCCAGC ATCGACGAGG TTGTGGAGAA GGGAGGCCCA
    TACCCTCAGG TCATCCTGCC ACAGTTTGGG GGCTATTGGA TCGAGGACCC GGAGAATGTG
    GGCACCCCAA CATCACTGGG GAGCAGCATC TGTGAGGAGG AGGAAGAGGA CAACCTCAGC
    CCCAACACGT TTGGCTACAA GCTCGAGTGC AAGGGTGAAG CCAGGGCCTA CCGGAGGCAC
    TTCCTGGGGA AGGATCATCT AAACTTTTAC TGTACTGGCA GCAGCCTGGG GAACTTGATC
    CTGTCCGTCA AGTGCGAGGA AGCAGAGGGG ATCGAGTACC TTCGGATCAT CCTCAGGTCC
    AAACTGAAGA CGGTACATGA GAGGATCCCC TTGGCTGGAC TGAGCAAGCT TCCCAGTGTC
    CCTCAGATTG CAAAGGCTTT CTGTGATGAT GCAGTGGGAC TGAGATTCAA CCCTGTCCTG
    TACCCCAAGG CCTCCCAAAT GATTGTGTCC TATGATGAGC ATGAAGTCAA CAACACATTC
    AAATTCGGAG TCATTTATCA AAAAGCCAGG CAGACCCTGG AGGAGGAGCT ATTTGGGAAC
    AATGAGGAGA GCCCAGCTTT TAAGGAGTTC TTGGACCTGC TGGGGGACAC GATCACACTG
    CAGGATTTCA AAGGTTTCCG AGGAGGCCTG GATGTGACCC ACGGACAGAC AGGGGTGGAA
    TCAGTGTACA CGACATTCCG GGACAGGGAG ATCATGTTTC ACGTTTCCAC AAAGCTGCCA
    TTTACCGAGG GAGACGCCCA GCAGCTCCAG AGAAAGAGAC ACATTGGAAA TGACATTGTG
    GCCATCATCT TCCAAGAGGA AAACACGCCG TTTGTCCCAG ACATGATAGC CTCCAATTTC
    TTACATGCCT ACATCGTCGT GCAGATCGAG ACCCCGGGCA CAGAGACCCC ATCCTACAAG
    GTCTCTGTCA CTGCGCGGGA AGATGTGCCC ACCTTTGGTC CACCTCTGCC CAGCCCCCCC
    GTTTTCCAGA AGGGCCCAGA GTTCAGGGAG TTTCTGCTCA CTAAGCTCAC CAATGCTGAG
    AACGCCTGCT GCAAGTCGGA CAAGTTTGCA AAGTTGGAGG ACCGGACCAG GGCTGCCCTC
    CTGGACAACC TTCACGATGA GCTCCACGCC CACACACAGG CCATGCTGGG ACTGGGCCCA
    GAGGAGGACA AGTTTGAGAA TGGAGGCCAC GGGGGGTTCC TGGAGTCTTT TAAGAGGGCC
    ATCCGTGTAC GCAGCCACTC CATGGAGACC ATGGTGGGCG GCCAGAAGAA GTCGCACAGT
    GGGGGCATCC CTGGCAGCCT CAGCGGGGGC ATCTCTCACA ACAGCATGGA GGTCACCAAG
    ACCACCTTCT CGCCTCCAGT GGTGGCGGCA ACGGTGAAGA ACCAGTCACG GAGTCCCATC
    AAGCGACGCT CGGGGCTCTT CCCCCGCCTG CACACGGGCT CAGAAGGCCA GGGCGACAGC
    CGGGCACGAT GTGACAGCAC ATCCAGCACA CCCAAGACCC CGGATGGTGG ACACTCCTCT
    CAGGAGATAA AGTCTGAGAC CTCATCCAAT CCCAGCTCTC CGGAAATCTG CCCCAACAAG
    GAGAAGCCCT TCATGAAGTT GAAGGAAAAC GGCCGCGCCA TCTCCCGCTC CTCCTCCAGC
    ACCAGCAGCG TCAGCAGCAC TGCAGGGGAG GGCGAGGCCA TGGAGGAGGG CGACAGTGGG
    GGCAGCCAGC CATCCACAAC CTCACCCTTC AAGCAGGAGG TGTTTGTCTA CAGCCCGTCC
    CCGAGCAGTG AGAGCCCCAG CCTGGGGGCA GCTGCCACCC CGATCATCAT GAGCCGGAGT
    CCCACAGATG CCAAAAGCAG AAACTCCCCG AGATCGAACC TGAAATTCCG CTTTGACAAG
    CTCAGCCATG CCAGCTCTGG TGCGGGTCAC TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OSa12883
    Clone ID Related Accession (Same CDS sequence) XM_003778705.1
    Accession Version XM_003778705.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2148bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-09-22
    Organism Pongo abelii(Sumatran orangutan)
    Product rap1 GTPase-activating protein 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_002888489.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pongo abelii Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTTTGGCC GGAAGCGCAG TGTCTCCTTT GGGGGCTTTG GATGGATCGA CAAGACCATG 
    CTGGCAAGTC TGAAGGTCAA GAAGCAGGAG CTGGCCAACA GCTCGGATGT GACCCTCCCA
    GACCGGCCGC TGTCCCCTCC TCTCACGGCA CCTCCCACCA TGAAGTCGTC GGAGTTCTTT
    GAGATGCTGG AGAAAATGCA GGATGACTAT ATCCCATACC CCAGCATCGA CGAGGTTGTG
    GAGAAGGGAG GCCCATACCC TCAGGTCATC CTGCCACAGT TTGGGGGCTA TTGGATCGAG
    GACCCGGAGA ATGTGGGCAC CCCAACATCA CTGGGGAGCA GCATCTGTGA GGAGGAGGAA
    GAGGACAACC TCAGCCCCAA CACGTTTGGC TACAAGCTCG AGTGCAAGGG TGAAGCCAGG
    GCCTACCGGA GGCACTTCCT GGGGAAGGAT CATCTAAACT TTTACTGTAC TGGCAGCAGC
    CTGGGGAACT TGATCCTGTC CGTCAAGTGC GAGGAAGCAG AGGGGATCGA GTACCTTCGG
    ATCATCCTCA GGTCCAAACT GAAGACGGTA CATGAGAGGA TCCCCTTGGC TGGACTGAGC
    AAGCTTCCCA GTGTCCCTCA GATTGCAAAG GCTTTCTGTG ATGATGCAGT GGGACTGAGA
    TTCAACCCTG TCCTGTACCC CAAGGCCTCC CAAATGATTG TGTCCTATGA TGAGCATGAA
    GTCAACAACA CATTCAAATT CGGAGTCATT TATCAAAAAG CCAGGCAGAC CCTGGAGGAG
    GAGCTATTTG GGAACAATGA GGAGAGCCCA GCTTTTAAGG AGTTCTTGGA CCTGCTGGGG
    GACACGATCA CACTGCAGGA TTTCAAAGGT TTCCGAGGAG GCCTGGATGT GACCCACGGA
    CAGACAGGGG TGGAATCAGT GTACACGACA TTCCGGGACA GGGAGATCAT GTTTCACGTT
    TCCACAAAGC TGCCATTTAC CGAGGGAGAC GCCCAGCAGC TCCAGAGAAA GAGACACATT
    GGAAATGACA TTGTGGCCAT CATCTTCCAA GAGGAAAACA CGCCGTTTGT CCCAGACATG
    ATAGCCTCCA ATTTCTTACA TGCCTACATC GTCGTGCAGA TCGAGACCCC GGGCACAGAG
    ACCCCATCCT ACAAGGTCTC TGTCACTGCG CGGGAAGATG TGCCCACCTT TGGTCCACCT
    CTGCCCAGCC CCCCCGTTTT CCAGAAGGGC CCAGAGTTCA GGGAGTTTCT GCTCACTAAG
    CTCACCAATG CTGAGAACGC CTGCTGCAAG TCGGACAAGT TTGCAAAGTT GGAGGACCGG
    ACCAGGGCTG CCCTCCTGGA CAACCTTCAC GATGAGCTCC ACGCCCACAC ACAGGCCATG
    CTGGGACTGG GCCCAGAGGA GGACAAGTTT GAGAATGGAG GCCACGGGGG GTTCCTGGAG
    TCTTTTAAGA GGGCCATCCG TGTACGCAGC CACTCCATGG AGACCATGGT GGGCGGCCAG
    AAGAAGTCGC ACAGTGGGGG CATCCCTGGC AGCCTCAGCG GGGGCATCTC TCACAACAGC
    ATGGAGGTCA CCAAGACCAC CTTCTCGCCT CCAGTGGTGG CGGCAACGGT GAAGAACCAG
    TCACGGAGTC CCATCAAGCG ACGCTCGGGG CTCTTCCCCC GCCTGCACAC GGGCTCAGAA
    GGCCAGGGCG ACAGCCGGGC ACGATGTGAC AGCACATCCA GCACACCCAA GACCCCGGAT
    GGTGGACACT CCTCTCAGGA GATAAAGTCT GAGACCTCAT CCAATCCCAG CTCTCCGGAA
    ATCTGCCCCA ACAAGGAGAA GCCCTTCATG AAGTTGAAGG AAAACGGCCG CGCCATCTCC
    CGCTCCTCCT CCAGCACCAG CAGCGTCAGC AGCACTGCAG GGGAGGGCGA GGCCATGGAG
    GAGGGCGACA GTGGGGGCAG CCAGCCATCC ACAACCTCAC CCTTCAAGCA GGAGGTGTTT
    GTCTACAGCC CGTCCCCGAG CAGTGAGAGC CCCAGCCTGG GGGCAGCTGC CACCCCGATC
    ATCATGAGCC GGAGTCCCAC AGATGCCAAA AGCAGAAACT CCCCGAGATC GAACCTGAAA
    TTCCGCTTTG ACAAGCTCAG CCATGCCAGC TCTGGTGCGG GTCACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003778753.1
    CDS85..2232
    Translation

    Target ORF information:

    RefSeq Version XM_003778705.1
    Organism Pongo abelii(Sumatran orangutan)
    Definition Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003778705.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTTTGGCC GGAAGCGCAG TGTCTCCTTT GGGGGCTTTG GATGGATCGA CAAGACCATG 
    CTGGCAAGTC TGAAGGTCAA GAAGCAGGAG CTGGCCAACA GCTCGGATGT GACCCTCCCA
    GACCGGCCGC TGTCCCCTCC TCTCACGGCA CCTCCCACCA TGAAGTCGTC GGAGTTCTTT
    GAGATGCTGG AGAAAATGCA GGATGACTAT ATCCCATACC CCAGCATCGA CGAGGTTGTG
    GAGAAGGGAG GCCCATACCC TCAGGTCATC CTGCCACAGT TTGGGGGCTA TTGGATCGAG
    GACCCGGAGA ATGTGGGCAC CCCAACATCA CTGGGGAGCA GCATCTGTGA GGAGGAGGAA
    GAGGACAACC TCAGCCCCAA CACGTTTGGC TACAAGCTCG AGTGCAAGGG TGAAGCCAGG
    GCCTACCGGA GGCACTTCCT GGGGAAGGAT CATCTAAACT TTTACTGTAC TGGCAGCAGC
    CTGGGGAACT TGATCCTGTC CGTCAAGTGC GAGGAAGCAG AGGGGATCGA GTACCTTCGG
    ATCATCCTCA GGTCCAAACT GAAGACGGTA CATGAGAGGA TCCCCTTGGC TGGACTGAGC
    AAGCTTCCCA GTGTCCCTCA GATTGCAAAG GCTTTCTGTG ATGATGCAGT GGGACTGAGA
    TTCAACCCTG TCCTGTACCC CAAGGCCTCC CAAATGATTG TGTCCTATGA TGAGCATGAA
    GTCAACAACA CATTCAAATT CGGAGTCATT TATCAAAAAG CCAGGCAGAC CCTGGAGGAG
    GAGCTATTTG GGAACAATGA GGAGAGCCCA GCTTTTAAGG AGTTCTTGGA CCTGCTGGGG
    GACACGATCA CACTGCAGGA TTTCAAAGGT TTCCGAGGAG GCCTGGATGT GACCCACGGA
    CAGACAGGGG TGGAATCAGT GTACACGACA TTCCGGGACA GGGAGATCAT GTTTCACGTT
    TCCACAAAGC TGCCATTTAC CGAGGGAGAC GCCCAGCAGC TCCAGAGAAA GAGACACATT
    GGAAATGACA TTGTGGCCAT CATCTTCCAA GAGGAAAACA CGCCGTTTGT CCCAGACATG
    ATAGCCTCCA ATTTCTTACA TGCCTACATC GTCGTGCAGA TCGAGACCCC GGGCACAGAG
    ACCCCATCCT ACAAGGTCTC TGTCACTGCG CGGGAAGATG TGCCCACCTT TGGTCCACCT
    CTGCCCAGCC CCCCCGTTTT CCAGAAGGGC CCAGAGTTCA GGGAGTTTCT GCTCACTAAG
    CTCACCAATG CTGAGAACGC CTGCTGCAAG TCGGACAAGT TTGCAAAGTT GGAGGACCGG
    ACCAGGGCTG CCCTCCTGGA CAACCTTCAC GATGAGCTCC ACGCCCACAC ACAGGCCATG
    CTGGGACTGG GCCCAGAGGA GGACAAGTTT GAGAATGGAG GCCACGGGGG GTTCCTGGAG
    TCTTTTAAGA GGGCCATCCG TGTACGCAGC CACTCCATGG AGACCATGGT GGGCGGCCAG
    AAGAAGTCGC ACAGTGGGGG CATCCCTGGC AGCCTCAGCG GGGGCATCTC TCACAACAGC
    ATGGAGGTCA CCAAGACCAC CTTCTCGCCT CCAGTGGTGG CGGCAACGGT GAAGAACCAG
    TCACGGAGTC CCATCAAGCG ACGCTCGGGG CTCTTCCCCC GCCTGCACAC GGGCTCAGAA
    GGCCAGGGCG ACAGCCGGGC ACGATGTGAC AGCACATCCA GCACACCCAA GACCCCGGAT
    GGTGGACACT CCTCTCAGGA GATAAAGTCT GAGACCTCAT CCAATCCCAG CTCTCCGGAA
    ATCTGCCCCA ACAAGGAGAA GCCCTTCATG AAGTTGAAGG AAAACGGCCG CGCCATCTCC
    CGCTCCTCCT CCAGCACCAG CAGCGTCAGC AGCACTGCAG GGGAGGGCGA GGCCATGGAG
    GAGGGCGACA GTGGGGGCAG CCAGCCATCC ACAACCTCAC CCTTCAAGCA GGAGGTGTTT
    GTCTACAGCC CGTCCCCGAG CAGTGAGAGC CCCAGCCTGG GGGCAGCTGC CACCCCGATC
    ATCATGAGCC GGAGTCCCAC AGATGCCAAA AGCAGAAACT CCCCGAGATC GAACCTGAAA
    TTCCGCTTTG ACAAGCTCAG CCATGCCAGC TCTGGTGCGG GTCACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OSa172857
    Clone ID Related Accession (Same CDS sequence) XM_024235608.1
    Accession Version XM_024235608.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1965bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-02-27
    Organism Pongo abelii(Sumatran orangutan)
    Product rap1 GTPase-activating protein 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_036920.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pongo abelii Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGCTGGAGA AAATGCAGGA TGACTATATC CCATACCCCA GCATCGACGA GGTTGTGGAG 
    AAGGGAGGCC CATACCCTCA GGTCATCCTG CCACAGTTTG GGGGCTATTG GATCGAGGAC
    CCGGAGAATG TGGGCACCCC AACATCACTG GGGAGCAGCA TCTGTGAGGA GGAGGAAGAG
    GACAACCTCA GCCCCAACAC GTTTGGCTAC AAGCTCGAGT GCAAGGGTGA AGCCAGGGCC
    TACCGGAGGC ACTTCCTGGG GAAGGATCAT CTAAACTTTT ACTGTACTGG CAGCAGCCTG
    GGGAACTTGA TCCTGTCCGT CAAGTGCGAG GAAGCAGAGG GGATCGAGTA CCTTCGGATC
    ATCCTCAGGT CCAAACTGAA GACGGTACAT GAGAGGATCC CCTTGGCTGG ACTGAGCAAG
    CTTCCCAGTG TCCCTCAGAT TGCAAAGGCT TTCTGTGATG ATGCAGTGGG ACTGAGATTC
    AACCCTGTCC TGTACCCCAA GGCCTCCCAA ATGATTGTGT CCTATGATGA GCATGAAGTC
    AACAACACAT TCAAATTCGG AGTCATTTAT CAAAAAGCCA GGCAGACCCT GGAGGAGGAG
    CTATTTGGGA ACAATGAGGA GAGCCCAGCT TTTAAGGAGT TCTTGGACCT GCTGGGGGAC
    ACGATCACAC TGCAGGATTT CAAAGGTTTC CGAGGAGGCC TGGATGTGAC CCACGGACAG
    ACAGGGGTGG AATCAGTGTA CACGACATTC CGGGACAGGG AGATCATGTT TCACGTTTCC
    ACAAAGCTGC CATTTACCGA GGGAGACGCC CAGCAGCTCC AGAGAAAGAG ACACATTGGA
    AATGACATTG TGGCCATCAT CTTCCAAGAG GAAAACACGC CGTTTGTCCC AGACATGATA
    GCCTCCAATT TCTTACATGC CTACATCGTC GTGCAGATCG AGACCCCGGG CACAGAGACC
    CCATCCTACA AGGTCTCTGT CACTGCGCGG GAAGATGTGC CCACCTTTGG TCCACCTCTG
    CCCAGCCCCC CCGTTTTCCA GAAGGGCCCA GAGTTCAGGG AGTTTCTGCT CACTAAGCTC
    ACCAATGCTG AGAACGCCTG CTGCAAGTCG GACAAGTTTG CAAAGTTGGA GGACCGGACC
    AGGGCTGCCC TCCTGGACAA CCTTCACGAT GAGCTCCACG CCCACACACA GGCCATGCTG
    GGACTGGGCC CAGAGGAGGA CAAGTTTGAG AATGGAGGCC ACGGGGGGTT CCTGGAGTCT
    TTTAAGAGGG CCATCCGTGT ACGCAGCCAC TCCATGGAGA CCATGGTGGG CGGCCAGAAG
    AAGTCGCACA GTGGGGGCAT CCCTGGCAGC CTCAGCGGGG GCATCTCTCA CAACAGCATG
    GAGGTCACCA AGACCACCTT CTCGCCTCCA GTGGTGGCGG CAACGGTGAA GAACCAGTCA
    CGGAGTCCCA TCAAGCGACG CTCGGGGCTC TTCCCCCGCC TGCACACGGG CTCAGAAGGC
    CAGGGCGACA GCCGGGCACG ATGTGACAGC ACATCCAGCA CACCCAAGAC CCCGGATGGT
    GGACACTCCT CTCAGGAGAT AAAGTCTGAG ACCTCATCCA ATCCCAGCTC TCCGGAAATC
    TGCCCCAACA AGGAGAAGCC CTTCATGAAG TTGAAGGAAA ACGGCCGCGC CATCTCCCGC
    TCCTCCTCCA GCACCAGCAG CGTCAGCAGC ACTGCAGGGG AGGGCGAGGC CATGGAGGAG
    GGCGACAGTG GGGGCAGCCA GCCATCCACA ACCTCACCCT TCAAGCAGGA GGTGTTTGTC
    TACAGCCCGT CCCCGAGCAG TGAGAGCCCC AGCCTGGGGG CAGCTGCCAC CCCGATCATC
    ATGAGCCGGA GTCCCACAGA TGCCAAAAGC AGAAACTCCC CGAGATCGAA CCTGAAATTC
    CGCTTTGACA AGCTCAGCCA TGCCAGCTCT GGTGCGGGTC ACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_024091376.1
    CDS15..1979
    Translation

    Target ORF information:

    RefSeq Version XM_024235608.1
    Organism Pongo abelii(Sumatran orangutan)
    Definition Pongo abelii RAP1 GTPase activating protein 2 (RAP1GAP2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_024235608.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGCTGGAGA AAATGCAGGA TGACTATATC CCATACCCCA GCATCGACGA GGTTGTGGAG 
    AAGGGAGGCC CATACCCTCA GGTCATCCTG CCACAGTTTG GGGGCTATTG GATCGAGGAC
    CCGGAGAATG TGGGCACCCC AACATCACTG GGGAGCAGCA TCTGTGAGGA GGAGGAAGAG
    GACAACCTCA GCCCCAACAC GTTTGGCTAC AAGCTCGAGT GCAAGGGTGA AGCCAGGGCC
    TACCGGAGGC ACTTCCTGGG GAAGGATCAT CTAAACTTTT ACTGTACTGG CAGCAGCCTG
    GGGAACTTGA TCCTGTCCGT CAAGTGCGAG GAAGCAGAGG GGATCGAGTA CCTTCGGATC
    ATCCTCAGGT CCAAACTGAA GACGGTACAT GAGAGGATCC CCTTGGCTGG ACTGAGCAAG
    CTTCCCAGTG TCCCTCAGAT TGCAAAGGCT TTCTGTGATG ATGCAGTGGG ACTGAGATTC
    AACCCTGTCC TGTACCCCAA GGCCTCCCAA ATGATTGTGT CCTATGATGA GCATGAAGTC
    AACAACACAT TCAAATTCGG AGTCATTTAT CAAAAAGCCA GGCAGACCCT GGAGGAGGAG
    CTATTTGGGA ACAATGAGGA GAGCCCAGCT TTTAAGGAGT TCTTGGACCT GCTGGGGGAC
    ACGATCACAC TGCAGGATTT CAAAGGTTTC CGAGGAGGCC TGGATGTGAC CCACGGACAG
    ACAGGGGTGG AATCAGTGTA CACGACATTC CGGGACAGGG AGATCATGTT TCACGTTTCC
    ACAAAGCTGC CATTTACCGA GGGAGACGCC CAGCAGCTCC AGAGAAAGAG ACACATTGGA
    AATGACATTG TGGCCATCAT CTTCCAAGAG GAAAACACGC CGTTTGTCCC AGACATGATA
    GCCTCCAATT TCTTACATGC CTACATCGTC GTGCAGATCG AGACCCCGGG CACAGAGACC
    CCATCCTACA AGGTCTCTGT CACTGCGCGG GAAGATGTGC CCACCTTTGG TCCACCTCTG
    CCCAGCCCCC CCGTTTTCCA GAAGGGCCCA GAGTTCAGGG AGTTTCTGCT CACTAAGCTC
    ACCAATGCTG AGAACGCCTG CTGCAAGTCG GACAAGTTTG CAAAGTTGGA GGACCGGACC
    AGGGCTGCCC TCCTGGACAA CCTTCACGAT GAGCTCCACG CCCACACACA GGCCATGCTG
    GGACTGGGCC CAGAGGAGGA CAAGTTTGAG AATGGAGGCC ACGGGGGGTT CCTGGAGTCT
    TTTAAGAGGG CCATCCGTGT ACGCAGCCAC TCCATGGAGA CCATGGTGGG CGGCCAGAAG
    AAGTCGCACA GTGGGGGCAT CCCTGGCAGC CTCAGCGGGG GCATCTCTCA CAACAGCATG
    GAGGTCACCA AGACCACCTT CTCGCCTCCA GTGGTGGCGG CAACGGTGAA GAACCAGTCA
    CGGAGTCCCA TCAAGCGACG CTCGGGGCTC TTCCCCCGCC TGCACACGGG CTCAGAAGGC
    CAGGGCGACA GCCGGGCACG ATGTGACAGC ACATCCAGCA CACCCAAGAC CCCGGATGGT
    GGACACTCCT CTCAGGAGAT AAAGTCTGAG ACCTCATCCA ATCCCAGCTC TCCGGAAATC
    TGCCCCAACA AGGAGAAGCC CTTCATGAAG TTGAAGGAAA ACGGCCGCGC CATCTCCCGC
    TCCTCCTCCA GCACCAGCAG CGTCAGCAGC ACTGCAGGGG AGGGCGAGGC CATGGAGGAG
    GGCGACAGTG GGGGCAGCCA GCCATCCACA ACCTCACCCT TCAAGCAGGA GGTGTTTGTC
    TACAGCCCGT CCCCGAGCAG TGAGAGCCCC AGCCTGGGGG CAGCTGCCAC CCCGATCATC
    ATGAGCCGGA GTCCCACAGA TGCCAAAAGC AGAAACTCCC CGAGATCGAA CCTGAAATTC
    CGCTTTGACA AGCTCAGCCA TGCCAGCTCT GGTGCGGGTC ACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.