LOC104025219 cDNA ORF clone, Pelecanus crispus(Dalmatian pelican)

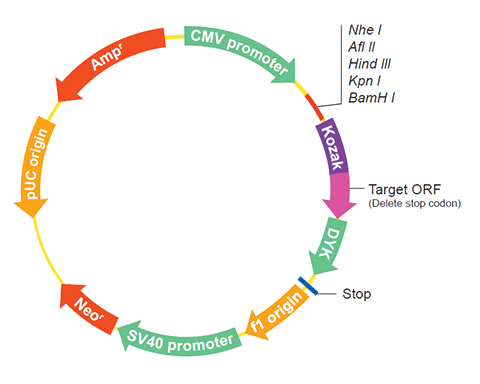
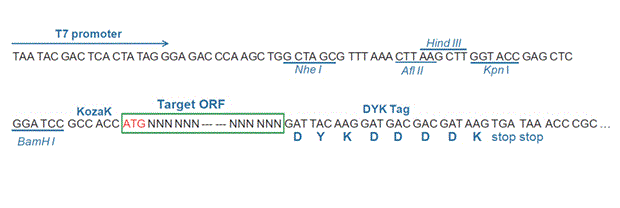
The following LOC104025219 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC104025219 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPe122474 XM_009487741.1
Latest version!
Pelecanus crispus endothelin-converting enzyme 1-like (LOC104025219), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OPe122475 XM_009487742.1
Latest version!
Pelecanus crispus endothelin-converting enzyme 1-like (LOC104025219), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPe122474
    Clone ID Related Accession (Same CDS sequence) XM_009487741.1
    Accession Version XM_009487741.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2265bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-05
    Organism Pelecanus crispus(Dalmatian pelican)
    Product endothelin-converting enzyme 1-like isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009100661.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pelecanus crispus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGTCGACCT ACAAGCGGGC GACGCTGGAT GATGAAGACC CCCTGGACTC CATCGGCGAA 
    GGTGATGGGT ACCCCAACGG CTTCCAGGTG AACTTCCGCG GCTCGAGGAG CAGCCCGGGG
    TGCTGGGCTG AGCGGACACG CGCCGAGAAG CAGCTCGTGG TGCTGGTGGG GGTGCTGGCG
    GCTGTGCTGG CCGCATGTCT GCTGGGTCTC ATCTTCCAGT ACAGAAGCCG GCCACCTGCA
    GTATGCCTGT CGGAAGCCTG CATCTCCGTC ACCAGCTCCA TCCTCAGCTC GCTAGACCGG
    GCGGTGAATC CCTGCGAGGA CTTTTTCAGC TACGCTTGTG GGGGCTGGAT CAAGGCCAAC
    CCTCTCCCCG ATGGCCACTC GCGCTGGGGC ACCTTCAACA ACCTCTGGGA GCACAACCAG
    GCCATCATGA AGCATCTGCT GGAAAACACC ACGGCCAACG TGTCGAGCGA GGCGGAGCGC
    AAGGCGCAGC GTTATTACCA AGCCTGCATG AACGAGAGCA AGATCGAGGA GCTGCGCGCC
    GCCCCGCTTA TGGAGCTCAT CCAAAAGCTG GGCGGCTGGA ACATCACGGG TCACTGGGCA
    GGGGACAACT TCAACGTGAC GCTGCGGGAG GTGACGGCGC ATTACCGCAC TTCGCCCTTC
    TTCTCCGTCT ACGTCAGCGC CGACTCCAAA AACTCCAACA GCAACGTCAT CCAGGTGGAT
    CAGTCGGGGT TAGGCCTGCC ATCGCGAGAT TACTACCTGA ACAAGACGGA GAATGAGAAG
    GTGCTCGCCG GGTACCTGAA CTACATGGTG CAGCTGGGGA TGTTCCTGGG GGGCACCGAT
    GAGGAGTCGA CACGGCAGCA GATGCAGCAG ATCTTGGACT TCGAGACGGC GTTGGCCAAC
    ATCACCATCC CGCAGGAGAA GCACCGGGAC GAGGAGGTCA TCTACCATAA AATGACAGCT
    GGAGACCTGA AGGAGCTGGC GCCGGCCGTG GACTGGATGC CCTTCCTCTC CACAGTCTTC
    TACCCCGTGG AGCTCAACGA GTCTGAGCCT GTCGTGGTCT ACGCCAAGGA GTACCTGGAG
    CAGGTCTCCG ACCTCATCCT GGCCACCGAT AAATGTCTCC TCAACAACTA CATGATCTGG
    AACCTGGTGC GGAAAACCAG CCCCTTCCTT GACCAGCGCT TCCAGGATGC TGAGGAAAAA
    TTCATGGAAG TGATGTATGG GACGAAGAAG ACTTGCCTCC CCCGCTGGAA ATTTTGCATC
    AGCGACACAG ACAACAACCT GGGCTTCGCC CTGGGGGCTA TGTTCGTCAA GGCCACCTTC
    GCCGAGGACA GCAAGCAGGT GGCAGAGGAA ATGATCGCGG AGATTAAAAC AGCCTTCGAG
    GAAAGCCTGG AGACCCTGCA GTGGATGGAC GAGGAGACGA GGAAAGCGGC CAAAGAGAAG
    GCAGATGCCA TCTACAACAT GATCGGCTAC CCCAAGTTCA TCATGGACCC CAAGGAGCTG
    GATAAAGTCT TTAATGATTA CGAGGCCGTA CCCGACCTCT ATTTCGAGAA CGTCATGCAG
    TTTTACAACT TCTCAGCCAG GGTCACTGCC GACCAGCTCC GGAAACCACC GAACCGGGAC
    CAGTGGAGTA TGACACCTCC GACGGTCAAT GCCTACTATT CTCCCACCAA GAATGAGATC
    GTCTTCCCCG CTGGCATCCT CCAGGCCCCT TTTTACACCC GTGCATCTCC CAAGTCGCTG
    AATTTTGGTG GGATTGGCGT GGTGGTGGGC CATGAGTTGA CGCATGCCTT CGATGACCAA
    GGCCGGGAAT ACGACAAGGA CGGCAACCTG CGTCCCTGGT GGAAGAACTC TTCGGTGGAA
    GCCTTCAAAC GTCAGACAGC GTGCATGGTG GAGCAGTATA GCAACTACAC GGTCAACGGC
    GAGGCCATCA ACGGCAAGCA CACCCTCGGA GAGAACATCG CCGACAACGG GGGCCTCAAG
    GCCGCCTACC GGGCATATCA AAACTGGCTG AAAAAGAATG GGGATGAGGA AACCCTCCCG
    ACCCTTGGCC TCAACAACCA CCAGCTCTTC TTCGTTGGCT TTGCCCAGGT GTGGTGTTCA
    GTTCGCACGC CGGAGAGCTC GCACGAGGGA CTCATCACCG ACCCGCACAG TCCCTCGCGT
    TTCCGTGTCA TCGGCACAGT CTCCAACTCC CGGGAGTTTG CGGAGCATTT CAGCTGCCCC
    CTTGGCTCCC CCATGAATCC CCCCAAGAAG TGCGAAGTCT GGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009486016.1
    CDS1..2265
    Translation

    Target ORF information:

    RefSeq Version XM_009487741.1
    Organism Pelecanus crispus(Dalmatian pelican)
    Definition Pelecanus crispus endothelin-converting enzyme 1-like (LOC104025219), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009487741.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGTCGACCT ACAAGCGGGC GACGCTGGAT GATGAAGACC CCCTGGACTC CATCGGCGAA 
    GGTGATGGGT ACCCCAACGG CTTCCAGGTG AACTTCCGCG GCTCGAGGAG CAGCCCGGGG
    TGCTGGGCTG AGCGGACACG CGCCGAGAAG CAGCTCGTGG TGCTGGTGGG GGTGCTGGCG
    GCTGTGCTGG CCGCATGTCT GCTGGGTCTC ATCTTCCAGT ACAGAAGCCG GCCACCTGCA
    GTATGCCTGT CGGAAGCCTG CATCTCCGTC ACCAGCTCCA TCCTCAGCTC GCTAGACCGG
    GCGGTGAATC CCTGCGAGGA CTTTTTCAGC TACGCTTGTG GGGGCTGGAT CAAGGCCAAC
    CCTCTCCCCG ATGGCCACTC GCGCTGGGGC ACCTTCAACA ACCTCTGGGA GCACAACCAG
    GCCATCATGA AGCATCTGCT GGAAAACACC ACGGCCAACG TGTCGAGCGA GGCGGAGCGC
    AAGGCGCAGC GTTATTACCA AGCCTGCATG AACGAGAGCA AGATCGAGGA GCTGCGCGCC
    GCCCCGCTTA TGGAGCTCAT CCAAAAGCTG GGCGGCTGGA ACATCACGGG TCACTGGGCA
    GGGGACAACT TCAACGTGAC GCTGCGGGAG GTGACGGCGC ATTACCGCAC TTCGCCCTTC
    TTCTCCGTCT ACGTCAGCGC CGACTCCAAA AACTCCAACA GCAACGTCAT CCAGGTGGAT
    CAGTCGGGGT TAGGCCTGCC ATCGCGAGAT TACTACCTGA ACAAGACGGA GAATGAGAAG
    GTGCTCGCCG GGTACCTGAA CTACATGGTG CAGCTGGGGA TGTTCCTGGG GGGCACCGAT
    GAGGAGTCGA CACGGCAGCA GATGCAGCAG ATCTTGGACT TCGAGACGGC GTTGGCCAAC
    ATCACCATCC CGCAGGAGAA GCACCGGGAC GAGGAGGTCA TCTACCATAA AATGACAGCT
    GGAGACCTGA AGGAGCTGGC GCCGGCCGTG GACTGGATGC CCTTCCTCTC CACAGTCTTC
    TACCCCGTGG AGCTCAACGA GTCTGAGCCT GTCGTGGTCT ACGCCAAGGA GTACCTGGAG
    CAGGTCTCCG ACCTCATCCT GGCCACCGAT AAATGTCTCC TCAACAACTA CATGATCTGG
    AACCTGGTGC GGAAAACCAG CCCCTTCCTT GACCAGCGCT TCCAGGATGC TGAGGAAAAA
    TTCATGGAAG TGATGTATGG GACGAAGAAG ACTTGCCTCC CCCGCTGGAA ATTTTGCATC
    AGCGACACAG ACAACAACCT GGGCTTCGCC CTGGGGGCTA TGTTCGTCAA GGCCACCTTC
    GCCGAGGACA GCAAGCAGGT GGCAGAGGAA ATGATCGCGG AGATTAAAAC AGCCTTCGAG
    GAAAGCCTGG AGACCCTGCA GTGGATGGAC GAGGAGACGA GGAAAGCGGC CAAAGAGAAG
    GCAGATGCCA TCTACAACAT GATCGGCTAC CCCAAGTTCA TCATGGACCC CAAGGAGCTG
    GATAAAGTCT TTAATGATTA CGAGGCCGTA CCCGACCTCT ATTTCGAGAA CGTCATGCAG
    TTTTACAACT TCTCAGCCAG GGTCACTGCC GACCAGCTCC GGAAACCACC GAACCGGGAC
    CAGTGGAGTA TGACACCTCC GACGGTCAAT GCCTACTATT CTCCCACCAA GAATGAGATC
    GTCTTCCCCG CTGGCATCCT CCAGGCCCCT TTTTACACCC GTGCATCTCC CAAGTCGCTG
    AATTTTGGTG GGATTGGCGT GGTGGTGGGC CATGAGTTGA CGCATGCCTT CGATGACCAA
    GGCCGGGAAT ACGACAAGGA CGGCAACCTG CGTCCCTGGT GGAAGAACTC TTCGGTGGAA
    GCCTTCAAAC GTCAGACAGC GTGCATGGTG GAGCAGTATA GCAACTACAC GGTCAACGGC
    GAGGCCATCA ACGGCAAGCA CACCCTCGGA GAGAACATCG CCGACAACGG GGGCCTCAAG
    GCCGCCTACC GGGCATATCA AAACTGGCTG AAAAAGAATG GGGATGAGGA AACCCTCCCG
    ACCCTTGGCC TCAACAACCA CCAGCTCTTC TTCGTTGGCT TTGCCCAGGT GTGGTGTTCA
    GTTCGCACGC CGGAGAGCTC GCACGAGGGA CTCATCACCG ACCCGCACAG TCCCTCGCGT
    TTCCGTGTCA TCGGCACAGT CTCCAACTCC CGGGAGTTTG CGGAGCATTT CAGCTGCCCC
    CTTGGCTCCC CCATGAATCC CCCCAAGAAG TGCGAAGTCT GGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPe122475
    Clone ID Related Accession (Same CDS sequence) XM_009487742.1
    Accession Version XM_009487742.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2262bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-05
    Organism Pelecanus crispus(Dalmatian pelican)
    Product endothelin-converting enzyme 1-like isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009100661.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pelecanus crispus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGTCGACCT ACAAGCGGGC GACGCTGGAT GATGAAGACC CCCTGGACTC CATCGGCGAA 
    GGTGATGGGT ACCCCAACGG CTTCCAGGTG AACTTCCGCG GCTCGAGGAG CAGCCCGGGG
    TGCTGGGCTG AGCGGACACG CGCCGAGAAG CAGCTCGTGG TGCTGGTGGG GGTGCTGGCG
    GCTGTGCTGG CCGCATGTCT GCTGGGTCTC ATCTTCCAGT ACAGAAGGCC ACCTGCAGTA
    TGCCTGTCGG AAGCCTGCAT CTCCGTCACC AGCTCCATCC TCAGCTCGCT AGACCGGGCG
    GTGAATCCCT GCGAGGACTT TTTCAGCTAC GCTTGTGGGG GCTGGATCAA GGCCAACCCT
    CTCCCCGATG GCCACTCGCG CTGGGGCACC TTCAACAACC TCTGGGAGCA CAACCAGGCC
    ATCATGAAGC ATCTGCTGGA AAACACCACG GCCAACGTGT CGAGCGAGGC GGAGCGCAAG
    GCGCAGCGTT ATTACCAAGC CTGCATGAAC GAGAGCAAGA TCGAGGAGCT GCGCGCCGCC
    CCGCTTATGG AGCTCATCCA AAAGCTGGGC GGCTGGAACA TCACGGGTCA CTGGGCAGGG
    GACAACTTCA ACGTGACGCT GCGGGAGGTG ACGGCGCATT ACCGCACTTC GCCCTTCTTC
    TCCGTCTACG TCAGCGCCGA CTCCAAAAAC TCCAACAGCA ACGTCATCCA GGTGGATCAG
    TCGGGGTTAG GCCTGCCATC GCGAGATTAC TACCTGAACA AGACGGAGAA TGAGAAGGTG
    CTCGCCGGGT ACCTGAACTA CATGGTGCAG CTGGGGATGT TCCTGGGGGG CACCGATGAG
    GAGTCGACAC GGCAGCAGAT GCAGCAGATC TTGGACTTCG AGACGGCGTT GGCCAACATC
    ACCATCCCGC AGGAGAAGCA CCGGGACGAG GAGGTCATCT ACCATAAAAT GACAGCTGGA
    GACCTGAAGG AGCTGGCGCC GGCCGTGGAC TGGATGCCCT TCCTCTCCAC AGTCTTCTAC
    CCCGTGGAGC TCAACGAGTC TGAGCCTGTC GTGGTCTACG CCAAGGAGTA CCTGGAGCAG
    GTCTCCGACC TCATCCTGGC CACCGATAAA TGTCTCCTCA ACAACTACAT GATCTGGAAC
    CTGGTGCGGA AAACCAGCCC CTTCCTTGAC CAGCGCTTCC AGGATGCTGA GGAAAAATTC
    ATGGAAGTGA TGTATGGGAC GAAGAAGACT TGCCTCCCCC GCTGGAAATT TTGCATCAGC
    GACACAGACA ACAACCTGGG CTTCGCCCTG GGGGCTATGT TCGTCAAGGC CACCTTCGCC
    GAGGACAGCA AGCAGGTGGC AGAGGAAATG ATCGCGGAGA TTAAAACAGC CTTCGAGGAA
    AGCCTGGAGA CCCTGCAGTG GATGGACGAG GAGACGAGGA AAGCGGCCAA AGAGAAGGCA
    GATGCCATCT ACAACATGAT CGGCTACCCC AAGTTCATCA TGGACCCCAA GGAGCTGGAT
    AAAGTCTTTA ATGATTACGA GGCCGTACCC GACCTCTATT TCGAGAACGT CATGCAGTTT
    TACAACTTCT CAGCCAGGGT CACTGCCGAC CAGCTCCGGA AACCACCGAA CCGGGACCAG
    TGGAGTATGA CACCTCCGAC GGTCAATGCC TACTATTCTC CCACCAAGAA TGAGATCGTC
    TTCCCCGCTG GCATCCTCCA GGCCCCTTTT TACACCCGTG CATCTCCCAA GTCGCTGAAT
    TTTGGTGGGA TTGGCGTGGT GGTGGGCCAT GAGTTGACGC ATGCCTTCGA TGACCAAGGC
    CGGGAATACG ACAAGGACGG CAACCTGCGT CCCTGGTGGA AGAACTCTTC GGTGGAAGCC
    TTCAAACGTC AGACAGCGTG CATGGTGGAG CAGTATAGCA ACTACACGGT CAACGGCGAG
    GCCATCAACG GCAAGCACAC CCTCGGAGAG AACATCGCCG ACAACGGGGG CCTCAAGGCC
    GCCTACCGGG CATATCAAAA CTGGCTGAAA AAGAATGGGG ATGAGGAAAC CCTCCCGACC
    CTTGGCCTCA ACAACCACCA GCTCTTCTTC GTTGGCTTTG CCCAGGTGTG GTGTTCAGTT
    CGCACGCCGG AGAGCTCGCA CGAGGGACTC ATCACCGACC CGCACAGTCC CTCGCGTTTC
    CGTGTCATCG GCACAGTCTC CAACTCCCGG GAGTTTGCGG AGCATTTCAG CTGCCCCCTT
    GGCTCCCCCA TGAATCCCCC CAAGAAGTGC GAAGTCTGGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009486017.1
    CDS1..2262
    Translation

    Target ORF information:

    RefSeq Version XM_009487742.1
    Organism Pelecanus crispus(Dalmatian pelican)
    Definition Pelecanus crispus endothelin-converting enzyme 1-like (LOC104025219), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009487742.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGTCGACCT ACAAGCGGGC GACGCTGGAT GATGAAGACC CCCTGGACTC CATCGGCGAA 
    GGTGATGGGT ACCCCAACGG CTTCCAGGTG AACTTCCGCG GCTCGAGGAG CAGCCCGGGG
    TGCTGGGCTG AGCGGACACG CGCCGAGAAG CAGCTCGTGG TGCTGGTGGG GGTGCTGGCG
    GCTGTGCTGG CCGCATGTCT GCTGGGTCTC ATCTTCCAGT ACAGAAGGCC ACCTGCAGTA
    TGCCTGTCGG AAGCCTGCAT CTCCGTCACC AGCTCCATCC TCAGCTCGCT AGACCGGGCG
    GTGAATCCCT GCGAGGACTT TTTCAGCTAC GCTTGTGGGG GCTGGATCAA GGCCAACCCT
    CTCCCCGATG GCCACTCGCG CTGGGGCACC TTCAACAACC TCTGGGAGCA CAACCAGGCC
    ATCATGAAGC ATCTGCTGGA AAACACCACG GCCAACGTGT CGAGCGAGGC GGAGCGCAAG
    GCGCAGCGTT ATTACCAAGC CTGCATGAAC GAGAGCAAGA TCGAGGAGCT GCGCGCCGCC
    CCGCTTATGG AGCTCATCCA AAAGCTGGGC GGCTGGAACA TCACGGGTCA CTGGGCAGGG
    GACAACTTCA ACGTGACGCT GCGGGAGGTG ACGGCGCATT ACCGCACTTC GCCCTTCTTC
    TCCGTCTACG TCAGCGCCGA CTCCAAAAAC TCCAACAGCA ACGTCATCCA GGTGGATCAG
    TCGGGGTTAG GCCTGCCATC GCGAGATTAC TACCTGAACA AGACGGAGAA TGAGAAGGTG
    CTCGCCGGGT ACCTGAACTA CATGGTGCAG CTGGGGATGT TCCTGGGGGG CACCGATGAG
    GAGTCGACAC GGCAGCAGAT GCAGCAGATC TTGGACTTCG AGACGGCGTT GGCCAACATC
    ACCATCCCGC AGGAGAAGCA CCGGGACGAG GAGGTCATCT ACCATAAAAT GACAGCTGGA
    GACCTGAAGG AGCTGGCGCC GGCCGTGGAC TGGATGCCCT TCCTCTCCAC AGTCTTCTAC
    CCCGTGGAGC TCAACGAGTC TGAGCCTGTC GTGGTCTACG CCAAGGAGTA CCTGGAGCAG
    GTCTCCGACC TCATCCTGGC CACCGATAAA TGTCTCCTCA ACAACTACAT GATCTGGAAC
    CTGGTGCGGA AAACCAGCCC CTTCCTTGAC CAGCGCTTCC AGGATGCTGA GGAAAAATTC
    ATGGAAGTGA TGTATGGGAC GAAGAAGACT TGCCTCCCCC GCTGGAAATT TTGCATCAGC
    GACACAGACA ACAACCTGGG CTTCGCCCTG GGGGCTATGT TCGTCAAGGC CACCTTCGCC
    GAGGACAGCA AGCAGGTGGC AGAGGAAATG ATCGCGGAGA TTAAAACAGC CTTCGAGGAA
    AGCCTGGAGA CCCTGCAGTG GATGGACGAG GAGACGAGGA AAGCGGCCAA AGAGAAGGCA
    GATGCCATCT ACAACATGAT CGGCTACCCC AAGTTCATCA TGGACCCCAA GGAGCTGGAT
    AAAGTCTTTA ATGATTACGA GGCCGTACCC GACCTCTATT TCGAGAACGT CATGCAGTTT
    TACAACTTCT CAGCCAGGGT CACTGCCGAC CAGCTCCGGA AACCACCGAA CCGGGACCAG
    TGGAGTATGA CACCTCCGAC GGTCAATGCC TACTATTCTC CCACCAAGAA TGAGATCGTC
    TTCCCCGCTG GCATCCTCCA GGCCCCTTTT TACACCCGTG CATCTCCCAA GTCGCTGAAT
    TTTGGTGGGA TTGGCGTGGT GGTGGGCCAT GAGTTGACGC ATGCCTTCGA TGACCAAGGC
    CGGGAATACG ACAAGGACGG CAACCTGCGT CCCTGGTGGA AGAACTCTTC GGTGGAAGCC
    TTCAAACGTC AGACAGCGTG CATGGTGGAG CAGTATAGCA ACTACACGGT CAACGGCGAG
    GCCATCAACG GCAAGCACAC CCTCGGAGAG AACATCGCCG ACAACGGGGG CCTCAAGGCC
    GCCTACCGGG CATATCAAAA CTGGCTGAAA AAGAATGGGG ATGAGGAAAC CCTCCCGACC
    CTTGGCCTCA ACAACCACCA GCTCTTCTTC GTTGGCTTTG CCCAGGTGTG GTGTTCAGTT
    CGCACGCCGG AGAGCTCGCA CGAGGGACTC ATCACCGACC CGCACAGTCC CTCGCGTTTC
    CGTGTCATCG GCACAGTCTC CAACTCCCGG GAGTTTGCGG AGCATTTCAG CTGCCCCCTT
    GGCTCCCCCA TGAATCCCCC CAAGAAGTGC GAAGTCTGGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.