TAF2 cDNA ORF clone, Opisthocomus hoazin

The following TAF2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the TAF2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp21763 XM_009937894.1
Latest version!
Opisthocomus hoazin TAF2 RNA polymerase II, TATA box binding protein (TBP)-associated factor, 150kDa (TAF2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp21763
    Clone ID Related Accession (Same CDS sequence) XM_009937894.1
    Accession Version XM_009937894.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3579bp)
    Protein sequence
    SNP
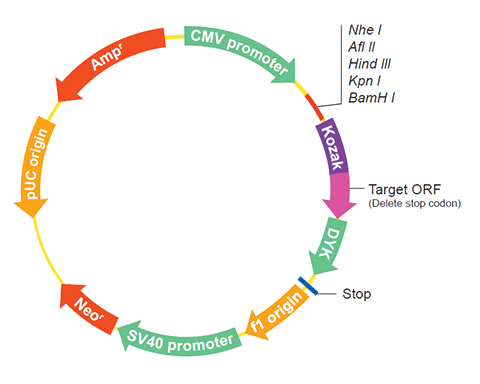
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
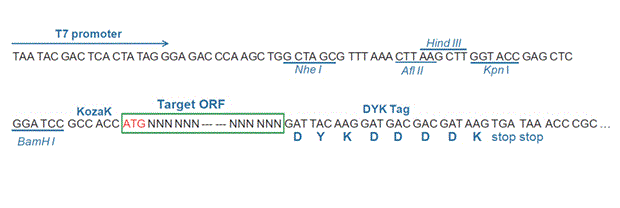
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product transcription initiation factor TFIID subunit 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009902005.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 3% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAATAGGA AGAAAGGAGA CAAGGGATTT GAGAGCCCAA GACCGTATAA ATTAACTCAC 
    CAGGTAGTTT GTATCAACAA CATAAATTTT CAGAGAAAAT CTGTTGTAGG TTATGTGGAA
    CTGACAATAT TTCCCACAGT TGCAAACCTG AATAGAATCA AACTGAGCAG TAAACAGTGC
    CGGATTTACA GAGTAAGAGT CAATGATTTA GAAGCAGCTT TCATCTATAA CGATCCAACG
    CTGGAGGTTT GTCACCATGA GTCAAAGCAG AGGAATCTCA ACTATTTTTC CAATGCCTAC
    GCTGCTGCAG TCAGTGCTGT GGACCCAGAT GCTGGAAATG GAGAACTCTG CATTAAGGTT
    CCCTCAGAGT TGTGGAAACA TGTTGATGAG ATGAAAGTCC TGAAGGTGCA TATAAACTTT
    TCTTTGGACC AGCCAAAAGG AGGCCTTCAT TTTGTGGTAC CCAGCATGGA GGGTAGCATG
    GCAGAAAGAG GGGCTCATGT CTTTTCGTGT GGTTACCAGA ATTCTACAAG ATTTTGGTTT
    CCTTGTGTTG ATTCATATTC TGAGTTGTGT ACCTGGAAAC TTGAGTATAC TGTAGATGCT
    GCAATGGTGG CGGTTTCAAA TGGAGATTTG GTGGAAACTG TGTATACCCA TGATATGAGA
    AAGAAGACTT TTCATTACAT GTTGACTATT CCAACTGCAG CTTCTAACAT CTCCTTGGCG
    ATAGGACCTT TTGAAATCCT TGTTGATCCA TACATGCATG AGGTGACTCA CTTTTGCTTG
    CCACAACTTC TCCCATTGCT CAAACATACC ACCTCATACC TTCACGAGGT GTTTGAATTT
    TATGAGGAGA TTCTTACCTG CCGCTATCCT TACTCTTGTT TCAAGACTGT TTTTATAGAT
    GAAGCTTACG TTGAAGTAGC TGCTTACGCA TCCATGAGTA TTTTCAGTAC AAATCTCTTA
    CACAGCGCAA TGATTATAGA TGAAACTCCG CTGACAAGGA GGTGCTTAGC ACAGGCCTTG
    GCCCAGCAGT TCTTTGGATG TTTTATATCC AGAATGTCCT GGTCAGATGA ATGGGTGCTA
    AAGGGAATCT CTGGTTATAT TTATGGCCTT TGGATGAAAA AAACCTTTGG TGTTAATGAG
    TATCGCCACT GGATTAAACA GGAGTTAGAT CAAATAGTGG CATATGAACT GAAGACTGGT
    GGAGTTTTAC TACATCCCAT ATTCGGAGGA GGAAAAGAGA AAGACAACCC TGCATCACAT
    TTACATTTTT CTATCAAACA CCCTCATACA CTGTCCTGGG AATATTACAC TATGTTCCAA
    TGTAAAGCAC ATCTTGTTAT GAGACTGATT GAGAACAGGA TAAGCATGGA GTTCATGTTA
    CAGGTTTTCA ACAAGTTGTT GAGTCTGGCC AGCACTGCTT CATCTCAGAA GTTCCAGTCA
    CACATGTGGA GTCAGATGCT GGTTTCCACA TCTGGGTTTT TGAAATCTAT CTCAAATGTC
    TCTGGCAAAG ACATCCAACC TTTAATAAAG CAGTGGGTTG ATCAGAGTGG AGTGGTGAAG
    TTTTATGGTA GCTTTGCATT TAATAGAAAA CGGAATGTAT TGGAATTGGA AATAAAACAA
    GACTACACGT CTCCTGGAAC TCAGAAATAC GTGGGTCCTC TTAAAGTGAC AGTGCAAGAA
    CTTGATGGAT CATTCAATCA TACATTGCAG ATTGAAGAAA ACAGCCTTAA ACATGATATA
    CCTTGCCATT CTAAAAGCAG AAGAAATAAG AAGAAAAAGA TTCCATTGAT GAATGGAGAA
    GAGGTGGAGA TGGAGCTTTC GGCTATGGAT GCTGATTCTC CTTTGCTCTG GATAAGAATA
    GACCCTGATA TGTCAGTGCT GAGGAAGGTA GAATTTGAAC AATCTGATTT CATGTGGCAG
    TATCAGCTTC GATATGAGAG AGATGTGGTT GCACAAGAAG CCGCCATTCT GGCATTGGAA
    AAGTTCCCTA CTCCAGCATC ACGGCTGGCA CTGACTGATA TACTGGAACA GGAACAATGT
    TTCTACCGAG TGAGAATGCT GGCCTGCTTC TGCCTTGCAA AGATTGCAAA TTCCATGGTA
    AGTACGTGGA CAGGACCACC GGCCATGAAG TCACTCTTTA CCCGAATGTT TTGTTGTAAG
    ACCTGTCCAA ACATTGTGAA GACCAACAAC TTCATGAACT TTCAAAGCTA CTTTCTGCAA
    AAGACTATGC CTGTTGCCAT GGCTCTTCTG AGAGACGTTC ACAACCTCTG TCCTAAGGAG
    GTGTTAATGT TTATTTTGGA TTTGATCAAG TATAACGATA ACAGGAAGAA TAAGTTTTCA
    GACAACTACT ATCGTGCTGA GCTGATTGAT GCCCTGGCCA ACTCTGTAAC TCCTGCAGTC
    AGTGTGAACA ATGAAGTTCG AACATTGGAT AACTTAAATC CTGATGTTCG ACTTATTCTT
    GAGGAAATTA CCCGTTTCCT AAATATGGAG AAGCTTCTTC CCAGTTACAG GCATACCATT
    ACAGTCAGCT GTTTAAAAGC TATTCGAGTG CTTCAGAAGA ATGGTCACGT CCCAAGTGAT
    CCTGCTCTTT TCAAGTCATA TGCAGAATAT GGGCACTTCA TAGATGTCCG AATAGCAGCG
    TTGGAGGCTG TCGTTGATTA CACAAAAGTT GATAGGAGCT ATGAAGAACT ACAGTGGCTG
    CTTACTATGG TTCAGAATGA TCCTGTACCC TACATAAGGC ACAAGATTCT GGATATGCTG
    ACTAAGAATC CACCTTTTAC CAAGAACATG GAGTCCCCTT TGTGTAACGA AGCTTTGGTA
    GATCAGCTCT GGAAACTGAT GAATTCAGGA ACTTCACATG ACTGGAGATT ACGATGTGGT
    GCTGTGGACC TCTATTTCAC ACTTTTTGGC CTCAGCAGAC CCTCTTGTTT ACCACTACCA
    GAGCTTGGAC TTGTTCTTAA TCTGAAAGAA AAGAAGGCTG TACTTAATCC AACGATTATC
    CCTGAATCAG TTGCAAATAA TCAGGAACCT GTGAATAGTA CTAACAATCA CGGGCAGTCA
    GTAGGATTTC AGAATACCTT CTCAAACTCT CAAGAAGAGG AGGAAATTGA TATGGACACA
    GTTCATGACA GTCAAGCCTT TATTTACCAT CATCTGAACA TGTTGGAGAG ACCATCCACA
    CCAGGTAGAA GTAAATTTAT TGGAAAAATG ATAGTCTGGT TTCACATGCT TGCAGCTGTG
    AAGGAAAATT TTCTTACTTG TCTAAAAGCT TTAGAGGAAG GCGGTCAGGT GGTGGGGATA
    GGTCTAGGTA CAGGTAAAGA ACAGTCTTCG GGAGAGATGA ACATGCACCC CGTCTCAGCA
    GCTCCCCTCT CTGTGTTTAG TAAAGAATCA AACTCCTCAA AACATAGCGA TCACCATCAC
    CATCACCACC ATGAGCACAA GAAAAAGAAG AAGAAACACA AGCATAAGCA TAAGCATAAA
    CATAAACATG ATAGCAAAGA AAAGGAAAAG GATCCCTTTG CTTTCTCTAA CAGTCCAGCC
    AGCGCACGAT CAATCCGTTC CCCGTCACTT TCAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009936196.1
    CDS1..3579
    Translation

    Target ORF information:

    RefSeq Version XM_009937894.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin TAF2 RNA polymerase II, TATA box binding protein (TBP)-associated factor, 150kDa (TAF2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009937894.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAATAGGA AGAAAGGAGA CAAGGGATTT GAGAGCCCAA GACCGTATAA ATTAACTCAC 
    CAGGTAGTTT GTATCAACAA CATAAATTTT CAGAGAAAAT CTGTTGTAGG TTATGTGGAA
    CTGACAATAT TTCCCACAGT TGCAAACCTG AATAGAATCA AACTGAGCAG TAAACAGTGC
    CGGATTTACA GAGTAAGAGT CAATGATTTA GAAGCAGCTT TCATCTATAA CGATCCAACG
    CTGGAGGTTT GTCACCATGA GTCAAAGCAG AGGAATCTCA ACTATTTTTC CAATGCCTAC
    GCTGCTGCAG TCAGTGCTGT GGACCCAGAT GCTGGAAATG GAGAACTCTG CATTAAGGTT
    CCCTCAGAGT TGTGGAAACA TGTTGATGAG ATGAAAGTCC TGAAGGTGCA TATAAACTTT
    TCTTTGGACC AGCCAAAAGG AGGCCTTCAT TTTGTGGTAC CCAGCATGGA GGGTAGCATG
    GCAGAAAGAG GGGCTCATGT CTTTTCGTGT GGTTACCAGA ATTCTACAAG ATTTTGGTTT
    CCTTGTGTTG ATTCATATTC TGAGTTGTGT ACCTGGAAAC TTGAGTATAC TGTAGATGCT
    GCAATGGTGG CGGTTTCAAA TGGAGATTTG GTGGAAACTG TGTATACCCA TGATATGAGA
    AAGAAGACTT TTCATTACAT GTTGACTATT CCAACTGCAG CTTCTAACAT CTCCTTGGCG
    ATAGGACCTT TTGAAATCCT TGTTGATCCA TACATGCATG AGGTGACTCA CTTTTGCTTG
    CCACAACTTC TCCCATTGCT CAAACATACC ACCTCATACC TTCACGAGGT GTTTGAATTT
    TATGAGGAGA TTCTTACCTG CCGCTATCCT TACTCTTGTT TCAAGACTGT TTTTATAGAT
    GAAGCTTACG TTGAAGTAGC TGCTTACGCA TCCATGAGTA TTTTCAGTAC AAATCTCTTA
    CACAGCGCAA TGATTATAGA TGAAACTCCG CTGACAAGGA GGTGCTTAGC ACAGGCCTTG
    GCCCAGCAGT TCTTTGGATG TTTTATATCC AGAATGTCCT GGTCAGATGA ATGGGTGCTA
    AAGGGAATCT CTGGTTATAT TTATGGCCTT TGGATGAAAA AAACCTTTGG TGTTAATGAG
    TATCGCCACT GGATTAAACA GGAGTTAGAT CAAATAGTGG CATATGAACT GAAGACTGGT
    GGAGTTTTAC TACATCCCAT ATTCGGAGGA GGAAAAGAGA AAGACAACCC TGCATCACAT
    TTACATTTTT CTATCAAACA CCCTCATACA CTGTCCTGGG AATATTACAC TATGTTCCAA
    TGTAAAGCAC ATCTTGTTAT GAGACTGATT GAGAACAGGA TAAGCATGGA GTTCATGTTA
    CAGGTTTTCA ACAAGTTGTT GAGTCTGGCC AGCACTGCTT CATCTCAGAA GTTCCAGTCA
    CACATGTGGA GTCAGATGCT GGTTTCCACA TCTGGGTTTT TGAAATCTAT CTCAAATGTC
    TCTGGCAAAG ACATCCAACC TTTAATAAAG CAGTGGGTTG ATCAGAGTGG AGTGGTGAAG
    TTTTATGGTA GCTTTGCATT TAATAGAAAA CGGAATGTAT TGGAATTGGA AATAAAACAA
    GACTACACGT CTCCTGGAAC TCAGAAATAC GTGGGTCCTC TTAAAGTGAC AGTGCAAGAA
    CTTGATGGAT CATTCAATCA TACATTGCAG ATTGAAGAAA ACAGCCTTAA ACATGATATA
    CCTTGCCATT CTAAAAGCAG AAGAAATAAG AAGAAAAAGA TTCCATTGAT GAATGGAGAA
    GAGGTGGAGA TGGAGCTTTC GGCTATGGAT GCTGATTCTC CTTTGCTCTG GATAAGAATA
    GACCCTGATA TGTCAGTGCT GAGGAAGGTA GAATTTGAAC AATCTGATTT CATGTGGCAG
    TATCAGCTTC GATATGAGAG AGATGTGGTT GCACAAGAAG CCGCCATTCT GGCATTGGAA
    AAGTTCCCTA CTCCAGCATC ACGGCTGGCA CTGACTGATA TACTGGAACA GGAACAATGT
    TTCTACCGAG TGAGAATGCT GGCCTGCTTC TGCCTTGCAA AGATTGCAAA TTCCATGGTA
    AGTACGTGGA CAGGACCACC GGCCATGAAG TCACTCTTTA CCCGAATGTT TTGTTGTAAG
    ACCTGTCCAA ACATTGTGAA GACCAACAAC TTCATGAACT TTCAAAGCTA CTTTCTGCAA
    AAGACTATGC CTGTTGCCAT GGCTCTTCTG AGAGACGTTC ACAACCTCTG TCCTAAGGAG
    GTGTTAATGT TTATTTTGGA TTTGATCAAG TATAACGATA ACAGGAAGAA TAAGTTTTCA
    GACAACTACT ATCGTGCTGA GCTGATTGAT GCCCTGGCCA ACTCTGTAAC TCCTGCAGTC
    AGTGTGAACA ATGAAGTTCG AACATTGGAT AACTTAAATC CTGATGTTCG ACTTATTCTT
    GAGGAAATTA CCCGTTTCCT AAATATGGAG AAGCTTCTTC CCAGTTACAG GCATACCATT
    ACAGTCAGCT GTTTAAAAGC TATTCGAGTG CTTCAGAAGA ATGGTCACGT CCCAAGTGAT
    CCTGCTCTTT TCAAGTCATA TGCAGAATAT GGGCACTTCA TAGATGTCCG AATAGCAGCG
    TTGGAGGCTG TCGTTGATTA CACAAAAGTT GATAGGAGCT ATGAAGAACT ACAGTGGCTG
    CTTACTATGG TTCAGAATGA TCCTGTACCC TACATAAGGC ACAAGATTCT GGATATGCTG
    ACTAAGAATC CACCTTTTAC CAAGAACATG GAGTCCCCTT TGTGTAACGA AGCTTTGGTA
    GATCAGCTCT GGAAACTGAT GAATTCAGGA ACTTCACATG ACTGGAGATT ACGATGTGGT
    GCTGTGGACC TCTATTTCAC ACTTTTTGGC CTCAGCAGAC CCTCTTGTTT ACCACTACCA
    GAGCTTGGAC TTGTTCTTAA TCTGAAAGAA AAGAAGGCTG TACTTAATCC AACGATTATC
    CCTGAATCAG TTGCAAATAA TCAGGAACCT GTGAATAGTA CTAACAATCA CGGGCAGTCA
    GTAGGATTTC AGAATACCTT CTCAAACTCT CAAGAAGAGG AGGAAATTGA TATGGACACA
    GTTCATGACA GTCAAGCCTT TATTTACCAT CATCTGAACA TGTTGGAGAG ACCATCCACA
    CCAGGTAGAA GTAAATTTAT TGGAAAAATG ATAGTCTGGT TTCACATGCT TGCAGCTGTG
    AAGGAAAATT TTCTTACTTG TCTAAAAGCT TTAGAGGAAG GCGGTCAGGT GGTGGGGATA
    GGTCTAGGTA CAGGTAAAGA ACAGTCTTCG GGAGAGATGA ACATGCACCC CGTCTCAGCA
    GCTCCCCTCT CTGTGTTTAG TAAAGAATCA AACTCCTCAA AACATAGCGA TCACCATCAC
    CATCACCACC ATGAGCACAA GAAAAAGAAG AAGAAACACA AGCATAAGCA TAAGCATAAA
    CATAAACATG ATAGCAAAGA AAAGGAAAAG GATCCCTTTG CTTTCTCTAA CAGTCCAGCC
    AGCGCACGAT CAATCCGTTC CCCGTCACTT TCAGACTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.