Il6r cDNA ORF clone, Nannospalax galili(Upper Galilee mountains blind mole rat)

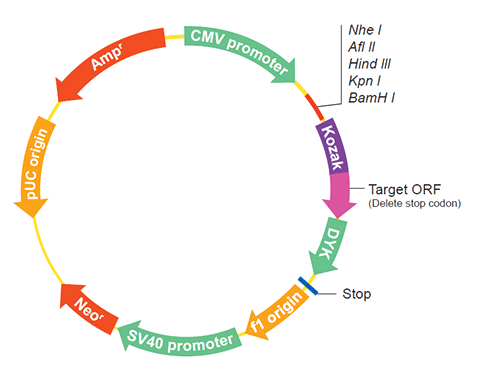
The following Il6r gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the Il6r cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ONa139782 XM_029557259.1
Latest version!
Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
ONa43155 XM_008854760.2
Latest version!
Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
ONa43156 XM_008854768.3
Latest version!
Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
View Old Accession Versions >>
ONa43156 XM_008854768.2 Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ONa139782
    Clone ID Related Accession (Same CDS sequence) XM_029557259.1
    Accession Version XM_029557259.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2055bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
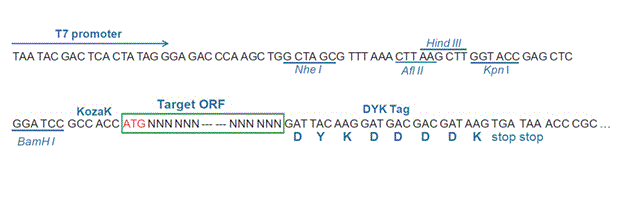
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product interleukin-6 receptor subunit alpha isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008330926.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGATCA AGAACCTCGA GAAGAAACCC
    AAGAAGACCT ATCATCACTG CATCATCCAG GATGCCTTGA GAGGCATGAA ACACGTGGTG
    CAGATCCGGG GAAAGGAGGA GTTTGGGATT GGCAAGTGGA GCGAGTGGAC CCCGGAGGTC
    ACGTGTACTC CTTGGATAGA TACCAGGAGC ACTCCGAGGA CCCCCACGGA GCCCCCTGAT
    GAAGAAGACT ATGACGAGGA TCTCTACAGA ATTTCTACAG GAACAACAGA GACCCCCGGT
    CAAGAATCTT CCTCCGCATC ACTGGCCACA TTCTTGGTGG CTGGAGGAAG TCTGGCCTTT
    GGATTGCTCC TTTGTGTTGG TGTTGTTCTG AGGCTCAAGA AGACATGGAA GGCACAGGCT
    GGAAAAGAAT GCAAGACAAA CTCACCCCCA CCATACTCCC CGGGACAGCT GAAGCCCACT
    GTGGTGCTTG TTCCACTCCT CACCCAAGCA GCGCCCCCCC GCAGCAGCAA CACCTTGAGC
    CACAACTGCC CAGATGCCGG GGAACCACAG AGCCCTTACG ACATCAGCAA CAGAGACTAC
    TTCTTCCCCA GATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_029413119.1
    CDS729..2783
    Translation

    Target ORF information:

    RefSeq Version XM_029557259.1
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_029557259.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGATCA AGAACCTCGA GAAGAAACCC
    AAGAAGACCT ATCATCACTG CATCATCCAG GATGCCTTGA GAGGCATGAA ACACGTGGTG
    CAGATCCGGG GAAAGGAGGA GTTTGGGATT GGCAAGTGGA GCGAGTGGAC CCCGGAGGTC
    ACGTGTACTC CTTGGATAGA TACCAGGAGC ACTCCGAGGA CCCCCACGGA GCCCCCTGAT
    GAAGAAGACT ATGACGAGGA TCTCTACAGA ATTTCTACAG GAACAACAGA GACCCCCGGT
    CAAGAATCTT CCTCCGCATC ACTGGCCACA TTCTTGGTGG CTGGAGGAAG TCTGGCCTTT
    GGATTGCTCC TTTGTGTTGG TGTTGTTCTG AGGCTCAAGA AGACATGGAA GGCACAGGCT
    GGAAAAGAAT GCAAGACAAA CTCACCCCCA CCATACTCCC CGGGACAGCT GAAGCCCACT
    GTGGTGCTTG TTCCACTCCT CACCCAAGCA GCGCCCCCCC GCAGCAGCAA CACCTTGAGC
    CACAACTGCC CAGATGCCGG GGAACCACAG AGCCCTTACG ACATCAGCAA CAGAGACTAC
    TTCTTCCCCA GATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa43155
    Clone ID Related Accession (Same CDS sequence) XM_008854760.2
    Accession Version XM_008854760.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2130bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product interleukin-6 receptor subunit alpha isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008330926.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008854760.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGGA CCACTGGGAG TCATCATGTC TCCATTCTCA GATCAAGAAC
    CTCGAGAAGA AACCCAAGAA GACCTATCAT CACTGCATCA TCCAGGATGC CTTGAGAGGC
    ATGAAACACG TGGTGCAGAT CCGGGGAAAG GAGGAGTTTG GGATTGGCAA GTGGAGCGAG
    TGGACCCCGG AGGTCACGTG TACTCCTTGG ATAGATACCA GGAGCACTCC GAGGACCCCC
    ACGGAGCCCC CTGATGAAGA AGACTATGAC GAGGATCTCT ACAGAATTTC TACAGGAACA
    ACAGAGACCC CCGGTCAAGA ATCTTCCTCC GCATCACTGG CCACATTCTT GGTGGCTGGA
    GGAAGTCTGG CCTTTGGATT GCTCCTTTGT GTTGGTGTTG TTCTGAGGCT CAAGAAGACA
    TGGAAGGCAC AGGCTGGAAA AGAATGCAAG ACAAACTCAC CCCCACCATA CTCCCCGGGA
    CAGCTGAAGC CCACTGTGGT GCTTGTTCCA CTCCTCACCC AAGCAGCGCC CCCCCGCAGC
    AGCAACACCT TGAGCCACAA CTGCCCAGAT GCCGGGGAAC CACAGAGCCC TTACGACATC
    AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008852982.2
    CDS707..2836
    Translation

    Target ORF information:

    RefSeq Version XM_008854760.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008854760.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGGA CCACTGGGAG TCATCATGTC TCCATTCTCA GATCAAGAAC
    CTCGAGAAGA AACCCAAGAA GACCTATCAT CACTGCATCA TCCAGGATGC CTTGAGAGGC
    ATGAAACACG TGGTGCAGAT CCGGGGAAAG GAGGAGTTTG GGATTGGCAA GTGGAGCGAG
    TGGACCCCGG AGGTCACGTG TACTCCTTGG ATAGATACCA GGAGCACTCC GAGGACCCCC
    ACGGAGCCCC CTGATGAAGA AGACTATGAC GAGGATCTCT ACAGAATTTC TACAGGAACA
    ACAGAGACCC CCGGTCAAGA ATCTTCCTCC GCATCACTGG CCACATTCTT GGTGGCTGGA
    GGAAGTCTGG CCTTTGGATT GCTCCTTTGT GTTGGTGTTG TTCTGAGGCT CAAGAAGACA
    TGGAAGGCAC AGGCTGGAAA AGAATGCAAG ACAAACTCAC CCCCACCATA CTCCCCGGGA
    CAGCTGAAGC CCACTGTGGT GCTTGTTCCA CTCCTCACCC AAGCAGCGCC CCCCCGCAGC
    AGCAACACCT TGAGCCACAA CTGCCCAGAT GCCGGGGAAC CACAGAGCCC TTACGACATC
    AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa43156
    Clone ID Related Accession (Same CDS sequence) XM_008854768.2 , XM_008854768.3
    Accession Version XM_008854768.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2100bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-08-10
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product interleukin-6 receptor subunit alpha isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008330926.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 11, 2016 this sequence version replaced XM_008854768.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Nannospalax galili Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGTT GATCAAGAAC CTCGAGAAGA AACCCAAGAA GACCTATCAT
    CACTGCATCA TCCAGGATGC CTTGAGAGGC ATGAAACACG TGGTGCAGAT CCGGGGAAAG
    GAGGAGTTTG GGATTGGCAA GTGGAGCGAG TGGACCCCGG AGGTCACGTG TACTCCTTGG
    ATAGATACCA GGAGCACTCC GAGGACCCCC ACGGAGCCCC CTGATGAAGA AGACTATGAC
    GAGGATCTCT ACAGAATTTC TACAGGAACA ACAGAGACCC CCGGTCAAGA ATCTTCCTCC
    GCATCACTGG CCACATTCTT GGTGGCTGGA GGAAGTCTGG CCTTTGGATT GCTCCTTTGT
    GTTGGTGTTG TTCTGAGGCT CAAGAAGACA TGGAAGGCAC AGGCTGGAAA AGAATGCAAG
    ACAAACTCAC CCCCACCATA CTCCCCGGGA CAGCTGAAGC CCACTGTGGT GCTTGTTCCA
    CTCCTCACCC AAGCAGCGCC CCCCCGCAGC AGCAACACCT TGAGCCACAA CTGCCCAGAT
    GCCGGGGAAC CACAGAGCCC TTACGACATC AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008852990.2
    CDS707..2806
    Translation

    Target ORF information:

    RefSeq Version XM_008854768.2
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008854768.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGTT GATCAAGAAC CTCGAGAAGA AACCCAAGAA GACCTATCAT
    CACTGCATCA TCCAGGATGC CTTGAGAGGC ATGAAACACG TGGTGCAGAT CCGGGGAAAG
    GAGGAGTTTG GGATTGGCAA GTGGAGCGAG TGGACCCCGG AGGTCACGTG TACTCCTTGG
    ATAGATACCA GGAGCACTCC GAGGACCCCC ACGGAGCCCC CTGATGAAGA AGACTATGAC
    GAGGATCTCT ACAGAATTTC TACAGGAACA ACAGAGACCC CCGGTCAAGA ATCTTCCTCC
    GCATCACTGG CCACATTCTT GGTGGCTGGA GGAAGTCTGG CCTTTGGATT GCTCCTTTGT
    GTTGGTGTTG TTCTGAGGCT CAAGAAGACA TGGAAGGCAC AGGCTGGAAA AGAATGCAAG
    ACAAACTCAC CCCCACCATA CTCCCCGGGA CAGCTGAAGC CCACTGTGGT GCTTGTTCCA
    CTCCTCACCC AAGCAGCGCC CCCCCGCAGC AGCAACACCT TGAGCCACAA CTGCCCAGAT
    GCCGGGGAAC CACAGAGCCC TTACGACATC AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ONa43156
    Clone ID Related Accession (Same CDS sequence) XM_008854768.2 , XM_008854768.3
    Accession Version XM_008854768.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2100bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-06-23
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Product interleukin-6 receptor subunit alpha isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_008330926.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Jun 24, 2019 this sequence version replaced XM_008854768.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Nannospalax galili Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGTT GATCAAGAAC CTCGAGAAGA AACCCAAGAA GACCTATCAT
    CACTGCATCA TCCAGGATGC CTTGAGAGGC ATGAAACACG TGGTGCAGAT CCGGGGAAAG
    GAGGAGTTTG GGATTGGCAA GTGGAGCGAG TGGACCCCGG AGGTCACGTG TACTCCTTGG
    ATAGATACCA GGAGCACTCC GAGGACCCCC ACGGAGCCCC CTGATGAAGA AGACTATGAC
    GAGGATCTCT ACAGAATTTC TACAGGAACA ACAGAGACCC CCGGTCAAGA ATCTTCCTCC
    GCATCACTGG CCACATTCTT GGTGGCTGGA GGAAGTCTGG CCTTTGGATT GCTCCTTTGT
    GTTGGTGTTG TTCTGAGGCT CAAGAAGACA TGGAAGGCAC AGGCTGGAAA AGAATGCAAG
    ACAAACTCAC CCCCACCATA CTCCCCGGGA CAGCTGAAGC CCACTGTGGT GCTTGTTCCA
    CTCCTCACCC AAGCAGCGCC CCCCCGCAGC AGCAACACCT TGAGCCACAA CTGCCCAGAT
    GCCGGGGAAC CACAGAGCCC TTACGACATC AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008852990.2
    CDS728..2827
    Translation

    Target ORF information:

    RefSeq Version XM_008854768.3
    Organism Nannospalax galili(Upper Galilee mountains blind mole rat)
    Definition Nannospalax galili interleukin 6 receptor (Il6r), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008854768.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGTCCCCAC AGATTCCAAA GCCCACACCG TTTTGTTGCC TTTCTGAAGC AGCCTTCGAA 
    GAGAGGCTGA GTGTTGAGAA TGAACCTTTA GGACGTCCGT CTTGCCTCAG GCTGACTGAA
    TCAGAATCTG TGGGGGTCGA CCCAGATAGC GCTGTTTTTT TAGGGCTCCC CAGAGGGTTG
    CAGTGGGCAG TGCCCCCTAT TGTAACAGGC AGAGACACAG CACCTCCTCT AAGACTTTCC
    AGGTGCGCCT TTCACTGCGT AATCGTTTTC GCTTCGCGAA AGCAAAACTC AAAACCAGAG
    CGGGTGGGGC TGCCCAGAGC GCTCCAACCT GGGGAGGGTC AGGCGGATCC TGCGCTCCCT
    GCGGTCCGGA CCCCGCTGAG CTCCCGCTCA GGTGCGCGGG GGCAGGAAGC CGTCCCCTCT
    GGTGGCCCCG GTGCGCTGGG CTGTTGCGCC ATCGGTCGGG CTTTCGTAAC TGCACACCGG
    GCCTGCCAAG AGGCGCTTCA GTGCCAGTTC CTCAAACGTT TTCCTGCGTT GCCAGGACGG
    TCCTCGGCTC TGAGTCATGG GCAAGTGGGA AGTCGTCGCA CGGACAGCCA GCGAGCGCGG
    CGAGGGGCCG AACAGAGAGT GCTTCTGAGC CGGGGACCAC GACTTGCCCC GGGGCTGAGT
    CCTCCCGTCG CCCCGCCCAG GCCGAGCAGT CATCCCGGCT CCGCACGGCT GCGGCCTGCA
    GAAGGAAGCA TGCTGGCCGT ACGCTGCGCG CTGCTGACCG CGCTGCTGAC CGCGCCCTCC
    GCGGCGGCCT CCCGGAGCTG CCGAGCGCTC GAGGTGGCAA ATGATACGGT GGCGAGTCTG
    CCGGGGGCCA CTGTCACCCT GACCTGCCCA GGGATGGAAC CAGAAAACAA TACCACTGTT
    TACTGGGTGC ACAATGGCTC AAACCTCAGA AGATGGGCTA GTGTGGGAAG AAATCTACTT
    CTGAGATTGG TGCAGCCCAG CGACTCCGGG AACTATTCAT GCTACGTGGA TGGCCAGCAA
    GCTGGGACTG TGCGCTTGCT GGTAGATGTT CCTCCAGAGA AACCCAATCT CCACTGCTTC
    CGGAAGAATC CACTCATGAA CGTTGTTTGT GAGTGGCGTC CTCATCACAA ACCCTCTGAA
    ACGACCAAGG CTGTGCTGAA TGTGAAGAAG CTCAAGCTCA GTTTCACGAC TGAGTTCCAG
    GTGCCCTGCC AGTATTCTCA GGAGTTCCAA AACTTCTCCT GCCAGGTGGC AATCCTAGAG
    GACAATAATG CTTTCTACGT AGTGACCCTA TGCGTGGCCA ACAGTGTCGG AAGCAAGTCC
    AGCAATGATG TGTCATTCGA GGCCATAAGA ATAGTGCAGC CTGACCCACC TGTCAACCTT
    GTGGTCACAG CCATGCCGGG AAACCCTCAC TGGCTCAATG TCAGCTGGCA AGACCCTGAG
    TCCTGGGACC CATATTACTA CCTGCTACAG TATGAGGTTC GATACCGGCC AGAATGGTCA
    AAGACATCCA CAGTGTGGTT GATCAAGAAC CTCGAGAAGA AACCCAAGAA GACCTATCAT
    CACTGCATCA TCCAGGATGC CTTGAGAGGC ATGAAACACG TGGTGCAGAT CCGGGGAAAG
    GAGGAGTTTG GGATTGGCAA GTGGAGCGAG TGGACCCCGG AGGTCACGTG TACTCCTTGG
    ATAGATACCA GGAGCACTCC GAGGACCCCC ACGGAGCCCC CTGATGAAGA AGACTATGAC
    GAGGATCTCT ACAGAATTTC TACAGGAACA ACAGAGACCC CCGGTCAAGA ATCTTCCTCC
    GCATCACTGG CCACATTCTT GGTGGCTGGA GGAAGTCTGG CCTTTGGATT GCTCCTTTGT
    GTTGGTGTTG TTCTGAGGCT CAAGAAGACA TGGAAGGCAC AGGCTGGAAA AGAATGCAAG
    ACAAACTCAC CCCCACCATA CTCCCCGGGA CAGCTGAAGC CCACTGTGGT GCTTGTTCCA
    CTCCTCACCC AAGCAGCGCC CCCCCGCAGC AGCAACACCT TGAGCCACAA CTGCCCAGAT
    GCCGGGGAAC CACAGAGCCC TTACGACATC AGCAACAGAG ACTACTTCTT CCCCAGATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.