ZNF777 cDNA ORF clone, Loxodonta africana(African savanna elephant)

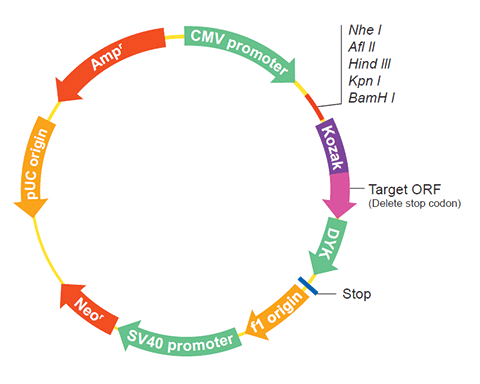
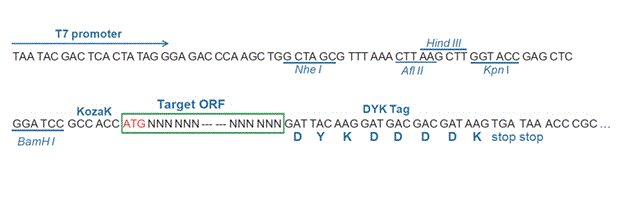
The following ZNF777 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZNF777 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OLo53827 XM_023539555.1
Latest version!
Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
OLo53827 XM_010600112.2
Latest version!
Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
OLo53828 XM_023539556.1
Latest version!
Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
OLo53828 XM_003420557.2
Latest version!
Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
View Old Accession Versions >>
OLo53827 XM_010600112.1 Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OLo53827
    Clone ID Related Accession (Same CDS sequence) XM_010600112.1 , XM_010600112.2 , XM_023539555.1
    Accession Version XM_010600112.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2505bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-12-10
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 777 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573511.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Loxodonta africana Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010598414.1
    CDS60..2564
    Translation

    Target ORF information:

    RefSeq Version XM_010600112.1
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010600112.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OLo53827
    Clone ID Related Accession (Same CDS sequence) XM_010600112.1 , XM_010600112.2 , XM_023539555.1
    Accession Version XM_010600112.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2505bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-15
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 777 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573511.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process On Jan 16, 2018 this sequence version replaced XM_010600112.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Loxodonta africana Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_010598414.1
    CDS90..2594
    Translation

    Target ORF information:

    RefSeq Version XM_010600112.2
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_010600112.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OLo53827
    Clone ID Related Accession (Same CDS sequence) XM_010600112.1 , XM_010600112.2 , XM_023539555.1
    Accession Version XM_023539555.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2505bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-15
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 777 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573511.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Loxodonta africana Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_023395323.1
    CDS3512..6016
    Translation

    Target ORF information:

    RefSeq Version XM_023539555.1
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_023539555.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGC AGAGGGGATC GTGATCAAAA CGGAGGAACA GGACGAGGAA
    GAGGAGGAGG AGGAGGAAGA AGAGGAGGAA GAGGAGCTGC CCCCACACCT GCAGACCCTC
    GGGCAGCTGT CCGGGCGGTT CGAGGCCAGC ATGTACCAGG CCCCGCTGCC GGGGGAGCTG
    TCCCCCGACG GCGAGGAGAG CCCCCCGGCT CTGCAGCTGG GGAAGCCGGC CATGAGGAGG
    CTGGCGCCCG CGGCGCACGG CGAGCGGCAC CTGGGCGAGG GCCGCGGCCC GGCCAGCCAG
    CAGCAGCGCA ACCGCCGCGG CGGGCGGCCC TTCACCTGCC TGGAGTGCGG CAAGAGCTTC
    CGGCTGAAGA TCAACCTGGT CATCCACCAG CGCAACCACG TCAAGGAGGG GCCGTACGCG
    TGCGCCGAGT GCGAGGCCAG CTTTCGCCAC AAGCAGCAGC TGACACTGCA CCAGCGTGCG
    CACCGCGGGC CGCGCGCGCC GCCCTCGCCC GAGCGCGCGC CCAGCCTGCA CCCCAAACAC
    GCGCTCAAGG CGCGCCCCAA GTCGCCCGGC GCAGGCGGCG GCGGCTCCAA GCCCTACCAG
    TGCCCCGAGT GCGACAGCAG CTTCAGCCAC AAGTCCAGCC TGACCAAGCA CCAGATCACA
    CACACGGGCG AGCGGCCCTA CACGTGCCCC GAGTGCAAGA AGAGTTTCCG CCTGCACATC
    AGCCTGGTCA TCCACCAGCG CGTGCACGCC GGCAAGCACG AGGTCTCCTT CATCTGCAGC
    CTGTGCGGCA AGAGCTTCAG CCGCCCGTCG CACCTGCTGC GCCACCAGCG GACGCACACG
    GGCGAGCGGC CCTTCAAGTG CCCCGAGTGC GAGAAGAGCT TCAGCGAGAA GTCCAAGCTC
    ACCAACCACT GCCGCGTGCA CTCGCGCGAG CGCCCGCACG CCTGCCCCGA GTGCGGCAAG
    AGCTTCATCC GCAAGCACCA CCTGCTGGAG CACCGGCGCA TCCACACGGG CGAGCGGCCC
    TACCACTGCG CCGAGTGCGG CAAGCGCTTC ACGCAGAAGC ACCACCTGCT GGAGCACCAG
    CGCGCGCACA CCGGCGAGCG GCCCTACCCG TGCGCGCACT GCGCCAAGTG CTTCCGCTAC
    AAGCAGTCGC TCAAGTACCA CCTGCGGACC CACGCGGGCG AGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OLo53828
    Clone ID Related Accession (Same CDS sequence) XM_023539556.1 , XM_003420557.2
    Accession Version XM_023539556.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2502bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-01-15
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 777 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573511.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Loxodonta africana Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGA GGGGATCGTG ATCAAAACGG AGGAACAGGA CGAGGAAGAG
    GAGGAGGAGG AGGAAGAAGA GGAGGAAGAG GAGCTGCCCC CACACCTGCA GACCCTCGGG
    CAGCTGTCCG GGCGGTTCGA GGCCAGCATG TACCAGGCCC CGCTGCCGGG GGAGCTGTCC
    CCCGACGGCG AGGAGAGCCC CCCGGCTCTG CAGCTGGGGA AGCCGGCCAT GAGGAGGCTG
    GCGCCCGCGG CGCACGGCGA GCGGCACCTG GGCGAGGGCC GCGGCCCGGC CAGCCAGCAG
    CAGCGCAACC GCCGCGGCGG GCGGCCCTTC ACCTGCCTGG AGTGCGGCAA GAGCTTCCGG
    CTGAAGATCA ACCTGGTCAT CCACCAGCGC AACCACGTCA AGGAGGGGCC GTACGCGTGC
    GCCGAGTGCG AGGCCAGCTT TCGCCACAAG CAGCAGCTGA CACTGCACCA GCGTGCGCAC
    CGCGGGCCGC GCGCGCCGCC CTCGCCCGAG CGCGCGCCCA GCCTGCACCC CAAACACGCG
    CTCAAGGCGC GCCCCAAGTC GCCCGGCGCA GGCGGCGGCG GCTCCAAGCC CTACCAGTGC
    CCCGAGTGCG ACAGCAGCTT CAGCCACAAG TCCAGCCTGA CCAAGCACCA GATCACACAC
    ACGGGCGAGC GGCCCTACAC GTGCCCCGAG TGCAAGAAGA GTTTCCGCCT GCACATCAGC
    CTGGTCATCC ACCAGCGCGT GCACGCCGGC AAGCACGAGG TCTCCTTCAT CTGCAGCCTG
    TGCGGCAAGA GCTTCAGCCG CCCGTCGCAC CTGCTGCGCC ACCAGCGGAC GCACACGGGC
    GAGCGGCCCT TCAAGTGCCC CGAGTGCGAG AAGAGCTTCA GCGAGAAGTC CAAGCTCACC
    AACCACTGCC GCGTGCACTC GCGCGAGCGC CCGCACGCCT GCCCCGAGTG CGGCAAGAGC
    TTCATCCGCA AGCACCACCT GCTGGAGCAC CGGCGCATCC ACACGGGCGA GCGGCCCTAC
    CACTGCGCCG AGTGCGGCAA GCGCTTCACG CAGAAGCACC ACCTGCTGGA GCACCAGCGC
    GCGCACACCG GCGAGCGGCC CTACCCGTGC GCGCACTGCG CCAAGTGCTT CCGCTACAAG
    CAGTCGCTCA AGTACCACCT GCGGACCCAC GCGGGCGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_023395324.1
    CDS16..2517
    Translation

    Target ORF information:

    RefSeq Version XM_023539556.1
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_023539556.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGA GGGGATCGTG ATCAAAACGG AGGAACAGGA CGAGGAAGAG
    GAGGAGGAGG AGGAAGAAGA GGAGGAAGAG GAGCTGCCCC CACACCTGCA GACCCTCGGG
    CAGCTGTCCG GGCGGTTCGA GGCCAGCATG TACCAGGCCC CGCTGCCGGG GGAGCTGTCC
    CCCGACGGCG AGGAGAGCCC CCCGGCTCTG CAGCTGGGGA AGCCGGCCAT GAGGAGGCTG
    GCGCCCGCGG CGCACGGCGA GCGGCACCTG GGCGAGGGCC GCGGCCCGGC CAGCCAGCAG
    CAGCGCAACC GCCGCGGCGG GCGGCCCTTC ACCTGCCTGG AGTGCGGCAA GAGCTTCCGG
    CTGAAGATCA ACCTGGTCAT CCACCAGCGC AACCACGTCA AGGAGGGGCC GTACGCGTGC
    GCCGAGTGCG AGGCCAGCTT TCGCCACAAG CAGCAGCTGA CACTGCACCA GCGTGCGCAC
    CGCGGGCCGC GCGCGCCGCC CTCGCCCGAG CGCGCGCCCA GCCTGCACCC CAAACACGCG
    CTCAAGGCGC GCCCCAAGTC GCCCGGCGCA GGCGGCGGCG GCTCCAAGCC CTACCAGTGC
    CCCGAGTGCG ACAGCAGCTT CAGCCACAAG TCCAGCCTGA CCAAGCACCA GATCACACAC
    ACGGGCGAGC GGCCCTACAC GTGCCCCGAG TGCAAGAAGA GTTTCCGCCT GCACATCAGC
    CTGGTCATCC ACCAGCGCGT GCACGCCGGC AAGCACGAGG TCTCCTTCAT CTGCAGCCTG
    TGCGGCAAGA GCTTCAGCCG CCCGTCGCAC CTGCTGCGCC ACCAGCGGAC GCACACGGGC
    GAGCGGCCCT TCAAGTGCCC CGAGTGCGAG AAGAGCTTCA GCGAGAAGTC CAAGCTCACC
    AACCACTGCC GCGTGCACTC GCGCGAGCGC CCGCACGCCT GCCCCGAGTG CGGCAAGAGC
    TTCATCCGCA AGCACCACCT GCTGGAGCAC CGGCGCATCC ACACGGGCGA GCGGCCCTAC
    CACTGCGCCG AGTGCGGCAA GCGCTTCACG CAGAAGCACC ACCTGCTGGA GCACCAGCGC
    GCGCACACCG GCGAGCGGCC CTACCCGTGC GCGCACTGCG CCAAGTGCTT CCGCTACAAG
    CAGTCGCTCA AGTACCACCT GCGGACCCAC GCGGGCGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OLo53828
    Clone ID Related Accession (Same CDS sequence) XM_023539556.1 , XM_003420557.2
    Accession Version XM_003420557.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2502bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-12-10
    Organism Loxodonta africana(African savanna elephant)
    Product zinc finger protein 777 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_003573511.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Dec 11, 2014 this sequence version replaced XM_003420557.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Loxodonta africana Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGA GGGGATCGTG ATCAAAACGG AGGAACAGGA CGAGGAAGAG
    GAGGAGGAGG AGGAAGAAGA GGAGGAAGAG GAGCTGCCCC CACACCTGCA GACCCTCGGG
    CAGCTGTCCG GGCGGTTCGA GGCCAGCATG TACCAGGCCC CGCTGCCGGG GGAGCTGTCC
    CCCGACGGCG AGGAGAGCCC CCCGGCTCTG CAGCTGGGGA AGCCGGCCAT GAGGAGGCTG
    GCGCCCGCGG CGCACGGCGA GCGGCACCTG GGCGAGGGCC GCGGCCCGGC CAGCCAGCAG
    CAGCGCAACC GCCGCGGCGG GCGGCCCTTC ACCTGCCTGG AGTGCGGCAA GAGCTTCCGG
    CTGAAGATCA ACCTGGTCAT CCACCAGCGC AACCACGTCA AGGAGGGGCC GTACGCGTGC
    GCCGAGTGCG AGGCCAGCTT TCGCCACAAG CAGCAGCTGA CACTGCACCA GCGTGCGCAC
    CGCGGGCCGC GCGCGCCGCC CTCGCCCGAG CGCGCGCCCA GCCTGCACCC CAAACACGCG
    CTCAAGGCGC GCCCCAAGTC GCCCGGCGCA GGCGGCGGCG GCTCCAAGCC CTACCAGTGC
    CCCGAGTGCG ACAGCAGCTT CAGCCACAAG TCCAGCCTGA CCAAGCACCA GATCACACAC
    ACGGGCGAGC GGCCCTACAC GTGCCCCGAG TGCAAGAAGA GTTTCCGCCT GCACATCAGC
    CTGGTCATCC ACCAGCGCGT GCACGCCGGC AAGCACGAGG TCTCCTTCAT CTGCAGCCTG
    TGCGGCAAGA GCTTCAGCCG CCCGTCGCAC CTGCTGCGCC ACCAGCGGAC GCACACGGGC
    GAGCGGCCCT TCAAGTGCCC CGAGTGCGAG AAGAGCTTCA GCGAGAAGTC CAAGCTCACC
    AACCACTGCC GCGTGCACTC GCGCGAGCGC CCGCACGCCT GCCCCGAGTG CGGCAAGAGC
    TTCATCCGCA AGCACCACCT GCTGGAGCAC CGGCGCATCC ACACGGGCGA GCGGCCCTAC
    CACTGCGCCG AGTGCGGCAA GCGCTTCACG CAGAAGCACC ACCTGCTGGA GCACCAGCGC
    GCGCACACCG GCGAGCGGCC CTACCCGTGC GCGCACTGCG CCAAGTGCTT CCGCTACAAG
    CAGTCGCTCA AGTACCACCT GCGGACCCAC GCGGGCGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003420605.1
    CDS60..2561
    Translation

    Target ORF information:

    RefSeq Version XM_003420557.2
    Organism Loxodonta africana(African savanna elephant)
    Definition Loxodonta africana zinc finger protein 777 (ZNF777), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003420557.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGGAGACCC AACGCTCATC GCCCCTGTCG TTCCCCAGTG TTCCTCAAAA TGAAACCCTG 
    CGTCAAGCCC CTGCTGGACC CGCCCGAGAA ACTCTGCTCC AGTCCCGTGT TCTTCCCTCC
    AAAGAGATCC CTTCTTTGTC TCCTGCCGTT CCCCGGCAAG GCTCCCTGCC CCAAGCTCCC
    AGTGCCCCCA AGCAAGAGAC TTCTGGCCGA ATGCCGCATG TGCTCCAGAA GGGACCCTCA
    CTCCTGTATC CAGCCGCTGC TGAGCAGGGG ACTCATCTCC AGCGCCCCCA GGCTTCCCAA
    GAAGAAACCC GGTATCCACC CCCCGTGGCT GCTGACCCTG AACTCTCACT TCTCTCCCAT
    GCCACCCACC GTCAGGAAGC CCCACTCCGT TCCCCTGAAG TTCCTGAGAA AGACCCCCTG
    ACCCTCTCGC CCACGGTTCC TGAGGCTGAC TTGGACCCTC TGCTCCAGAG ACCAGCTTCT
    CAGAAGGACA CCCCTTTCCA GCTCTCCTCT GCAGCTCAGA AGGAAACGCC ACTCCCCACG
    GCGGAGATCA CCCGCTTGGC TGTGTGGGCT GCCGTCCAGG CGGTAGAGAG GAAATTGGAG
    GCCCAGGCCA TGAGGTTACT GACCCTGGAG GGCAGGACGG GGACAAATGA AAAAAAGATC
    GCCGACTGTG AGAAGACGGC TGTGGAGTTT GCAAACCACC TAGAGAGCAA GTGGGTCGTG
    CTGGGGACAC TGCTGCAGGA GTATGGGCTG CTGCAGCGGC GGCTGGAGAA CATGGAGAAC
    CTGCTGAAAA ATAGGAACTT CTGGATCCTG CGGCTGCCCC CCGGCAGCAA CGGAGAGGTT
    CCTAAGGTTC CAGTCACTTT CGATGACGTC GCCGTCCATT TCTCGGAACA GGAGTGGGGA
    AACCTGTCCG AGTGGCAGAA GGAGCTCTAC AAGAACGTCA TGAGGGGCAA CTACGAGTCT
    CTGGTTTCCA TGGACTATGC AATTTCCAAA CCAGACCTGA TGTCACAGAT GGAGCGAGGG
    GAGAGGCCAG CCGTGCAGGA ACAGGAAGAT TCCGAGGAGG GTGAAACGCC TGCAGATCCC
    AGTGCTGCAC ACGATGGGAT CGTGATTAAG ATCGAGGTCC AGACCAACGA TGAGGGCTCG
    GAGAGTTTGG AGACCCCTGA GCCCCTGATG GGGCAGGTGG AAGAACACGG CTTTCAGGAC
    TCAGAGCTGG GGGACCCCTG TGGCGAGCAG CCAGAGCTGG ACATGCAGGA ACAGGAAAAT
    GCCTTGGAGG AGTCCACAGA AGGCTCCAGC GAGTTCAGTG AACTCAAGCA GATGCTGGCC
    CAGCAGAGAA ACTGCACAGA GGGGATCGTG ATCAAAACGG AGGAACAGGA CGAGGAAGAG
    GAGGAGGAGG AGGAAGAAGA GGAGGAAGAG GAGCTGCCCC CACACCTGCA GACCCTCGGG
    CAGCTGTCCG GGCGGTTCGA GGCCAGCATG TACCAGGCCC CGCTGCCGGG GGAGCTGTCC
    CCCGACGGCG AGGAGAGCCC CCCGGCTCTG CAGCTGGGGA AGCCGGCCAT GAGGAGGCTG
    GCGCCCGCGG CGCACGGCGA GCGGCACCTG GGCGAGGGCC GCGGCCCGGC CAGCCAGCAG
    CAGCGCAACC GCCGCGGCGG GCGGCCCTTC ACCTGCCTGG AGTGCGGCAA GAGCTTCCGG
    CTGAAGATCA ACCTGGTCAT CCACCAGCGC AACCACGTCA AGGAGGGGCC GTACGCGTGC
    GCCGAGTGCG AGGCCAGCTT TCGCCACAAG CAGCAGCTGA CACTGCACCA GCGTGCGCAC
    CGCGGGCCGC GCGCGCCGCC CTCGCCCGAG CGCGCGCCCA GCCTGCACCC CAAACACGCG
    CTCAAGGCGC GCCCCAAGTC GCCCGGCGCA GGCGGCGGCG GCTCCAAGCC CTACCAGTGC
    CCCGAGTGCG ACAGCAGCTT CAGCCACAAG TCCAGCCTGA CCAAGCACCA GATCACACAC
    ACGGGCGAGC GGCCCTACAC GTGCCCCGAG TGCAAGAAGA GTTTCCGCCT GCACATCAGC
    CTGGTCATCC ACCAGCGCGT GCACGCCGGC AAGCACGAGG TCTCCTTCAT CTGCAGCCTG
    TGCGGCAAGA GCTTCAGCCG CCCGTCGCAC CTGCTGCGCC ACCAGCGGAC GCACACGGGC
    GAGCGGCCCT TCAAGTGCCC CGAGTGCGAG AAGAGCTTCA GCGAGAAGTC CAAGCTCACC
    AACCACTGCC GCGTGCACTC GCGCGAGCGC CCGCACGCCT GCCCCGAGTG CGGCAAGAGC
    TTCATCCGCA AGCACCACCT GCTGGAGCAC CGGCGCATCC ACACGGGCGA GCGGCCCTAC
    CACTGCGCCG AGTGCGGCAA GCGCTTCACG CAGAAGCACC ACCTGCTGGA GCACCAGCGC
    GCGCACACCG GCGAGCGGCC CTACCCGTGC GCGCACTGCG CCAAGTGCTT CCGCTACAAG
    CAGTCGCTCA AGTACCACCT GCGGACCCAC GCGGGCGAGT GA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.