LOC108657393 cDNA ORF clone, Drosophila navojoa

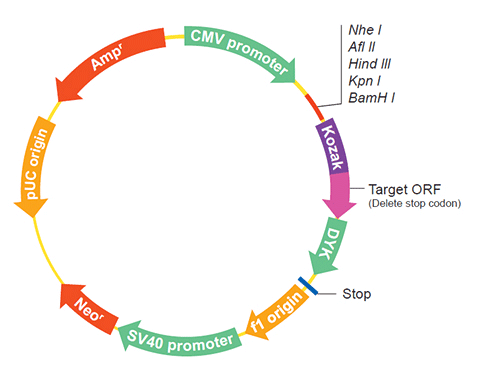
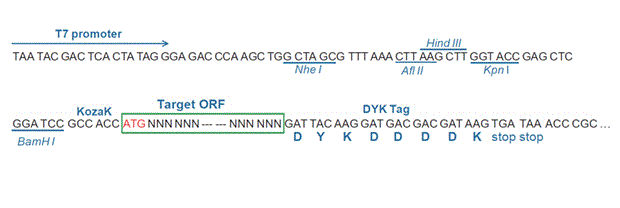
The following LOC108657393 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC108657393 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ODr253890 XM_018109977.2
Latest version!
Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
ODr253890 XM_018109976.2
Latest version!
Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
ODr253891 XM_018109978.2
Latest version!
Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00
View Old Accession Versions >>
ODr253890 XM_018109976.1 Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
ODr253891 XM_018109978.1 Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
ODr253890 XM_018109977.1 Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ODr253890
    Clone ID Related Accession (Same CDS sequence) XM_018109977.2 , XM_018109976.1 , XM_018109976.2 , XM_018109977.1
    Accession Version XM_018109977.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product WW domain-containing adapter protein with coiled-coil homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046319.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 16, 2019 this sequence version replaced XM_018109977.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017965466.1
    CDS703..3318
    Translation

    Target ORF information:

    RefSeq Version XM_018109977.2
    Organism Drosophila navojoa
    Definition Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109977.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253890
    Clone ID Related Accession (Same CDS sequence) XM_018109977.2 , XM_018109976.1 , XM_018109976.2 , XM_018109977.1
    Accession Version XM_018109976.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product WW domain-containing adapter protein with coiled-coil homolog isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046319.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 16, 2019 this sequence version replaced XM_018109976.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017965465.1
    CDS1010..3625
    Translation

    Target ORF information:

    RefSeq Version XM_018109976.2
    Organism Drosophila navojoa
    Definition Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109976.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253891
    Clone ID Related Accession (Same CDS sequence) XM_018109978.1 , XM_018109978.2
    Accession Version XM_018109978.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2541bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product WW domain-containing adapter protein with coiled-coil homolog isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046319.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Aug 16, 2019 this sequence version replaced XM_018109978.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_017965467.1
    CDS1013..3553
    Translation

    Target ORF information:

    RefSeq Version XM_018109978.2
    Organism Drosophila navojoa
    Definition Drosophila navojoa WW domain-containing adapter protein with coiled-coil homolog (LOC108657393), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109978.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253890
    Clone ID Related Accession (Same CDS sequence) XM_018109977.2 , XM_018109976.1 , XM_018109976.2 , XM_018109977.1
    Accession Version XM_018109976.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product uncharacterized protein LOC108657393 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017965465.1
    CDS1017..3632
    Translation

    Target ORF information:

    RefSeq Version XM_018109976.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109976.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253890
    Clone ID Related Accession (Same CDS sequence) XM_018109977.2 , XM_018109976.1 , XM_018109976.2 , XM_018109977.1
    Accession Version XM_018109977.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product uncharacterized protein LOC108657393 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017965466.1
    CDS710..3325
    Translation

    Target ORF information:

    RefSeq Version XM_018109977.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109977.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAAAT TATGTATCTG CGCCAGCAAA TTCGCCGTAT TGAAGAGTCG
    AAGACTCAGA ACGCGTTCAT GTCGGACGAT ACTTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253891
    Clone ID Related Accession (Same CDS sequence) XM_018109978.1 , XM_018109978.2
    Accession Version XM_018109978.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2541bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product uncharacterized transmembrane protein DDB_G0289901 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017965467.1
    CDS1019..3559
    Translation

    Target ORF information:

    RefSeq Version XM_018109978.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa uncharacterized transmembrane protein DDB_G0289901 (LOC108657393), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018109978.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    ATGGTAATGC ATGCTAGAAA ACCGCAGCGT ATGAACGATG GGTACTTTGA GAAGCATACC 
    AGTCACACAT CCTACCAGAG CTCAAAGTAC AGCAGTTCAA AGCGCGACTA TGAACGCGAT
    CGTTCCTCCA ATTATCGCGA TCGTGACATT TCACCTGGTG GCGGTGGTGC TGGCGGTGGC
    GGAGGAGGCG GCGGTGGTGG CGGCGGCGGC GGAGGAGGTG GCGGCGGTCC ATTGAATAAT
    GGCAACAGCT ATCGTTCACA ATCACCGGAC ATAGATTCAC CATCATCGCG CTCGCATGAT
    CTGCGCGAAC GCAGCGATCA CCGGAGTGGC GGCGGCGGCG GCGGCGGAGG TGGCAGCAAC
    GATCGCTACA GTTATATACA AAAGATGCGC GATCGGGATC GCGATCTCTA CAAAAAGGAT
    AAATATTCCG ATAAACGTGA TCGGCGCGGC AATGATCGCG ACTCGGAGTC ATCGTATCGC
    ACGAATCATG ACAGGGATCG TCGTGGCGGT GTGGCAAAGT TATGCTCGTC GCGCGAAAAC
    GATAAGCGCT CCGGTTCCGA TGATCGGGAT CGTGAGCGTG ATCGCGATCT GCGCGACAAG
    CGTGACAGAG GCGCCGATCG TGATCGGGAT ATGTACAAGA AGGACAAATA CGCAGACAAA
    CGGGAGCGCA GCGATCGTGG CGAACGTGTG GCGCGCTATG GCGACTGGAG CGAGCATGTG
    AGCTCGTCCG GTAAAATGTA TTACTATAAC TGCAAAACTG AAGTCTCCCA GTGGGAGAAG
    CCTAAGGAAT GGGTAGATAG AGAAAGAAAT TTGCCGCGTG ATCAACATCG TGAGAAGGAT
    TACCGCGATA AGGATCGGGA TCGAGATCGC GATGATCGAT TCTCAAGATC GACATACAAA
    CATTCCAATT CATCGCGCGA CAATTCACGA CTGAGATGGA ATTACGAAAA TGATGGCGGG
    CCGCCCAGCC ATCGAAGACG ATTGGATGGT CGACATAACG ATAATGCTGA TATGGACATT
    AGTGGCGACT CGACGCCCAC CTCGGAGGCC AGTTATTCGT TAAGCGGCAC ACCCACCACG
    CATGGCGGCA GCGTGGGCGG CGGCATGCAG TCTAGTGAAC AGTCGTCTCT GATGCCGCAG
    GGCGCATTGG CGGGTGGATT GTGTAATGCA CTGCCTCGAC TGGCCTCCCA TCCAAATACC
    GGCGCAGTGG TCACGCCCAT TGGTGCGCAT TATGGTGCCA TCGGTGTGGG CGGCACTGGC
    GGCGGCGGCG GAGGTGGCGG TAGCGGCGGT CCAGTTAGCG GCGCCACAAT GTTGCCCACC
    AGCGGATTGG CCTCGGTGCC GTCCAACATT GCCAACAGCA GCAACAGCAG CCTTAGAAAC
    TCAGTTGTCG GCCACATTGG CTCAACGTCC AGCACGACAG TGCCGACGCT GGCGAATCAG
    GATCATCATC TGAATTCGAA TGCGCCCGGA CCGCCTGGCA AGCTGATGGG CGCTAGTGTC
    AAGGATCAGA CAGCATTGTC GCATCGACAA AAGTTACATT TAGTCCTGAG CGGCATGGAT
    GTGCCCCATC ATCATATGAT GGGCAGCAGC GCCAGCGGCG TGGGCCCAAC GGGCGCCGGC
    AGTGGCTCAT CCGTGGATGT CGTGAACCAT GCCTACAATT CGGTTAACAA TGTGACTGCT
    GGTAGCTTAA GCAGCTTAGG CAGCTTAAGG GACAGCAGCC AACTCAACTC ACCGCTGTGC
    ATACCGCATG CCCATCATAG TCTGTCGCCA TCGCTGAGCT ATACAAAGAG TCCCATACCA
    ACGATCGTGA GTCACACGAA TAATGTGAGC GCAAGCAATG CCTACACCTG CAATGCACCG
    TTTGGCCTCA AGGCGGTCGA TGGGCTTGCC GTTGGCGTGG GCGTGGTGTC CTCCTCACCG
    GCGTCAAATG CGATCGGCAA TAGCAATGCG ATTGCCGGCA GCAACAGCAG CAGCAGCAGC
    TGCAACGTAC CCGGCATGGG CACTGTCAGC GGCATCAGCG TCATCACCTC CATGGGCAGC
    AACAGTTTGT GCGGCAGTGC ATCAGCGCTT GGCGAGGGGC CGCCAACGCC AACACAAGAA
    TTAGATTTAA GTGGCTCAGC TTTAGAACAA CACCAACATC AACATCAACA GGTGGCTGCT
    GCCGCAGCCG CCGCCGCAGC AGCCATGGCT GCGGTGCAAG CAACGCAACA GGCGGCGCAA
    CAGGCCCAAC AACAGCGCAA ACTTGATGGC GCCGGTTCAG CTACGCTAAG CACTCTCCAG
    AGCTGTGTGG CCTCGGTGCA GGCGGCAAAT CTGCGCGGCC CGGAAATTTC ACCCAAGCTA
    GCAAAATACT TTCGCGCTGA TTTAATTGCG CACGTGACCA ACTGGCAGGC GGAGATTTTG
    GAGCGTCAGG CGCAAAAGTG CTGCGAGGAC ACGCATCTAT TTGGGGACAT CAACTGCACA
    CGGATATGCG CCGAGTTGAA GTGTGCGCGG AGTTTAGTGC GTAGCACGGA GATCAATGCG
    ACGCTGCAAG AACAAAAGTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.