LOC105366264 cDNA ORF clone, Ceratosolen solmsi marchali

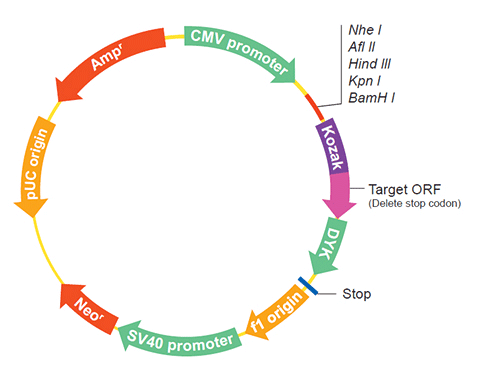
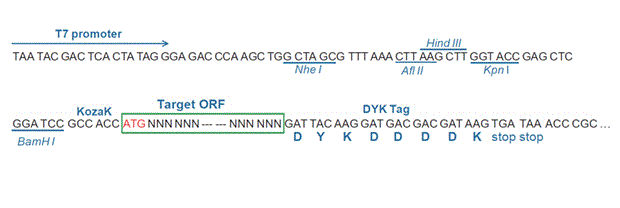
The following LOC105366264 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105366264 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe202001 XM_011504646.1
Latest version!
Ceratosolen solmsi marchali uncharacterized LOC105366264 (LOC105366264), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe202001
    Clone ID Related Accession (Same CDS sequence) XM_011504646.1
    Accession Version XM_011504646.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3762bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product uncharacterized protein LOC105366264
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948447.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAGCATGA ATGGTCGGAA ACCGAAAATG GCATTGGTTG CACTACGTCC GGTTCCAGAT 
    TGCCCTGAAC CTCAGGATTC TATCGCAGCA TCTGGTCAAG AATTTCCTCC ACCTCCAGAA
    GAAGCCGAAC GCATAATTTC CACTCTCCTC CCTATGGTTT CCCCTGAAAA CTCTTCAACA
    AGAAGTGGTC ATTGTCATCG ACATCGTCTG CAACAGCAGC AGCAGCGAAA TATTGGTCAT
    CAATGGATCA ATGTAAAGGA CGATTTCAAA TGCCAAGGAC ATGCCGTTAC TACGCAAACC
    ACCTTACCAA AAACGAGACA CCAAAGGCCA TACGGTTGGG AAAGTAACAA TTTGACCATT
    AGCGATGGAC ACGTGGTTAA ATCTTTTCAA CTCACAGACC AACCCAGCCC ACTCAATAAA
    TTTGCCAGTC TGCCTTATGA CGTCAAGGTG TCCTTTAATT GGATCGCTCC TCATCTGGAC
    CTTGAAGCCA AGCATCCTCG AGCCAACGTC TTCGAGGATC TGAGAAAGTC CTCTGAGGAC
    GTTCACGAGA ATCTGAGACA ATCCTCTGAG GATGGTCTTG AAGAGGAGGA TGAAGCCGGA
    GACGATGGTG ACGATGACGA TGAAGAAGAA GAGGAAGATG TCGAAGAATA TCAGGAGGAA
    GAGGAGGACG AAGAAAAGGA AGAGATGGAT GAGACCGAGA AGGCGTCGAG ACGACACCTA
    AGATCACAGA AACAGAAGAC GGTAGCCGCT TGTAACAGTC ACCACAATCA CTATCATCAC
    CATCACCATG CCGGCTCTCG CAGACCAATA CGACAAACTG TAATTATCAA GTCTAGCAGT
    GTGGAGGACA GGCTGCTGAT GAACAATTAC CAGCAGACGC GAGGCGCTGA AGCCTCAGGT
    TGCCCTGAGT ACAATACCCG GATCCAAAAC GATCTTCTAG ATTCCTCGCG GCGACGTCGC
    AACAATTCAG ACTCGAGCGA GAGTCACTTC TCGCGTAACT CTGAATCCGA GCGCTCTTCC
    ATGTTGCGCT CGAGTTCCAT TAGTGTCGAG CATTTCTCCG TACGTGCTAA CTGCGACTCC
    TCGGACTTCT CACGAGGAAA TTCCACTTCT AACGAGCGCT TTCACTCGGA CTTCTCAATC
    GCGGTTGCGA GTGCGAGTTC GAATGACCAT GTAAGCATTC CAAGCTCTGA GCCACTCGCT
    GTGCGAAACC TCGACTTTGT TACTTTTGGC TTACCACACG TGGACTCGAG CGAACGCTTC
    TCCGGGCAGA CTTCCGACCG TTGCTCCGAG GAACACTATT CCGAAGTCTA CTCTACAAGA
    AACTCGGACT TCTCTGCCCG AAACTCGGTA GACTTCAGAA CGCAGTCTGA GGAGGAACAC
    TTTTCGGACG ACTCGCTTGA AGAGCTGCTA CCACCTCCGC CTACACTTAA CAAAAGGCAC
    AGTATCGCCT GGGAGGTCAC CCTTGATGAC GAAGCCCTTT ACGCACCCGG CAGTACCAAA
    GTTGTTGGCA GAAGGAGAAG AAAAAGCAGC GATCTATCTA GTTTCGGTTC AACTTCGAAG
    TTTCCTGATT TTGATGACTG GCAGGATCTG AGAGTTTCCA CGACGGATGA TGATTTAATC
    TCACCATACT CAGACTCCTC GACTAATGAT CTCGAACAAC TGCATCCTCA AGAACGCAGC
    AAAAATGGTA CTTATGTGAT TCGTCGTGGA CGCAAGAAAG AGCGCAAGCT TTTACCTAAA
    TTGTCGAATA AAGGGCTCGA AGACAAACCG GCCGATAGAA AACTCATGGG CTCGCGACAA
    TTCTCTAATA CCTTCGATAA TATCAAAAGC CTTCTAAAAG AAAGCAGCAA GCTTGGAAGT
    CTGAGCGAGC CACCAGCAGA ATTGACGAGC AACACTCAGG CAGTCTCTCA GCCAGATCTT
    GGAAGTCTTG AGTTCGAGGT TTTGTCAGCG GTTCCCATTG TCAAACAACT TACTTCAACC
    CTCCAAATAA CGAATTTCGC CGGGAATTCA CAAAAGTCCA ACGATTTAAA TGCTATTGAT
    ACTACCAATA GCCTCGACGC CTCTCGAGCA GTGATTGTTG TTGTAGATAA ACTGCCCACT
    TGTCACTTCA TAAAAGAGCA ACAACACCTC GAATCCAAAA TACCGGTTAA CCTGCTCATC
    GAAGATCAAA TCGTCAAGAA GGCTCTTAAT GAGAACCGCC GTCAACTAGA GAAGGTGAGC
    GACGCGATTA AAGAGATCGA AAGTGTAAAA AATAGCGGGG AATATGGAGA AAGCAATCGC
    TGGCGTAGTA GCGAATTAAA GAACTCTGAG CTCCAGAGAA ATAGCTTCGA GGACGACGGC
    TGTGAAAGGC AATTTCTCAA TGTTAACGTT CACGACAGCA TAGTCCACGC TAATGGCGCA
    ATCGAAGGGG TCAGAACGGT GACTATCACA AATAATGACC ATGAATTTAA CAGAAAAAGG
    ATCAACGAAG TCGATATATA TGCCTCTGGG AGAAGGCCAA GAGTTAGCGA TTTGGAAAAT
    CACAAGAACG ATACTAAACA AATCGAAAAC GTCATAGACG CGATTCTCGA AGACTCCAAA
    AACCCAGACT TTCAAGTTAG TGTAGAGGTG TTGGAATTTC CCCCACTGCC ACCATCACCA
    GTTGAGGAAG CCGACGAAGA GAGTTCAGAT ATCGTAAGTT CTGGATGCAA CGGAGCAGAA
    GCAACAAATA AGCGTACGAC ATTGATCACA GAAAAAGAGA CAGAGATGAT GTCCGGGATG
    ACAACAATAC CTAGCAAACC CAAGCAGTCA AGTCATACAA ACCGTACAAT TGAATACAGG
    CCGCGAGTAC CACCTCACCG AGGCATTAGC TTCGACTCCT CCAAAGATCA CCAGACAACC
    TCCCTTAACA CGAGATCCAT GGATGCAGGA TATGGTCGTG GACGTAGGAC CGCCGCTGGC
    ATCGCCAACG CCAGACGCGA GGTACCGGTT GAACGAAGGA CACTGCCAAC AGACCTTCCA
    GGTCCATCGC TACGTCGACC TTTCACCAAG CGTCAAACAT CTTCGACCGA CGCCTGTTCT
    TCAGGTTGCA ATGTTAATGT TGGTGGAGGT CTAAGCGGAG GGGGAAGTGG AAATGGAGGT
    GGTAATATTG TCACCACAGG TTCCGCGATG CAAACAAGCT GCTCCCTGCC GGAGACGCCA
    GTATTCGCCC GCGGCAACGA CATACCAAGG ACACCGCAAC ATACCGTCGG AAATCCAACA
    CAGCCGCGTA GACAACCCGG ATGGTATGCG CCTACCACCG CCACCACTGG ATATAGAAGA
    AATAACCCCG GGTTGGAACA GGCAATAATC GGAACGGAGT TACTGCGACT TGCGGGTGGC
    CCGAATCGCG GTTGGTACCC GACGCGCAAA TCTAACCAAC CACGGCCGGC TTCGATCGAA
    CACCTCGAAC GTCTCAACTG CGCCTATGAT CCGAGACTCC TAGGCGCCAG TGAGCAGAGG
    AAGCCCCTGA CCCTCCCGAC TAACATCACG CCCAACAAGT ACTTCGGCCA AAGTAAGCAC
    AGCTCCGCCT CCAGTACTCG TGAGGCACTA CGGAGGGTTA CTAGCTTGCT CATCAAGAAA
    GGGGGTGGAA ATAAAGATGG GAAAAATAGC AAGGACAATC TTTCGCCATC CGGTCCTTAC
    GCTGTTGTTC CAGGTATCGA GACTAACGAT GCGCCGAAAA AGAAAGGTTT CTTCAAGAAT
    TTCTGGAAGC GCTCACGTCA CTACTCTCTA GAGAACCAAT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011502948.1
    CDS280..4041
    Translation

    Target ORF information:

    RefSeq Version XM_011504646.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali uncharacterized LOC105366264 (LOC105366264), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011504646.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAGCATGA ATGGTCGGAA ACCGAAAATG GCATTGGTTG CACTACGTCC GGTTCCAGAT 
    TGCCCTGAAC CTCAGGATTC TATCGCAGCA TCTGGTCAAG AATTTCCTCC ACCTCCAGAA
    GAAGCCGAAC GCATAATTTC CACTCTCCTC CCTATGGTTT CCCCTGAAAA CTCTTCAACA
    AGAAGTGGTC ATTGTCATCG ACATCGTCTG CAACAGCAGC AGCAGCGAAA TATTGGTCAT
    CAATGGATCA ATGTAAAGGA CGATTTCAAA TGCCAAGGAC ATGCCGTTAC TACGCAAACC
    ACCTTACCAA AAACGAGACA CCAAAGGCCA TACGGTTGGG AAAGTAACAA TTTGACCATT
    AGCGATGGAC ACGTGGTTAA ATCTTTTCAA CTCACAGACC AACCCAGCCC ACTCAATAAA
    TTTGCCAGTC TGCCTTATGA CGTCAAGGTG TCCTTTAATT GGATCGCTCC TCATCTGGAC
    CTTGAAGCCA AGCATCCTCG AGCCAACGTC TTCGAGGATC TGAGAAAGTC CTCTGAGGAC
    GTTCACGAGA ATCTGAGACA ATCCTCTGAG GATGGTCTTG AAGAGGAGGA TGAAGCCGGA
    GACGATGGTG ACGATGACGA TGAAGAAGAA GAGGAAGATG TCGAAGAATA TCAGGAGGAA
    GAGGAGGACG AAGAAAAGGA AGAGATGGAT GAGACCGAGA AGGCGTCGAG ACGACACCTA
    AGATCACAGA AACAGAAGAC GGTAGCCGCT TGTAACAGTC ACCACAATCA CTATCATCAC
    CATCACCATG CCGGCTCTCG CAGACCAATA CGACAAACTG TAATTATCAA GTCTAGCAGT
    GTGGAGGACA GGCTGCTGAT GAACAATTAC CAGCAGACGC GAGGCGCTGA AGCCTCAGGT
    TGCCCTGAGT ACAATACCCG GATCCAAAAC GATCTTCTAG ATTCCTCGCG GCGACGTCGC
    AACAATTCAG ACTCGAGCGA GAGTCACTTC TCGCGTAACT CTGAATCCGA GCGCTCTTCC
    ATGTTGCGCT CGAGTTCCAT TAGTGTCGAG CATTTCTCCG TACGTGCTAA CTGCGACTCC
    TCGGACTTCT CACGAGGAAA TTCCACTTCT AACGAGCGCT TTCACTCGGA CTTCTCAATC
    GCGGTTGCGA GTGCGAGTTC GAATGACCAT GTAAGCATTC CAAGCTCTGA GCCACTCGCT
    GTGCGAAACC TCGACTTTGT TACTTTTGGC TTACCACACG TGGACTCGAG CGAACGCTTC
    TCCGGGCAGA CTTCCGACCG TTGCTCCGAG GAACACTATT CCGAAGTCTA CTCTACAAGA
    AACTCGGACT TCTCTGCCCG AAACTCGGTA GACTTCAGAA CGCAGTCTGA GGAGGAACAC
    TTTTCGGACG ACTCGCTTGA AGAGCTGCTA CCACCTCCGC CTACACTTAA CAAAAGGCAC
    AGTATCGCCT GGGAGGTCAC CCTTGATGAC GAAGCCCTTT ACGCACCCGG CAGTACCAAA
    GTTGTTGGCA GAAGGAGAAG AAAAAGCAGC GATCTATCTA GTTTCGGTTC AACTTCGAAG
    TTTCCTGATT TTGATGACTG GCAGGATCTG AGAGTTTCCA CGACGGATGA TGATTTAATC
    TCACCATACT CAGACTCCTC GACTAATGAT CTCGAACAAC TGCATCCTCA AGAACGCAGC
    AAAAATGGTA CTTATGTGAT TCGTCGTGGA CGCAAGAAAG AGCGCAAGCT TTTACCTAAA
    TTGTCGAATA AAGGGCTCGA AGACAAACCG GCCGATAGAA AACTCATGGG CTCGCGACAA
    TTCTCTAATA CCTTCGATAA TATCAAAAGC CTTCTAAAAG AAAGCAGCAA GCTTGGAAGT
    CTGAGCGAGC CACCAGCAGA ATTGACGAGC AACACTCAGG CAGTCTCTCA GCCAGATCTT
    GGAAGTCTTG AGTTCGAGGT TTTGTCAGCG GTTCCCATTG TCAAACAACT TACTTCAACC
    CTCCAAATAA CGAATTTCGC CGGGAATTCA CAAAAGTCCA ACGATTTAAA TGCTATTGAT
    ACTACCAATA GCCTCGACGC CTCTCGAGCA GTGATTGTTG TTGTAGATAA ACTGCCCACT
    TGTCACTTCA TAAAAGAGCA ACAACACCTC GAATCCAAAA TACCGGTTAA CCTGCTCATC
    GAAGATCAAA TCGTCAAGAA GGCTCTTAAT GAGAACCGCC GTCAACTAGA GAAGGTGAGC
    GACGCGATTA AAGAGATCGA AAGTGTAAAA AATAGCGGGG AATATGGAGA AAGCAATCGC
    TGGCGTAGTA GCGAATTAAA GAACTCTGAG CTCCAGAGAA ATAGCTTCGA GGACGACGGC
    TGTGAAAGGC AATTTCTCAA TGTTAACGTT CACGACAGCA TAGTCCACGC TAATGGCGCA
    ATCGAAGGGG TCAGAACGGT GACTATCACA AATAATGACC ATGAATTTAA CAGAAAAAGG
    ATCAACGAAG TCGATATATA TGCCTCTGGG AGAAGGCCAA GAGTTAGCGA TTTGGAAAAT
    CACAAGAACG ATACTAAACA AATCGAAAAC GTCATAGACG CGATTCTCGA AGACTCCAAA
    AACCCAGACT TTCAAGTTAG TGTAGAGGTG TTGGAATTTC CCCCACTGCC ACCATCACCA
    GTTGAGGAAG CCGACGAAGA GAGTTCAGAT ATCGTAAGTT CTGGATGCAA CGGAGCAGAA
    GCAACAAATA AGCGTACGAC ATTGATCACA GAAAAAGAGA CAGAGATGAT GTCCGGGATG
    ACAACAATAC CTAGCAAACC CAAGCAGTCA AGTCATACAA ACCGTACAAT TGAATACAGG
    CCGCGAGTAC CACCTCACCG AGGCATTAGC TTCGACTCCT CCAAAGATCA CCAGACAACC
    TCCCTTAACA CGAGATCCAT GGATGCAGGA TATGGTCGTG GACGTAGGAC CGCCGCTGGC
    ATCGCCAACG CCAGACGCGA GGTACCGGTT GAACGAAGGA CACTGCCAAC AGACCTTCCA
    GGTCCATCGC TACGTCGACC TTTCACCAAG CGTCAAACAT CTTCGACCGA CGCCTGTTCT
    TCAGGTTGCA ATGTTAATGT TGGTGGAGGT CTAAGCGGAG GGGGAAGTGG AAATGGAGGT
    GGTAATATTG TCACCACAGG TTCCGCGATG CAAACAAGCT GCTCCCTGCC GGAGACGCCA
    GTATTCGCCC GCGGCAACGA CATACCAAGG ACACCGCAAC ATACCGTCGG AAATCCAACA
    CAGCCGCGTA GACAACCCGG ATGGTATGCG CCTACCACCG CCACCACTGG ATATAGAAGA
    AATAACCCCG GGTTGGAACA GGCAATAATC GGAACGGAGT TACTGCGACT TGCGGGTGGC
    CCGAATCGCG GTTGGTACCC GACGCGCAAA TCTAACCAAC CACGGCCGGC TTCGATCGAA
    CACCTCGAAC GTCTCAACTG CGCCTATGAT CCGAGACTCC TAGGCGCCAG TGAGCAGAGG
    AAGCCCCTGA CCCTCCCGAC TAACATCACG CCCAACAAGT ACTTCGGCCA AAGTAAGCAC
    AGCTCCGCCT CCAGTACTCG TGAGGCACTA CGGAGGGTTA CTAGCTTGCT CATCAAGAAA
    GGGGGTGGAA ATAAAGATGG GAAAAATAGC AAGGACAATC TTTCGCCATC CGGTCCTTAC
    GCTGTTGTTC CAGGTATCGA GACTAACGAT GCGCCGAAAA AGAAAGGTTT CTTCAAGAAT
    TTCTGGAAGC GCTCACGTCA CTACTCTCTA GAGAACCAAT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.