LOC105364459 cDNA ORF clone, Ceratosolen solmsi marchali

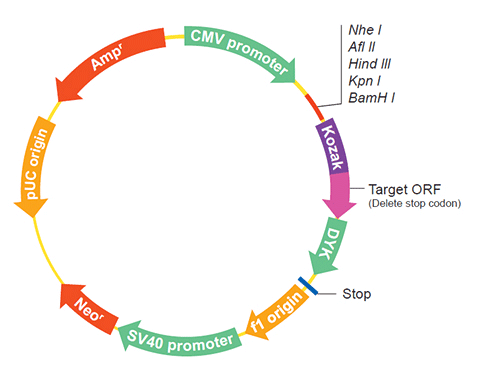
The following LOC105364459 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105364459 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe200168 XM_011502379.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCe200168 XM_011502376.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCe200168 XM_011502375.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCe200168 XM_011502377.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCe200169 XM_011502380.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
OCe200170 XM_011502381.1
Latest version!
Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe200168
    Clone ID Related Accession (Same CDS sequence) XM_011502375.1 , XM_011502379.1 , XM_011502376.1 , XM_011502377.1
    Accession Version XM_011502375.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2784bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
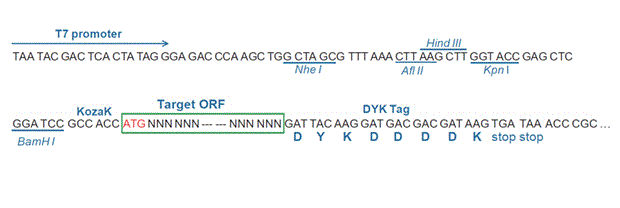
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500677.1
    CDS533..3316
    Translation

    Target ORF information:

    RefSeq Version XM_011502375.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502375.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe200168
    Clone ID Related Accession (Same CDS sequence) XM_011502375.1 , XM_011502379.1 , XM_011502376.1 , XM_011502377.1
    Accession Version XM_011502379.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2784bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500681.1
    CDS393..3176
    Translation

    Target ORF information:

    RefSeq Version XM_011502379.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502379.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe200168
    Clone ID Related Accession (Same CDS sequence) XM_011502375.1 , XM_011502379.1 , XM_011502376.1 , XM_011502377.1
    Accession Version XM_011502376.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2784bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_011500678.1
    CDS576..3359
    Translation

    Target ORF information:

    RefSeq Version XM_011502376.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502376.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe200168
    Clone ID Related Accession (Same CDS sequence) XM_011502375.1 , XM_011502379.1 , XM_011502376.1 , XM_011502377.1
    Accession Version XM_011502377.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2784bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500679.1
    CDS499..3282
    Translation

    Target ORF information:

    RefSeq Version XM_011502377.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502377.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGTAGGTCTT TGAGACGCCC TCCTAGCACC
    CAGCCACCAG CCCCCTCTCA CGCTCCCCTC TCACCCACAG GGAACCTGCC TATTGGGGGG
    ATAGAGCTTT TTCCGGGTCG TATCCCCGAG TCGCCGCTTA TCCGCGCGGC TGCGCTGCGG
    AAGCCGAGTC CGCCGCTTCT CTCCAAGGAA GCGCCCTCGA GCATCGTGAT AAAGCAGGGT
    CCGCTAGATA AGCGCGAGAA GGCCCGCGAG CGGAAGGACA AGGGCCCGAC CAAGGAAGAG
    GTGATGAAGA AGGTCAATGC CATGATGGAC GAGTACGTCG CACAGGGGAA TCTGACTGAG
    GCAGTTGCGG CTTTCAAGGA GCTCAAGATA CCCGAGCGTT TCCTACGCTA CGCCGTCTGC
    ACCGTCTATT CTAGCAGTCT CGAGCGCAGC GACGCCGAGC GCAACCTCGC GGCCGACCTC
    GCCAGTCAGC TGCGCAAGGA GACTCTTTTC AGCGCCCAGC AGTACCACGA CGGCTGGAAA
    GAAGTCGTGA ACTCGATGGC TGAGAAGGAA AGCGCGATAC CCTGTGTCGC CTCCCACATT
    GCGCACCTGA CCGCGCGCGC CATTACCGAC GGCATGATGC AGCTCGCCGA CCTGGCTAAC
    GTCACCGAGA ACGGCCAGCA TTATCCGCTA TTCCTTCTCA CACTACAGCA GCTGCACAAG
    AGCCAGGGCA AGGCCGCGCT CACCCAGATT TTCAACGAGA GCAAGCTCAA TCTCATCAGC
    CAGTTGCCGG AGGCCGACAA GACCAAGGAA CGCCTCGGTG AGATCCTCGA GGACAGGGAT
    CTCACCTTCC TCTACCCGCT TTTGAGAATT CAAGGCGACA TGTGGCGTCA GCTCGAGAGC
    GATCCAGCGC CAAATAGCCT CTACAAGTGG ATCAAGGAGA AGCTCGATCT CTCGCACCAT
    TCCGATCCCG GTTTTATCAA TGCTCTTATT ACAGTTCTAC TTAAATACAT TACTCAGGAA
    ACAACATTCC CATCTGGAAC TAATCCATCC ATCATCCCTG AGAAAGCATT GCAAGAAAAA
    GAATTAGCCT TGTTGGGTAA ATACCAACGA ATGCTACAGA CACTTCTGCC AACCATCGAA
    TCCCAGGTCA CTGCCGTGCA TTCACTTCAA GTCTTTTGCT TGTCGCACAA CTTTCCTAAG
    GGAATGCTAT TACGTTGGTT TATAGCACTT TACAATCTTT CAATTATCGA TGAAGAGGCC
    TTCATGCGTT GGAAAGAAGA CGTCAACGAC GCCTATCCAG GGAAGGGTGA TGCCTTGTTC
    CAGGTGAATG CCTGGTTAAC ATGGCTAGCT GAGCAACCTT CCGAAGATGA GGATGATGAA
    GACGACGAAA AAGGCGACAA CTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe200169
    Clone ID Related Accession (Same CDS sequence) XM_011502380.1
    Accession Version XM_011502380.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2715bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGGAACCTGC CTATTGGGGG GATAGAGCTT
    TTTCCGGGTC GTATCCCCGA GTCGCCGCTT ATCCGCGCGG CTGCGCTGCG GAAGCCGAGT
    CCGCCGCTTC TCTCCAAGGA AGCGCCCTCG AGCATCGTGA TAAAGCAGGG TCCGCTAGAT
    AAGCGCGAGA AGGCCCGCGA GCGGAAGGAC AAGGGCCCGA CCAAGGAAGA GGTGATGAAG
    AAGGTCAATG CCATGATGGA CGAGTACGTC GCACAGGGGA ATCTGACTGA GGCAGTTGCG
    GCTTTCAAGG AGCTCAAGAT ACCCGAGCGT TTCCTACGCT ACGCCGTCTG CACCGTCTAT
    TCTAGCAGTC TCGAGCGCAG CGACGCCGAG CGCAACCTCG CGGCCGACCT CGCCAGTCAG
    CTGCGCAAGG AGACTCTTTT CAGCGCCCAG CAGTACCACG ACGGCTGGAA AGAAGTCGTG
    AACTCGATGG CTGAGAAGGA AAGCGCGATA CCCTGTGTCG CCTCCCACAT TGCGCACCTG
    ACCGCGCGCG CCATTACCGA CGGCATGATG CAGCTCGCCG ACCTGGCTAA CGTCACCGAG
    AACGGCCAGC ATTATCCGCT ATTCCTTCTC ACACTACAGC AGCTGCACAA GAGCCAGGGC
    AAGGCCGCGC TCACCCAGAT TTTCAACGAG AGCAAGCTCA ATCTCATCAG CCAGTTGCCG
    GAGGCCGACA AGACCAAGGA ACGCCTCGGT GAGATCCTCG AGGACAGGGA TCTCACCTTC
    CTCTACCCGC TTTTGAGAAT TCAAGGCGAC ATGTGGCGTC AGCTCGAGAG CGATCCAGCG
    CCAAATAGCC TCTACAAGTG GATCAAGGAG AAGCTCGATC TCTCGCACCA TTCCGATCCC
    GGTTTTATCA ATGCTCTTAT TACAGTTCTA CTTAAATACA TTACTCAGGA AACAACATTC
    CCATCTGGAA CTAATCCATC CATCATCCCT GAGAAAGCAT TGCAAGAAAA AGAATTAGCC
    TTGTTGGGTA AATACCAACG AATGCTACAG ACACTTCTGC CAACCATCGA ATCCCAGGTC
    ACTGCCGTGC ATTCACTTCA AGTCTTTTGC TTGTCGCACA ACTTTCCTAA GGGAATGCTA
    TTACGTTGGT TTATAGCACT TTACAATCTT TCAATTATCG ATGAAGAGGC CTTCATGCGT
    TGGAAAGAAG ACGTCAACGA CGCCTATCCA GGGAAGGGTG ATGCCTTGTT CCAGGTGAAT
    GCCTGGTTAA CATGGCTAGC TGAGCAACCT TCCGAAGATG AGGATGATGA AGACGACGAA
    AAAGGCGACA ACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500682.1
    CDS533..3247
    Translation

    Target ORF information:

    RefSeq Version XM_011502380.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502380.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    ATGCCTTCCA GGGACGATAA TCGCTCCCTA TCCACTGAGC AACGCTGGGT CCCTCCTTCA 
    ACTATTAGAC GCGATGCGCT CACCCCAGAA AACAGAAGTG ATGTCCTCCA CAGAAAGGTG
    CGGGGTATTC TTAACAAGCT CACCCCGGAA AAGTTCGCAA AGCTGAGCAA CGAATTGCTC
    AATCTTGATC TCACTTCTCA TGATATTCTT AGAGGCCTCA TATATTTGAT CTTCGACAAA
    GCTCTCGATG AACCGAAATA CAGTTCTATG TACGCACAGC TGTGCAAGCG GCTGTCCGAA
    GAGGCTTCGA ACTTGGAGAA CTTGCAGAAG CATGGCGGCA ACATCGGTCA TGGCTTCCAC
    AGCCACATCG GAATCAACCA TCTCGAACTT GGCGAGAGCG ACTCAGAGAG CAAATTCACG
    CGTATGCTGC TCAACACGTG CCGGCACGAG TTCGACAACC GCTCAAAGGC GAATGAGGCA
    TACGAGAGCC TGGGGGATCT CAGTCCGGAG GACGAGGAGC GCCGGCAGGC GTCCAAGCGC
    AAGATGCTCG GCAACATCAA ATTTATCGGG GAGCTCGGCA AGCTTAAGAT CGTCGCTAAC
    CCGACCCTTC ACAAGTGCAT CCAACAGCTT TTGTATCATA CGAGGCGCAG CGGATCCCGG
    GGGGACCCCA CCGAGGAGAT CGAGTGCCTC TGCCAGATCA TGCGCACCTG CGGCCGCGTC
    CTCGACACGG ACAAGAGTGC TCTGCTCATG GAACAGTACT TCAGCCGTAT GAGCCGGATG
    GCTAAGCGGG AGGACCTGCC ACAGCGCATC CGCTTTATGC TGCGAGACGT GATCGAGCTG
    AGGCTCAACG GCTGGATGCC ACGCAAGGCG ACGAGCACCG AGGGTCCCAT GCCCATTAAC
    CAAATTCGCA ACGACGGGGA CGATCACTCA CGGTCCGGCG GGGGCATGGG TCCTGGTGGT
    CCAGGCGGCT ATTACGGCCG CAATCGAGAC GACGGGGGCC GCTCCATGGG TAACGACTTC
    TTTCGGCGCA TGGGCCGGGT GAGCCTCGAC GTTGATAGTC TGGGCATCAT ACCGCTTAGC
    ACGCCGGGCT TCGTCAGCTC GGCCTTCAGC CCCAATGGCT TTCGTTCGGG CTCTCCGCCC
    GGTGTCGCTG GCTACGGTCG ACACGGACAA CGGGGCCAAT CGGTGGCCTT TTACCCCACC
    CAGATCAAGC ATCCGAACAA TTACCAGGGC AAGCACGGCC AACAGCAGCA CGGCTCGCCC
    CAGAATTACA ACAATGGAAA TAAGGAGCCG GTGCGCTTCA ACAAGAACAA AATGCTTATC
    GGTCCACCGG AGGAGGTTTC CCTTAGACCT TCGGCCAATT CTATGATCTT CAAGCAGCCC
    AATATCAGCC CCAGTCTGCC GCTCAACAAC AGGAACCTGC CTATTGGGGG GATAGAGCTT
    TTTCCGGGTC GTATCCCCGA GTCGCCGCTT ATCCGCGCGG CTGCGCTGCG GAAGCCGAGT
    CCGCCGCTTC TCTCCAAGGA AGCGCCCTCG AGCATCGTGA TAAAGCAGGG TCCGCTAGAT
    AAGCGCGAGA AGGCCCGCGA GCGGAAGGAC AAGGGCCCGA CCAAGGAAGA GGTGATGAAG
    AAGGTCAATG CCATGATGGA CGAGTACGTC GCACAGGGGA ATCTGACTGA GGCAGTTGCG
    GCTTTCAAGG AGCTCAAGAT ACCCGAGCGT TTCCTACGCT ACGCCGTCTG CACCGTCTAT
    TCTAGCAGTC TCGAGCGCAG CGACGCCGAG CGCAACCTCG CGGCCGACCT CGCCAGTCAG
    CTGCGCAAGG AGACTCTTTT CAGCGCCCAG CAGTACCACG ACGGCTGGAA AGAAGTCGTG
    AACTCGATGG CTGAGAAGGA AAGCGCGATA CCCTGTGTCG CCTCCCACAT TGCGCACCTG
    ACCGCGCGCG CCATTACCGA CGGCATGATG CAGCTCGCCG ACCTGGCTAA CGTCACCGAG
    AACGGCCAGC ATTATCCGCT ATTCCTTCTC ACACTACAGC AGCTGCACAA GAGCCAGGGC
    AAGGCCGCGC TCACCCAGAT TTTCAACGAG AGCAAGCTCA ATCTCATCAG CCAGTTGCCG
    GAGGCCGACA AGACCAAGGA ACGCCTCGGT GAGATCCTCG AGGACAGGGA TCTCACCTTC
    CTCTACCCGC TTTTGAGAAT TCAAGGCGAC ATGTGGCGTC AGCTCGAGAG CGATCCAGCG
    CCAAATAGCC TCTACAAGTG GATCAAGGAG AAGCTCGATC TCTCGCACCA TTCCGATCCC
    GGTTTTATCA ATGCTCTTAT TACAGTTCTA CTTAAATACA TTACTCAGGA AACAACATTC
    CCATCTGGAA CTAATCCATC CATCATCCCT GAGAAAGCAT TGCAAGAAAA AGAATTAGCC
    TTGTTGGGTA AATACCAACG AATGCTACAG ACACTTCTGC CAACCATCGA ATCCCAGGTC
    ACTGCCGTGC ATTCACTTCA AGTCTTTTGC TTGTCGCACA ACTTTCCTAA GGGAATGCTA
    TTACGTTGGT TTATAGCACT TTACAATCTT TCAATTATCG ATGAAGAGGC CTTCATGCGT
    TGGAAAGAAG ACGTCAACGA CGCCTATCCA GGGAAGGGTG ATGCCTTGTT CCAGGTGAAT
    GCCTGGTTAA CATGGCTAGC TGAGCAACCT TCCGAAGATG AGGATGATGA AGACGACGAA
    AAAGGCGACA ACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCe200170
    Clone ID Related Accession (Same CDS sequence) XM_011502381.1
    Accession Version XM_011502381.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2517bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product eukaryotic translation initiation factor 4 gamma 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGTACGCAC AGCTGTGCAA GCGGCTGTCC GAAGAGGCTT CGAACTTGGA GAACTTGCAG 
    AAGCATGGCG GCAACATCGG TCATGGCTTC CACAGCCACA TCGGAATCAA CCATCTCGAA
    CTTGGCGAGA GCGACTCAGA GAGCAAATTC ACGCGTATGC TGCTCAACAC GTGCCGGCAC
    GAGTTCGACA ACCGCTCAAA GGCGAATGAG GCATACGAGA GCCTGGGGGA TCTCAGTCCG
    GAGGACGAGG AGCGCCGGCA GGCGTCCAAG CGCAAGATGC TCGGCAACAT CAAATTTATC
    GGGGAGCTCG GCAAGCTTAA GATCGTCGCT AACCCGACCC TTCACAAGTG CATCCAACAG
    CTTTTGTATC ATACGAGGCG CAGCGGATCC CGGGGGGACC CCACCGAGGA GATCGAGTGC
    CTCTGCCAGA TCATGCGCAC CTGCGGCCGC GTCCTCGACA CGGACAAGAG TGCTCTGCTC
    ATGGAACAGT ACTTCAGCCG TATGAGCCGG ATGGCTAAGC GGGAGGACCT GCCACAGCGC
    ATCCGCTTTA TGCTGCGAGA CGTGATCGAG CTGAGGCTCA ACGGCTGGAT GCCACGCAAG
    GCGACGAGCA CCGAGGGTCC CATGCCCATT AACCAAATTC GCAACGACGG GGACGATCAC
    TCACGGTCCG GCGGGGGCAT GGGTCCTGGT GGTCCAGGCG GCTATTACGG CCGCAATCGA
    GACGACGGGG GCCGCTCCAT GGGTAACGAC TTCTTTCGGC GCATGGGCCG GGTGAGCCTC
    GACGTTGATA GTCTGGGCAT CATACCGCTT AGCACGCCGG GCTTCGTCAG CTCGGCCTTC
    AGCCCCAATG GCTTTCGTTC GGGCTCTCCG CCCGGTGTCG CTGGCTACGG TCGACACGGA
    CAACGGGGCC AATCGGTGGC CTTTTACCCC ACCCAGATCA AGCATCCGAA CAATTACCAG
    GGCAAGCACG GCCAACAGCA GCACGGCTCG CCCCAGAATT ACAACAATGG AAATAAGGAG
    CCGGTGCGCT TCAACAAGAA CAAAATGCTT ATCGGTCCAC CGGAGGAGGT TTCCCTTAGA
    CCTTCGGCCA ATTCTATGAT CTTCAAGCAG CCCAATATCA GCCCCAGTCT GCCGCTCAAC
    AACAGTAGGT CTTTGAGACG CCCTCCTAGC ACCCAGCCAC CAGCCCCCTC TCACGCTCCC
    CTCTCACCCA CAGGGAACCT GCCTATTGGG GGGATAGAGC TTTTTCCGGG TCGTATCCCC
    GAGTCGCCGC TTATCCGCGC GGCTGCGCTG CGGAAGCCGA GTCCGCCGCT TCTCTCCAAG
    GAAGCGCCCT CGAGCATCGT GATAAAGCAG GGTCCGCTAG ATAAGCGCGA GAAGGCCCGC
    GAGCGGAAGG ACAAGGGCCC GACCAAGGAA GAGGTGATGA AGAAGGTCAA TGCCATGATG
    GACGAGTACG TCGCACAGGG GAATCTGACT GAGGCAGTTG CGGCTTTCAA GGAGCTCAAG
    ATACCCGAGC GTTTCCTACG CTACGCCGTC TGCACCGTCT ATTCTAGCAG TCTCGAGCGC
    AGCGACGCCG AGCGCAACCT CGCGGCCGAC CTCGCCAGTC AGCTGCGCAA GGAGACTCTT
    TTCAGCGCCC AGCAGTACCA CGACGGCTGG AAAGAAGTCG TGAACTCGAT GGCTGAGAAG
    GAAAGCGCGA TACCCTGTGT CGCCTCCCAC ATTGCGCACC TGACCGCGCG CGCCATTACC
    GACGGCATGA TGCAGCTCGC CGACCTGGCT AACGTCACCG AGAACGGCCA GCATTATCCG
    CTATTCCTTC TCACACTACA GCAGCTGCAC AAGAGCCAGG GCAAGGCCGC GCTCACCCAG
    ATTTTCAACG AGAGCAAGCT CAATCTCATC AGCCAGTTGC CGGAGGCCGA CAAGACCAAG
    GAACGCCTCG GTGAGATCCT CGAGGACAGG GATCTCACCT TCCTCTACCC GCTTTTGAGA
    ATTCAAGGCG ACATGTGGCG TCAGCTCGAG AGCGATCCAG CGCCAAATAG CCTCTACAAG
    TGGATCAAGG AGAAGCTCGA TCTCTCGCAC CATTCCGATC CCGGTTTTAT CAATGCTCTT
    ATTACAGTTC TACTTAAATA CATTACTCAG GAAACAACAT TCCCATCTGG AACTAATCCA
    TCCATCATCC CTGAGAAAGC ATTGCAAGAA AAAGAATTAG CCTTGTTGGG TAAATACCAA
    CGAATGCTAC AGACACTTCT GCCAACCATC GAATCCCAGG TCACTGCCGT GCATTCACTT
    CAAGTCTTTT GCTTGTCGCA CAACTTTCCT AAGGGAATGC TATTACGTTG GTTTATAGCA
    CTTTACAATC TTTCAATTAT CGATGAAGAG GCCTTCATGC GTTGGAAAGA AGACGTCAAC
    GACGCCTATC CAGGGAAGGG TGATGCCTTG TTCCAGGTGA ATGCCTGGTT AACATGGCTA
    GCTGAGCAAC CTTCCGAAGA TGAGGATGAT GAAGACGACG AAAAAGGCGA CAACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500683.1
    CDS333..2849
    Translation

    Target ORF information:

    RefSeq Version XM_011502381.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali eukaryotic translation initiation factor 4 gamma 2 (LOC105364459), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502381.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGTACGCAC AGCTGTGCAA GCGGCTGTCC GAAGAGGCTT CGAACTTGGA GAACTTGCAG 
    AAGCATGGCG GCAACATCGG TCATGGCTTC CACAGCCACA TCGGAATCAA CCATCTCGAA
    CTTGGCGAGA GCGACTCAGA GAGCAAATTC ACGCGTATGC TGCTCAACAC GTGCCGGCAC
    GAGTTCGACA ACCGCTCAAA GGCGAATGAG GCATACGAGA GCCTGGGGGA TCTCAGTCCG
    GAGGACGAGG AGCGCCGGCA GGCGTCCAAG CGCAAGATGC TCGGCAACAT CAAATTTATC
    GGGGAGCTCG GCAAGCTTAA GATCGTCGCT AACCCGACCC TTCACAAGTG CATCCAACAG
    CTTTTGTATC ATACGAGGCG CAGCGGATCC CGGGGGGACC CCACCGAGGA GATCGAGTGC
    CTCTGCCAGA TCATGCGCAC CTGCGGCCGC GTCCTCGACA CGGACAAGAG TGCTCTGCTC
    ATGGAACAGT ACTTCAGCCG TATGAGCCGG ATGGCTAAGC GGGAGGACCT GCCACAGCGC
    ATCCGCTTTA TGCTGCGAGA CGTGATCGAG CTGAGGCTCA ACGGCTGGAT GCCACGCAAG
    GCGACGAGCA CCGAGGGTCC CATGCCCATT AACCAAATTC GCAACGACGG GGACGATCAC
    TCACGGTCCG GCGGGGGCAT GGGTCCTGGT GGTCCAGGCG GCTATTACGG CCGCAATCGA
    GACGACGGGG GCCGCTCCAT GGGTAACGAC TTCTTTCGGC GCATGGGCCG GGTGAGCCTC
    GACGTTGATA GTCTGGGCAT CATACCGCTT AGCACGCCGG GCTTCGTCAG CTCGGCCTTC
    AGCCCCAATG GCTTTCGTTC GGGCTCTCCG CCCGGTGTCG CTGGCTACGG TCGACACGGA
    CAACGGGGCC AATCGGTGGC CTTTTACCCC ACCCAGATCA AGCATCCGAA CAATTACCAG
    GGCAAGCACG GCCAACAGCA GCACGGCTCG CCCCAGAATT ACAACAATGG AAATAAGGAG
    CCGGTGCGCT TCAACAAGAA CAAAATGCTT ATCGGTCCAC CGGAGGAGGT TTCCCTTAGA
    CCTTCGGCCA ATTCTATGAT CTTCAAGCAG CCCAATATCA GCCCCAGTCT GCCGCTCAAC
    AACAGTAGGT CTTTGAGACG CCCTCCTAGC ACCCAGCCAC CAGCCCCCTC TCACGCTCCC
    CTCTCACCCA CAGGGAACCT GCCTATTGGG GGGATAGAGC TTTTTCCGGG TCGTATCCCC
    GAGTCGCCGC TTATCCGCGC GGCTGCGCTG CGGAAGCCGA GTCCGCCGCT TCTCTCCAAG
    GAAGCGCCCT CGAGCATCGT GATAAAGCAG GGTCCGCTAG ATAAGCGCGA GAAGGCCCGC
    GAGCGGAAGG ACAAGGGCCC GACCAAGGAA GAGGTGATGA AGAAGGTCAA TGCCATGATG
    GACGAGTACG TCGCACAGGG GAATCTGACT GAGGCAGTTG CGGCTTTCAA GGAGCTCAAG
    ATACCCGAGC GTTTCCTACG CTACGCCGTC TGCACCGTCT ATTCTAGCAG TCTCGAGCGC
    AGCGACGCCG AGCGCAACCT CGCGGCCGAC CTCGCCAGTC AGCTGCGCAA GGAGACTCTT
    TTCAGCGCCC AGCAGTACCA CGACGGCTGG AAAGAAGTCG TGAACTCGAT GGCTGAGAAG
    GAAAGCGCGA TACCCTGTGT CGCCTCCCAC ATTGCGCACC TGACCGCGCG CGCCATTACC
    GACGGCATGA TGCAGCTCGC CGACCTGGCT AACGTCACCG AGAACGGCCA GCATTATCCG
    CTATTCCTTC TCACACTACA GCAGCTGCAC AAGAGCCAGG GCAAGGCCGC GCTCACCCAG
    ATTTTCAACG AGAGCAAGCT CAATCTCATC AGCCAGTTGC CGGAGGCCGA CAAGACCAAG
    GAACGCCTCG GTGAGATCCT CGAGGACAGG GATCTCACCT TCCTCTACCC GCTTTTGAGA
    ATTCAAGGCG ACATGTGGCG TCAGCTCGAG AGCGATCCAG CGCCAAATAG CCTCTACAAG
    TGGATCAAGG AGAAGCTCGA TCTCTCGCAC CATTCCGATC CCGGTTTTAT CAATGCTCTT
    ATTACAGTTC TACTTAAATA CATTACTCAG GAAACAACAT TCCCATCTGG AACTAATCCA
    TCCATCATCC CTGAGAAAGC ATTGCAAGAA AAAGAATTAG CCTTGTTGGG TAAATACCAA
    CGAATGCTAC AGACACTTCT GCCAACCATC GAATCCCAGG TCACTGCCGT GCATTCACTT
    CAAGTCTTTT GCTTGTCGCA CAACTTTCCT AAGGGAATGC TATTACGTTG GTTTATAGCA
    CTTTACAATC TTTCAATTAT CGATGAAGAG GCCTTCATGC GTTGGAAAGA AGACGTCAAC
    GACGCCTATC CAGGGAAGGG TGATGCCTTG TTCCAGGTGA ATGCCTGGTT AACATGGCTA
    GCTGAGCAAC CTTCCGAAGA TGAGGATGAT GAAGACGACG AAAAAGGCGA CAACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.