LOC105364405 cDNA ORF clone, Ceratosolen solmsi marchali

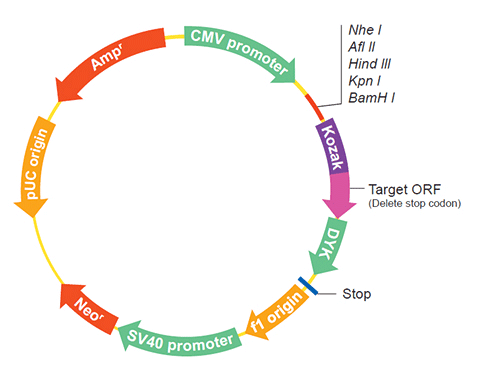
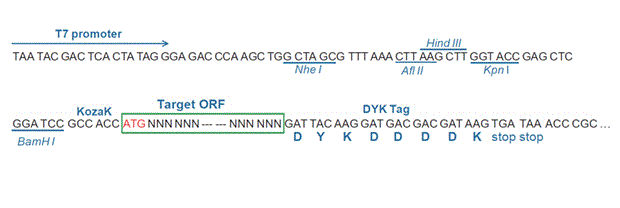
The following LOC105364405 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105364405 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCe192286 XM_011502321.1
Latest version!
Ceratosolen solmsi marchali putative DNA helicase Ino80 (LOC105364405), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $1021.30
$1459.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCe192286
    Clone ID Related Accession (Same CDS sequence) XM_011502321.1
    Accession Version XM_011502321.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 5241bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-03-08
    Organism Ceratosolen solmsi marchali
    Product putative DNA helicase Ino80
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_011948412.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Ceratosolen solmsi marchali Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 1% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    5221
    ATGAAGAAGG GAAACAAGCC GCACGAGCAC GTCCTAAGAT CGGCAGAGCT GGAAAACGGA 
    AACGATGGAA CGCAATTTTC GCGGCGACAG CACCGAACCG CAGCGGCAGC GCCATCTACT
    GAAAACAAAT ATGATTTTGA AACTGTTATG ACTGACCGAA CTCGAGCGAT GGGATTAGAA
    GCAGAGATGG CTGCTCCGTT GCATTTACAG CGACTGGAGC GCAGTTTAAA TATACAGCCT
    TTTTTAAGTC AAGTTAACGA CCTTTTTCAA GAGCAAATCA GCGACGAAGA TGAGTCCTCC
    GAAGACGAGT CTGCAGAGTC GGAAACGGAT ATCAATGAGT TAATATCGCA GAAAGATGAA
    AAAAGAAACA ATAAGCTACG TTTGTATAAT ATGAGTAACG TTGGAGAAGA AAGACACTGG
    TTACAAGATA TTTTGTTAAG CGATGGAACC GATACTTCTT CGGGCTCGGA CACGGATGGA
    TCTATAACAG AAGAGGATTT TCAAAATATG TTAAAATTTC ATATGTTGAG GAAGAAATAT
    CAGGCCCGTT TCTATCAGAA GCCAGAGAAC ATACAGTATC AGTATTATGG AGCAGGATTA
    TTGTCAAATT ATGACAGATT TTTAGAACAT CAGAAACTTA TCGTAGGAAA TAAAAAGAAA
    AAAGAGAAGA AACCAGAAAA GAAAGTAGTA AAAATGAAAA AAGAAAGAGT TACACACCAT
    AAGGTTTCCC ACGATGGCAA GCAAAAATAT CCTGACGAGA ATTGGGATAA AGGGAAGACA
    CAAGATCATT TAGATGACTC AGAATTAGAA TTAGTTTTAA AACATCAACC GCGAGGCCGT
    GGAAGGAAAA AGCATAATAA TAAAAGTCCA GAGGTGATGG CCATTCGGAG ACGTAAAATT
    TGGGTAATGA TGTCGAAGAA AGAGCTTGGT AAGGTTCAGA GGGCCAAAAC TAATAATCAT
    AAGGAAATGC TTATCAGTTG CAAAAAGGTG GCCCAACACT GTATGAAATA TTGGAGGCAA
    AAAGCTATGC AATCTCAGAA AAATATGAAA GAAACGATAT GGAGAGCAAA GAGATTGACT
    AGGGAAATGC AATCTTATTG GAAACGATAT GATCGCGTGG AGAGAGAAAC CAGAAGAAGA
    TTGGAAAAAG AAGCAGAAGA GCAACGTAAA ATGGACGTTG AATTGATTGA AGCAAAACGC
    CAGCAGAGAA AGTTAAATTT TTTAATTACG CAGACCGAGC TCTATGCTCA TTTCATGTCA
    AGAAAATTAG GCAAGGCTTC TCCCGAAGAG CAGTTACGGA TTTTAAATCA ACTGGATGAA
    GAAAAAAATC CAAGACTTGC CAGCATCGAT GATTACGATA GCGAAGCCAT GAAGCAAAAG
    GCGAAAAAAA ATGCAATAGA TGCATTTGAT AACGAAAAGG CGAGAACTCG TCAATTCGAT
    CCAGCAACTA ATCAGGAATT ACGCTTAAGT GATACTCCAG AAACGTTAGA ACACCCTCAA
    CCGTCAATTT TCAAAGGAAA TTTAAAAGGT TATCAATTAA AAGGCATGAA TTGGCTAGCA
    AATCTCTACG ATCAGGGCAT TAGTGGTATT TTAGCTGATG AAATGGGCTT AGGCAAAACC
    GTTCAGTCCA TAGCTTTTTT ATGTCACATT GCTGAGAAAT ACTCTGTGTG GGGACCATTT
    TTAATCATCT CGCCCGCTTC TACGTTGCAC AATTGGCAAC AAGAGATGGC ACGATTCGTG
    CCGGTGTTTA AAGTCGTACC CTATTGGGGT AATCCTCAAG AGCGGAAAAT TTTACGCCAG
    TTTTGGGACA CCAAGGATCT ACATACAAAG GAGGCATCGT TTCACGTCGT AATCACGAGT
    TATCAATTAG TTATAACAGA TTATAAATAC TTTAACAGAA TTAAGTGGCA GTATATGATT
    CTTGATGAAG CACAGGCGAT TAAAAGTACT AGCAGTATGA GATGGAAACT TTTATTGGGA
    TTTAGTTGTC GCAATCGTCT ACTGCTCAGT GGCACGCCAA TTCAAAATAG CATGGCCGAG
    TTATGGGCCC TTCTTCACTT TATTATGCCT ACCTTATTCG ATTCCCACGA TGAATTTAAC
    GAATGGTTTT CCAAAGATAT CGAAAGTCAT GCTGAAAATA AAACTGGAAT CGATGAAAAA
    CACTTGTCAA GGCTTCATAT GATCTTAAAA CCATTTATGT TGCGAAGAAT AAAAAAGGAC
    GTAGAAAATG AATTATCCGA TAAAATTGAA GTAATGGTTT ATTGTCCGCT TACAACAAGA
    CAAAAATTAC TTTACACGGC ATTGAAAAAG AAAATTAGAA TAGAGGATTT ACTTCATTAT
    TCGGTTGGTG ATAGCGCAAC CAATGATAAA AATTTTACTT CGAATTTAAT GAATCTAGTC
    ATGCAATTTC GTAAAGTTTG CAATCATCCA GAACTTTTTG AACGCCGAGA TGCAAAGTCA
    CCATACTTCA TGCGCACGGA ACTTTTAGAA TTACCATCAT TATTATATAA AGAGGACATT
    ATGAACTCGA CTGTATCGTC CAAAGAGCAT CTGTTGTATA ATAAATTTTT TATATTTGCT
    ACCGAATACA TTTATCGAGC ATTATGTGGT GATAACGACG GCTCAAACAC ATGCTGCTTC
    TCGTTCGCTC GATTTATCAA TTTATCGCCA ATGGAATTAA ATAGTATTTT CATTACTGGA
    ATATTATTCA GGTTAGGCCA TTTAGCGCAG CATATAAAAG TTATGAATGT TAAGCGACAT
    TTGGAAGATT GGTTGGAACA GGGCTCCATA TCTTCTAATA TTATGTGGCT TCTGACAGAA
    AAATTCAATA CATCTTCTCA AATGGCTAAC GACTTAATAT TTACGAGAAG CATTTTGTAC
    GGAGATGCCG TGTATACGCA CGCAACTCAT TCGATTAATT CGATGCCGGA AACTGTCGCT
    CATCGTATAC TTCGTAGCAG TAAGAAAGCC AATCAATCGA TAAAGCTTCA AAGATCTATT
    TGTTCCGTAA AGATAGAGCA AGGCGAAGAA TTGAAAGTTC CGCTATTGCC CGAGCATCCG
    CATACGCCAA GGACACCAAT CCTAAGGCAT TGCCAGCAAA TATCATTACC GGCATTTCTC
    TGCGATAAGA TACCGAAGGT CCTAGCTACC TCGAGGAAGG TTTACATTAG CCATTGTGCC
    GCGTCGCGTG CTTGGCAGAT GCACGAGGAG TGTGGTGGCT TAAGCGGCAA AAGAATATTA
    TGGCTCGGTT GTGATTTAGC TCAGAGCTTA CCGCAAAATC GTATTCATGT ACGTGCAACA
    CTACCAACGC AATTTTCATA TCAACATGTC GGAGGTTTGG CCGCTTGTCG CCCAATGAAT
    GGATGGTCGA ATATTATAGT ACCAGATAAG CAAACTTTAG TGACTGATGC GGGAAAGTTA
    TCCGTACTTG ACAATCTCCT GAAACGGCTC AAAGAACAAG GTCATCGCGT TTTAATATAT
    TCACAAATGA CTAAAATGAT AGATTTATTA GAGGAGTATA TGTATCACCG AAAACATACG
    TTTATGAGAT TAGATGGTTC CTCAAAAATT TCCGATCGTC GTGATATGGT TGCCGATTTT
    CAAAAAAGGA CGGATATATT TGTCTTTCTA CTGAGCACCA GAGCTGGAGG CTTGGGAATC
    AACTTGACGG CTGCGGACAC GGTGATATTC TACGACAGCG ACTGGAACCC AACCGTGGAC
    CAGCAGGCAA TGGACCGGGC ACACAGATTG GGCCAGACGA AGCAGGTGAC GGTATATCGG
    CTCATCTGCA AGGGCACCAT CGAAGAGCGA ATTCTGCAAC GCGCCCGCGA GAAAAGCGAG
    ATTCAACGTA TGGTCATTAG TGGCGGTAAC TTTAAGCCGG ATACGTTAAA GCCGAAGGAG
    GTGGTCTCAT TGCTGCTCGA CGACGAGGAA ATCGAGGCGA AATACAGCCA ACGAAGCGAA
    GAGAGAAAGC AGCACGCCGA GGAGGCCAGA GTCGAGGCGA GCCTACACCA CAAGGAGAGG
    GACCGGAAGA GGAAGCAAAC CGCGTTTCCG GTCAAGAATG ACAGCAAGAG ACTCTGCGTA
    GACGAAGGTG ACGGCAGGGG CGCCAATTCG CACGAGTCCA CAATGCAGCA CTCGGCCTCC
    AGCTTTCAGC AACACGCCGG CAATCATCAG AAGCAGGGCC AGGATGAATT CGGGACTTCC
    GGTTTGCAGA GCCCCGTTAA GTCCGAGGAC GAGACGAGCA ACGAGGGCCT CGTCGTGGAC
    GTGGACGGGC CCGTGATCGG CAGCAGCTAC GCCTCGGGGA TATCCCTAGG GTTGCAGTAC
    GGTCGCGGGG GTGCCGACCC CTCGGACGGC CGTCATCAGC GACCGTTCGG CCATTACCTC
    GGCGGCGGCG GCGGCGGCGG CGGCGTTGGT GGTGGTGGCG GTGGCGGCGG CGGTGGCGGC
    GGCGGTAGCA GCGGCAGCGG TGGCGGCGGC GGTGGCGACG CGAGGATACG CCAAACGATC
    CGCGGTGTCA GCAAGCGAGG TAGACCCCGG GGCTCACGCA GGGGCGGGCC CATTGGCGGC
    AAGGCCCGGG GCATGCTAAT GCTCCATCCG GCTCCTCACT CCAAGGGCCT CGCCACCACG
    TCCGGGGGTA CGAGTATCGG CGCGCCCGGG GCCTTGGCCA CCGCATCGAG TCCTGGCCCA
    CACCAACACG GGGGCACGGA GACGGTGAGC GGTCAGGGTC AAAAGCAACC ACCGCATCAT
    CATCACCACC ACCACCACCA CCACAAGCGT GAACAACAAC AACAGACGCA GCAGCAACAT
    AATCACCATC AACATCACCA TCATCATCAT CATCATCACC ATTATCAGAC GACGTCAGGC
    GGCTCGGGCA AATCGATGTC GGGCATTAGG CGTGGCCCAG GTAGGCCGCG ATTACGACCC
    AACGGGCCCG GTAATCAGGG TTACCGGGCA CCCAGCCATC ATCACTCGCA TGACTCCCAG
    CAGCAGCAGC AGCAGCAGCA GCAACAGCAA CAGCAACAGC AACAGCAACA GCAACAGCAG
    AAACGGAGCT CGAGCTCGTT GCCGCTATCC TTGCCCGTGC CCATCAGACT CCACCCAAAG
    CCAACGGCTC AGGGAGCCAC GACATCGGGG ACCGGCGCTG CTGCCTCCGC CTCCACCACC
    CTCGTCGCTA CCGAGTCCAA GCCTAGCGAG TCCCGACCTT TTGGCTTCTA CACCCAACAG
    ATGCAGCCCG GCGGTACCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_011500623.1
    CDS117..5357
    Translation

    Target ORF information:

    RefSeq Version XM_011502321.1
    Organism Ceratosolen solmsi marchali
    Definition Ceratosolen solmsi marchali putative DNA helicase Ino80 (LOC105364405), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_011502321.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    5101
    5161
    5221
    ATGAAGAAGG GAAACAAGCC GCACGAGCAC GTCCTAAGAT CGGCAGAGCT GGAAAACGGA 
    AACGATGGAA CGCAATTTTC GCGGCGACAG CACCGAACCG CAGCGGCAGC GCCATCTACT
    GAAAACAAAT ATGATTTTGA AACTGTTATG ACTGACCGAA CTCGAGCGAT GGGATTAGAA
    GCAGAGATGG CTGCTCCGTT GCATTTACAG CGACTGGAGC GCAGTTTAAA TATACAGCCT
    TTTTTAAGTC AAGTTAACGA CCTTTTTCAA GAGCAAATCA GCGACGAAGA TGAGTCCTCC
    GAAGACGAGT CTGCAGAGTC GGAAACGGAT ATCAATGAGT TAATATCGCA GAAAGATGAA
    AAAAGAAACA ATAAGCTACG TTTGTATAAT ATGAGTAACG TTGGAGAAGA AAGACACTGG
    TTACAAGATA TTTTGTTAAG CGATGGAACC GATACTTCTT CGGGCTCGGA CACGGATGGA
    TCTATAACAG AAGAGGATTT TCAAAATATG TTAAAATTTC ATATGTTGAG GAAGAAATAT
    CAGGCCCGTT TCTATCAGAA GCCAGAGAAC ATACAGTATC AGTATTATGG AGCAGGATTA
    TTGTCAAATT ATGACAGATT TTTAGAACAT CAGAAACTTA TCGTAGGAAA TAAAAAGAAA
    AAAGAGAAGA AACCAGAAAA GAAAGTAGTA AAAATGAAAA AAGAAAGAGT TACACACCAT
    AAGGTTTCCC ACGATGGCAA GCAAAAATAT CCTGACGAGA ATTGGGATAA AGGGAAGACA
    CAAGATCATT TAGATGACTC AGAATTAGAA TTAGTTTTAA AACATCAACC GCGAGGCCGT
    GGAAGGAAAA AGCATAATAA TAAAAGTCCA GAGGTGATGG CCATTCGGAG ACGTAAAATT
    TGGGTAATGA TGTCGAAGAA AGAGCTTGGT AAGGTTCAGA GGGCCAAAAC TAATAATCAT
    AAGGAAATGC TTATCAGTTG CAAAAAGGTG GCCCAACACT GTATGAAATA TTGGAGGCAA
    AAAGCTATGC AATCTCAGAA AAATATGAAA GAAACGATAT GGAGAGCAAA GAGATTGACT
    AGGGAAATGC AATCTTATTG GAAACGATAT GATCGCGTGG AGAGAGAAAC CAGAAGAAGA
    TTGGAAAAAG AAGCAGAAGA GCAACGTAAA ATGGACGTTG AATTGATTGA AGCAAAACGC
    CAGCAGAGAA AGTTAAATTT TTTAATTACG CAGACCGAGC TCTATGCTCA TTTCATGTCA
    AGAAAATTAG GCAAGGCTTC TCCCGAAGAG CAGTTACGGA TTTTAAATCA ACTGGATGAA
    GAAAAAAATC CAAGACTTGC CAGCATCGAT GATTACGATA GCGAAGCCAT GAAGCAAAAG
    GCGAAAAAAA ATGCAATAGA TGCATTTGAT AACGAAAAGG CGAGAACTCG TCAATTCGAT
    CCAGCAACTA ATCAGGAATT ACGCTTAAGT GATACTCCAG AAACGTTAGA ACACCCTCAA
    CCGTCAATTT TCAAAGGAAA TTTAAAAGGT TATCAATTAA AAGGCATGAA TTGGCTAGCA
    AATCTCTACG ATCAGGGCAT TAGTGGTATT TTAGCTGATG AAATGGGCTT AGGCAAAACC
    GTTCAGTCCA TAGCTTTTTT ATGTCACATT GCTGAGAAAT ACTCTGTGTG GGGACCATTT
    TTAATCATCT CGCCCGCTTC TACGTTGCAC AATTGGCAAC AAGAGATGGC ACGATTCGTG
    CCGGTGTTTA AAGTCGTACC CTATTGGGGT AATCCTCAAG AGCGGAAAAT TTTACGCCAG
    TTTTGGGACA CCAAGGATCT ACATACAAAG GAGGCATCGT TTCACGTCGT AATCACGAGT
    TATCAATTAG TTATAACAGA TTATAAATAC TTTAACAGAA TTAAGTGGCA GTATATGATT
    CTTGATGAAG CACAGGCGAT TAAAAGTACT AGCAGTATGA GATGGAAACT TTTATTGGGA
    TTTAGTTGTC GCAATCGTCT ACTGCTCAGT GGCACGCCAA TTCAAAATAG CATGGCCGAG
    TTATGGGCCC TTCTTCACTT TATTATGCCT ACCTTATTCG ATTCCCACGA TGAATTTAAC
    GAATGGTTTT CCAAAGATAT CGAAAGTCAT GCTGAAAATA AAACTGGAAT CGATGAAAAA
    CACTTGTCAA GGCTTCATAT GATCTTAAAA CCATTTATGT TGCGAAGAAT AAAAAAGGAC
    GTAGAAAATG AATTATCCGA TAAAATTGAA GTAATGGTTT ATTGTCCGCT TACAACAAGA
    CAAAAATTAC TTTACACGGC ATTGAAAAAG AAAATTAGAA TAGAGGATTT ACTTCATTAT
    TCGGTTGGTG ATAGCGCAAC CAATGATAAA AATTTTACTT CGAATTTAAT GAATCTAGTC
    ATGCAATTTC GTAAAGTTTG CAATCATCCA GAACTTTTTG AACGCCGAGA TGCAAAGTCA
    CCATACTTCA TGCGCACGGA ACTTTTAGAA TTACCATCAT TATTATATAA AGAGGACATT
    ATGAACTCGA CTGTATCGTC CAAAGAGCAT CTGTTGTATA ATAAATTTTT TATATTTGCT
    ACCGAATACA TTTATCGAGC ATTATGTGGT GATAACGACG GCTCAAACAC ATGCTGCTTC
    TCGTTCGCTC GATTTATCAA TTTATCGCCA ATGGAATTAA ATAGTATTTT CATTACTGGA
    ATATTATTCA GGTTAGGCCA TTTAGCGCAG CATATAAAAG TTATGAATGT TAAGCGACAT
    TTGGAAGATT GGTTGGAACA GGGCTCCATA TCTTCTAATA TTATGTGGCT TCTGACAGAA
    AAATTCAATA CATCTTCTCA AATGGCTAAC GACTTAATAT TTACGAGAAG CATTTTGTAC
    GGAGATGCCG TGTATACGCA CGCAACTCAT TCGATTAATT CGATGCCGGA AACTGTCGCT
    CATCGTATAC TTCGTAGCAG TAAGAAAGCC AATCAATCGA TAAAGCTTCA AAGATCTATT
    TGTTCCGTAA AGATAGAGCA AGGCGAAGAA TTGAAAGTTC CGCTATTGCC CGAGCATCCG
    CATACGCCAA GGACACCAAT CCTAAGGCAT TGCCAGCAAA TATCATTACC GGCATTTCTC
    TGCGATAAGA TACCGAAGGT CCTAGCTACC TCGAGGAAGG TTTACATTAG CCATTGTGCC
    GCGTCGCGTG CTTGGCAGAT GCACGAGGAG TGTGGTGGCT TAAGCGGCAA AAGAATATTA
    TGGCTCGGTT GTGATTTAGC TCAGAGCTTA CCGCAAAATC GTATTCATGT ACGTGCAACA
    CTACCAACGC AATTTTCATA TCAACATGTC GGAGGTTTGG CCGCTTGTCG CCCAATGAAT
    GGATGGTCGA ATATTATAGT ACCAGATAAG CAAACTTTAG TGACTGATGC GGGAAAGTTA
    TCCGTACTTG ACAATCTCCT GAAACGGCTC AAAGAACAAG GTCATCGCGT TTTAATATAT
    TCACAAATGA CTAAAATGAT AGATTTATTA GAGGAGTATA TGTATCACCG AAAACATACG
    TTTATGAGAT TAGATGGTTC CTCAAAAATT TCCGATCGTC GTGATATGGT TGCCGATTTT
    CAAAAAAGGA CGGATATATT TGTCTTTCTA CTGAGCACCA GAGCTGGAGG CTTGGGAATC
    AACTTGACGG CTGCGGACAC GGTGATATTC TACGACAGCG ACTGGAACCC AACCGTGGAC
    CAGCAGGCAA TGGACCGGGC ACACAGATTG GGCCAGACGA AGCAGGTGAC GGTATATCGG
    CTCATCTGCA AGGGCACCAT CGAAGAGCGA ATTCTGCAAC GCGCCCGCGA GAAAAGCGAG
    ATTCAACGTA TGGTCATTAG TGGCGGTAAC TTTAAGCCGG ATACGTTAAA GCCGAAGGAG
    GTGGTCTCAT TGCTGCTCGA CGACGAGGAA ATCGAGGCGA AATACAGCCA ACGAAGCGAA
    GAGAGAAAGC AGCACGCCGA GGAGGCCAGA GTCGAGGCGA GCCTACACCA CAAGGAGAGG
    GACCGGAAGA GGAAGCAAAC CGCGTTTCCG GTCAAGAATG ACAGCAAGAG ACTCTGCGTA
    GACGAAGGTG ACGGCAGGGG CGCCAATTCG CACGAGTCCA CAATGCAGCA CTCGGCCTCC
    AGCTTTCAGC AACACGCCGG CAATCATCAG AAGCAGGGCC AGGATGAATT CGGGACTTCC
    GGTTTGCAGA GCCCCGTTAA GTCCGAGGAC GAGACGAGCA ACGAGGGCCT CGTCGTGGAC
    GTGGACGGGC CCGTGATCGG CAGCAGCTAC GCCTCGGGGA TATCCCTAGG GTTGCAGTAC
    GGTCGCGGGG GTGCCGACCC CTCGGACGGC CGTCATCAGC GACCGTTCGG CCATTACCTC
    GGCGGCGGCG GCGGCGGCGG CGGCGTTGGT GGTGGTGGCG GTGGCGGCGG CGGTGGCGGC
    GGCGGTAGCA GCGGCAGCGG TGGCGGCGGC GGTGGCGACG CGAGGATACG CCAAACGATC
    CGCGGTGTCA GCAAGCGAGG TAGACCCCGG GGCTCACGCA GGGGCGGGCC CATTGGCGGC
    AAGGCCCGGG GCATGCTAAT GCTCCATCCG GCTCCTCACT CCAAGGGCCT CGCCACCACG
    TCCGGGGGTA CGAGTATCGG CGCGCCCGGG GCCTTGGCCA CCGCATCGAG TCCTGGCCCA
    CACCAACACG GGGGCACGGA GACGGTGAGC GGTCAGGGTC AAAAGCAACC ACCGCATCAT
    CATCACCACC ACCACCACCA CCACAAGCGT GAACAACAAC AACAGACGCA GCAGCAACAT
    AATCACCATC AACATCACCA TCATCATCAT CATCATCACC ATTATCAGAC GACGTCAGGC
    GGCTCGGGCA AATCGATGTC GGGCATTAGG CGTGGCCCAG GTAGGCCGCG ATTACGACCC
    AACGGGCCCG GTAATCAGGG TTACCGGGCA CCCAGCCATC ATCACTCGCA TGACTCCCAG
    CAGCAGCAGC AGCAGCAGCA GCAACAGCAA CAGCAACAGC AACAGCAACA GCAACAGCAG
    AAACGGAGCT CGAGCTCGTT GCCGCTATCC TTGCCCGTGC CCATCAGACT CCACCCAAAG
    CCAACGGCTC AGGGAGCCAC GACATCGGGG ACCGGCGCTG CTGCCTCCGC CTCCACCACC
    CTCGTCGCTA CCGAGTCCAA GCCTAGCGAG TCCCGACCTT TTGGCTTCTA CACCCAACAG
    ATGCAGCCCG GCGGTACCTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.