ASCC2 cDNA ORF clone, Acinonyx jubatus(cheetah)

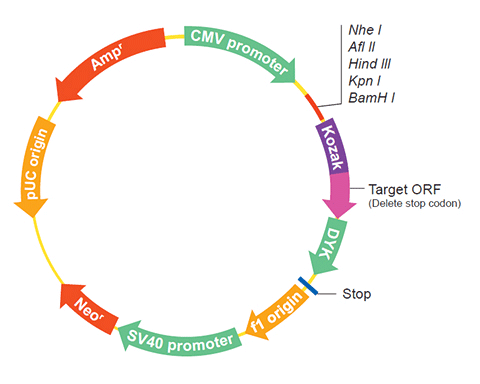
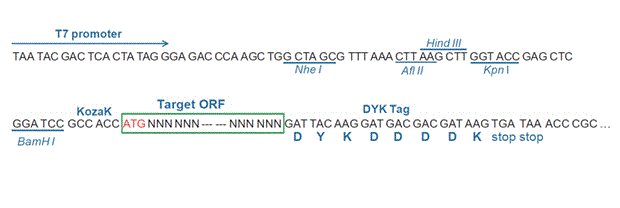
The following ASCC2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ASCC2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAc247715 XM_027050871.1
Latest version!
Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OAc247716 XM_027050872.1
Latest version!
Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OAc54447 XM_015083651.1
Latest version!
Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAc247715
    Clone ID Related Accession (Same CDS sequence) XM_027050871.1
    Accession Version XM_027050871.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2256bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-12
    Organism Acinonyx jubatus(cheetah)
    Product activating signal cointegrator 1 complex subunit 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_020834823.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Acinonyx jubatus Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GCACCCCGAG CAGAAGGCAG ACCGGTATTT TGTGTTATAC
    AAACCGCCCC CTAAAGACAA CATTCCCGCC CTAGTGGAGG AGTACCTGGA ACGCGCCACC
    TTCGTAGCCA ATGACCTCGA CTGGCTCCTG GCCTTGCCTC ACGATAAATT CTGGTGCCAG
    GTTATCTTCG ATGAAACCCT GCAGAAGTGC CTGGACTCCT ATCTGCGCTA TGTCCCCCGA
    AAGTTCGACG AGTGGGTGGC CCCGGCCCCT GAGGTTGTTG ACATGCAGAA ACGGCTCCAT
    CGAAGTGTTT TCCTCACCTT CCTCCGCATG TCCACTCATA AGGAATCCAA AGATCACTTC
    ATTTCCCCCT CTGCATTTGG AGAAATCCTC TACAATAACT TCCTGTTTGA CATCCCAAAG
    ATCCTGGATC TCTGCGTGCT CTTTGGAAAA GGCAACTCGC CATTGCTCCA GAAGATGATA
    GGGAACATCT TTATCCAGCA GCCAAGTTAC TATAATGACC TGGATGAAAC CATGCCCACC
    ATCCTTCAGG TTTTTAGCAA TATCCTCCAG CACTGTGGTT TGCAAGGGGA TGGGGCCAGC
    GCCACACCCC AGAAGCTTGA GGAGAGGGGC CGGTTGACCC CCAGCGACAT GCCTCTCCTG
    GAATTAAAAG ACATTGTTCT CTACCTTTGC GATACCTGCA CTACACTCTG GGCCTTTCTG
    GATATCTTCC CTTTGGCTTG CCAAACCTTC CAGAAACATG ACTTCTGTTA CAGACTAGCT
    TCCTTTTATG AAATTGCAAT TCCCGAACTG GAGTCTGCAA TTAAGAAGAG GAGGCTTGAA
    GATAGCAAGC TGCTAGGTGA CCTGTGGCAG AGGCTGTCCC ATTCCAGGAA GAAGCTACTG
    GAGATTTTTC ACATCCTCAT GAACCATATT TGCCTCCTCC CTGTCCTGGA AAACAGCTGT
    GACAACATTC AGGGCTTCAT CGAAGAGTTC CTGCAGATCT TCAGCTCCTT GCTGCAGGAG
    AAGAGGTTCC TCCGGGACTA CGACACACTC TTCCCTGTGG CCGATGATGT CAGCTTGCTA
    CAACAGGCCT CAGCAGTCTT GGACGAGACT CGGACTGCCT ACATCCTCCA GGCAGTCGAA
    AGTGCTTGGG AAGGGGTGGA CCGACGGAAA GCCAAAGATG CTAAAGACCC ACCGGTGGCT
    GAAGACCCTA ATGGGGTCAT TGCGATGGTG GAACCAGTCA GTGGACCGTT CTCACATCTG
    GAAAACTCAG GGGAAGAGGA GTGTATGGGG GCAGCTGCTC CCTTGGGCCC CCCTGTGTGT
    GGCGTGGAGC TGGACTCACT CATCTCCCAA GTGAAGGACC TGCTGCCAGA TCTTGGTGAG
    GGCTTCATCC TGGCCTGCCT GGAGCATTAC AGCTACAACC CGGAGCAGGT GATCAACAAC
    ATCCTGGAGG AGCGGCTGGC CCCTGCCCTC AGCCAGCTGG ACCGCAGCCT AGACAGACAG
    GTGAAACCAG ACCCGACACC CCTGCTCACA TCTCGTCACA ACGTCTTCCA GAACGATGAG
    TTTGATGTGT TCAGCAGAGA TACAGTGGAC CTGAGCCGGG TGCATAAAGG CAGGAGGAAG
    GAGGAGAACA CGCGGAGCCT GCTGAACGAC AAGCGGGAGG TGGTGGCACA GCGGCAGCGC
    TACGAGCAGT ACAGCGTGGT GGTGGAGGAG GTGCCGCTGC AGCCAGGTGA GGGCCTGCCC
    TATCGCGGGG ATGACTATGA GGATGAGTAC GATGACACGT ACGATGGCAA CCAGGTGGGC
    GCCAACGATG CTGACTCGGA TGATGAGCTC ATCAGCCGCA GGCCCTTCAC CATCCCTCAG
    GTGCTGAGAA CCAAAGTGCC TGGAGAAGGG CAGGAAGAGG ACGAAGATGA GGAGGAGGAG
    GAGGCTGAGG ACGAGGCTCC CAAGCCCGAC CATTTTGTGC AGGACCCAGC AGTGTTGCGG
    GAGAAAGCAG AAGCCAGGCG CATGGCCTTC CTTGCCAGGA AGGGGTACCG GCACGACAGC
    TCCACGGCAG TGGCCGGCAG CCCCCGGGGC CACGGGCAGA ACCGTGAGAC AACCCAGGAA
    CGCAGGAAGA AGGAAGCCAA CAAGGCGACG CGAGCCAACC ATAACCGGAG AACCATGGCT
    GACCGCAAAA GAAGCAAAGG CATGATTCCA TCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_026906672.1
    CDS119..2374
    Translation

    Target ORF information:

    RefSeq Version XM_027050871.1
    Organism Acinonyx jubatus(cheetah)
    Definition Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_027050871.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GCACCCCGAG CAGAAGGCAG ACCGGTATTT TGTGTTATAC
    AAACCGCCCC CTAAAGACAA CATTCCCGCC CTAGTGGAGG AGTACCTGGA ACGCGCCACC
    TTCGTAGCCA ATGACCTCGA CTGGCTCCTG GCCTTGCCTC ACGATAAATT CTGGTGCCAG
    GTTATCTTCG ATGAAACCCT GCAGAAGTGC CTGGACTCCT ATCTGCGCTA TGTCCCCCGA
    AAGTTCGACG AGTGGGTGGC CCCGGCCCCT GAGGTTGTTG ACATGCAGAA ACGGCTCCAT
    CGAAGTGTTT TCCTCACCTT CCTCCGCATG TCCACTCATA AGGAATCCAA AGATCACTTC
    ATTTCCCCCT CTGCATTTGG AGAAATCCTC TACAATAACT TCCTGTTTGA CATCCCAAAG
    ATCCTGGATC TCTGCGTGCT CTTTGGAAAA GGCAACTCGC CATTGCTCCA GAAGATGATA
    GGGAACATCT TTATCCAGCA GCCAAGTTAC TATAATGACC TGGATGAAAC CATGCCCACC
    ATCCTTCAGG TTTTTAGCAA TATCCTCCAG CACTGTGGTT TGCAAGGGGA TGGGGCCAGC
    GCCACACCCC AGAAGCTTGA GGAGAGGGGC CGGTTGACCC CCAGCGACAT GCCTCTCCTG
    GAATTAAAAG ACATTGTTCT CTACCTTTGC GATACCTGCA CTACACTCTG GGCCTTTCTG
    GATATCTTCC CTTTGGCTTG CCAAACCTTC CAGAAACATG ACTTCTGTTA CAGACTAGCT
    TCCTTTTATG AAATTGCAAT TCCCGAACTG GAGTCTGCAA TTAAGAAGAG GAGGCTTGAA
    GATAGCAAGC TGCTAGGTGA CCTGTGGCAG AGGCTGTCCC ATTCCAGGAA GAAGCTACTG
    GAGATTTTTC ACATCCTCAT GAACCATATT TGCCTCCTCC CTGTCCTGGA AAACAGCTGT
    GACAACATTC AGGGCTTCAT CGAAGAGTTC CTGCAGATCT TCAGCTCCTT GCTGCAGGAG
    AAGAGGTTCC TCCGGGACTA CGACACACTC TTCCCTGTGG CCGATGATGT CAGCTTGCTA
    CAACAGGCCT CAGCAGTCTT GGACGAGACT CGGACTGCCT ACATCCTCCA GGCAGTCGAA
    AGTGCTTGGG AAGGGGTGGA CCGACGGAAA GCCAAAGATG CTAAAGACCC ACCGGTGGCT
    GAAGACCCTA ATGGGGTCAT TGCGATGGTG GAACCAGTCA GTGGACCGTT CTCACATCTG
    GAAAACTCAG GGGAAGAGGA GTGTATGGGG GCAGCTGCTC CCTTGGGCCC CCCTGTGTGT
    GGCGTGGAGC TGGACTCACT CATCTCCCAA GTGAAGGACC TGCTGCCAGA TCTTGGTGAG
    GGCTTCATCC TGGCCTGCCT GGAGCATTAC AGCTACAACC CGGAGCAGGT GATCAACAAC
    ATCCTGGAGG AGCGGCTGGC CCCTGCCCTC AGCCAGCTGG ACCGCAGCCT AGACAGACAG
    GTGAAACCAG ACCCGACACC CCTGCTCACA TCTCGTCACA ACGTCTTCCA GAACGATGAG
    TTTGATGTGT TCAGCAGAGA TACAGTGGAC CTGAGCCGGG TGCATAAAGG CAGGAGGAAG
    GAGGAGAACA CGCGGAGCCT GCTGAACGAC AAGCGGGAGG TGGTGGCACA GCGGCAGCGC
    TACGAGCAGT ACAGCGTGGT GGTGGAGGAG GTGCCGCTGC AGCCAGGTGA GGGCCTGCCC
    TATCGCGGGG ATGACTATGA GGATGAGTAC GATGACACGT ACGATGGCAA CCAGGTGGGC
    GCCAACGATG CTGACTCGGA TGATGAGCTC ATCAGCCGCA GGCCCTTCAC CATCCCTCAG
    GTGCTGAGAA CCAAAGTGCC TGGAGAAGGG CAGGAAGAGG ACGAAGATGA GGAGGAGGAG
    GAGGCTGAGG ACGAGGCTCC CAAGCCCGAC CATTTTGTGC AGGACCCAGC AGTGTTGCGG
    GAGAAAGCAG AAGCCAGGCG CATGGCCTTC CTTGCCAGGA AGGGGTACCG GCACGACAGC
    TCCACGGCAG TGGCCGGCAG CCCCCGGGGC CACGGGCAGA ACCGTGAGAC AACCCAGGAA
    CGCAGGAAGA AGGAAGCCAA CAAGGCGACG CGAGCCAACC ATAACCGGAG AACCATGGCT
    GACCGCAAAA GAAGCAAAGG CATGATTCCA TCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAc247716
    Clone ID Related Accession (Same CDS sequence) XM_027050872.1
    Accession Version XM_027050872.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2097bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-11-12
    Organism Acinonyx jubatus(cheetah)
    Product activating signal cointegrator 1 complex subunit 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_020834823.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Acinonyx jubatus Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GGTTATCTTC GATGAAACCC TGCAGAAGTG CCTGGACTCC
    TATCTGCGCT ATGTCCCCCG AAAGTTCGAC GAGTGGGTGG CCCCGGCCCC TGAGGTTGTT
    GACATGCAGA AACGGCTCCA TCGAAGTGTT TTCCTCACCT TCCTCCGCAT GTCCACTCAT
    AAGGAATCCA AAGATCACTT CATTTCCCCC TCTGCATTTG GAGAAATCCT CTACAATAAC
    TTCCTGTTTG ACATCCCAAA GATCCTGGAT CTCTGCGTGC TCTTTGGAAA AGGCAACTCG
    CCATTGCTCC AGAAGATGAT AGGGAACATC TTTATCCAGC AGCCAAGTTA CTATAATGAC
    CTGGATGAAA CCATGCCCAC CATCCTTCAG GTTTTTAGCA ATATCCTCCA GCACTGTGGT
    TTGCAAGGGG ATGGGGCCAG CGCCACACCC CAGAAGCTTG AGGAGAGGGG CCGGTTGACC
    CCCAGCGACA TGCCTCTCCT GGAATTAAAA GACATTGTTC TCTACCTTTG CGATACCTGC
    ACTACACTCT GGGCCTTTCT GGATATCTTC CCTTTGGCTT GCCAAACCTT CCAGAAACAT
    GACTTCTGTT ACAGACTAGC TTCCTTTTAT GAAATTGCAA TTCCCGAACT GGAGTCTGCA
    ATTAAGAAGA GGAGGCTTGA AGATAGCAAG CTGCTAGGTG ACCTGTGGCA GAGGCTGTCC
    CATTCCAGGA AGAAGCTACT GGAGATTTTT CACATCCTCA TGAACCATAT TTGCCTCCTC
    CCTGTCCTGG AAAACAGCTG TGACAACATT CAGGGCTTCA TCGAAGAGTT CCTGCAGATC
    TTCAGCTCCT TGCTGCAGGA GAAGAGGTTC CTCCGGGACT ACGACACACT CTTCCCTGTG
    GCCGATGATG TCAGCTTGCT ACAACAGGCC TCAGCAGTCT TGGACGAGAC TCGGACTGCC
    TACATCCTCC AGGCAGTCGA AAGTGCTTGG GAAGGGGTGG ACCGACGGAA AGCCAAAGAT
    GCTAAAGACC CACCGGTGGC TGAAGACCCT AATGGGGTCA TTGCGATGGT GGAACCAGTC
    AGTGGACCGT TCTCACATCT GGAAAACTCA GGGGAAGAGG AGTGTATGGG GGCAGCTGCT
    CCCTTGGGCC CCCCTGTGTG TGGCGTGGAG CTGGACTCAC TCATCTCCCA AGTGAAGGAC
    CTGCTGCCAG ATCTTGGTGA GGGCTTCATC CTGGCCTGCC TGGAGCATTA CAGCTACAAC
    CCGGAGCAGG TGATCAACAA CATCCTGGAG GAGCGGCTGG CCCCTGCCCT CAGCCAGCTG
    GACCGCAGCC TAGACAGACA GGTGAAACCA GACCCGACAC CCCTGCTCAC ATCTCGTCAC
    AACGTCTTCC AGAACGATGA GTTTGATGTG TTCAGCAGAG ATACAGTGGA CCTGAGCCGG
    GTGCATAAAG GCAGGAGGAA GGAGGAGAAC ACGCGGAGCC TGCTGAACGA CAAGCGGGAG
    GTGGTGGCAC AGCGGCAGCG CTACGAGCAG TACAGCGTGG TGGTGGAGGA GGTGCCGCTG
    CAGCCAGGTG AGGGCCTGCC CTATCGCGGG GATGACTATG AGGATGAGTA CGATGACACG
    TACGATGGCA ACCAGGTGGG CGCCAACGAT GCTGACTCGG ATGATGAGCT CATCAGCCGC
    AGGCCCTTCA CCATCCCTCA GGTGCTGAGA ACCAAAGTGC CTGGAGAAGG GCAGGAAGAG
    GACGAAGATG AGGAGGAGGA GGAGGCTGAG GACGAGGCTC CCAAGCCCGA CCATTTTGTG
    CAGGACCCAG CAGTGTTGCG GGAGAAAGCA GAAGCCAGGC GCATGGCCTT CCTTGCCAGG
    AAGGGGTACC GGCACGACAG CTCCACGGCA GTGGCCGGCA GCCCCCGGGG CCACGGGCAG
    AACCGTGAGA CAACCCAGGA ACGCAGGAAG AAGGAAGCCA ACAAGGCGAC GCGAGCCAAC
    CATAACCGGA GAACCATGGC TGACCGCAAA AGAAGCAAAG GCATGATTCC ATCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_026906673.1
    CDS119..2215
    Translation

    Target ORF information:

    RefSeq Version XM_027050872.1
    Organism Acinonyx jubatus(cheetah)
    Definition Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_027050872.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GGTTATCTTC GATGAAACCC TGCAGAAGTG CCTGGACTCC
    TATCTGCGCT ATGTCCCCCG AAAGTTCGAC GAGTGGGTGG CCCCGGCCCC TGAGGTTGTT
    GACATGCAGA AACGGCTCCA TCGAAGTGTT TTCCTCACCT TCCTCCGCAT GTCCACTCAT
    AAGGAATCCA AAGATCACTT CATTTCCCCC TCTGCATTTG GAGAAATCCT CTACAATAAC
    TTCCTGTTTG ACATCCCAAA GATCCTGGAT CTCTGCGTGC TCTTTGGAAA AGGCAACTCG
    CCATTGCTCC AGAAGATGAT AGGGAACATC TTTATCCAGC AGCCAAGTTA CTATAATGAC
    CTGGATGAAA CCATGCCCAC CATCCTTCAG GTTTTTAGCA ATATCCTCCA GCACTGTGGT
    TTGCAAGGGG ATGGGGCCAG CGCCACACCC CAGAAGCTTG AGGAGAGGGG CCGGTTGACC
    CCCAGCGACA TGCCTCTCCT GGAATTAAAA GACATTGTTC TCTACCTTTG CGATACCTGC
    ACTACACTCT GGGCCTTTCT GGATATCTTC CCTTTGGCTT GCCAAACCTT CCAGAAACAT
    GACTTCTGTT ACAGACTAGC TTCCTTTTAT GAAATTGCAA TTCCCGAACT GGAGTCTGCA
    ATTAAGAAGA GGAGGCTTGA AGATAGCAAG CTGCTAGGTG ACCTGTGGCA GAGGCTGTCC
    CATTCCAGGA AGAAGCTACT GGAGATTTTT CACATCCTCA TGAACCATAT TTGCCTCCTC
    CCTGTCCTGG AAAACAGCTG TGACAACATT CAGGGCTTCA TCGAAGAGTT CCTGCAGATC
    TTCAGCTCCT TGCTGCAGGA GAAGAGGTTC CTCCGGGACT ACGACACACT CTTCCCTGTG
    GCCGATGATG TCAGCTTGCT ACAACAGGCC TCAGCAGTCT TGGACGAGAC TCGGACTGCC
    TACATCCTCC AGGCAGTCGA AAGTGCTTGG GAAGGGGTGG ACCGACGGAA AGCCAAAGAT
    GCTAAAGACC CACCGGTGGC TGAAGACCCT AATGGGGTCA TTGCGATGGT GGAACCAGTC
    AGTGGACCGT TCTCACATCT GGAAAACTCA GGGGAAGAGG AGTGTATGGG GGCAGCTGCT
    CCCTTGGGCC CCCCTGTGTG TGGCGTGGAG CTGGACTCAC TCATCTCCCA AGTGAAGGAC
    CTGCTGCCAG ATCTTGGTGA GGGCTTCATC CTGGCCTGCC TGGAGCATTA CAGCTACAAC
    CCGGAGCAGG TGATCAACAA CATCCTGGAG GAGCGGCTGG CCCCTGCCCT CAGCCAGCTG
    GACCGCAGCC TAGACAGACA GGTGAAACCA GACCCGACAC CCCTGCTCAC ATCTCGTCAC
    AACGTCTTCC AGAACGATGA GTTTGATGTG TTCAGCAGAG ATACAGTGGA CCTGAGCCGG
    GTGCATAAAG GCAGGAGGAA GGAGGAGAAC ACGCGGAGCC TGCTGAACGA CAAGCGGGAG
    GTGGTGGCAC AGCGGCAGCG CTACGAGCAG TACAGCGTGG TGGTGGAGGA GGTGCCGCTG
    CAGCCAGGTG AGGGCCTGCC CTATCGCGGG GATGACTATG AGGATGAGTA CGATGACACG
    TACGATGGCA ACCAGGTGGG CGCCAACGAT GCTGACTCGG ATGATGAGCT CATCAGCCGC
    AGGCCCTTCA CCATCCCTCA GGTGCTGAGA ACCAAAGTGC CTGGAGAAGG GCAGGAAGAG
    GACGAAGATG AGGAGGAGGA GGAGGCTGAG GACGAGGCTC CCAAGCCCGA CCATTTTGTG
    CAGGACCCAG CAGTGTTGCG GGAGAAAGCA GAAGCCAGGC GCATGGCCTT CCTTGCCAGG
    AAGGGGTACC GGCACGACAG CTCCACGGCA GTGGCCGGCA GCCCCCGGGG CCACGGGCAG
    AACCGTGAGA CAACCCAGGA ACGCAGGAAG AAGGAAGCCA ACAAGGCGAC GCGAGCCAAC
    CATAACCGGA GAACCATGGC TGACCGCAAA AGAAGCAAAG GCATGATTCC ATCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OAc54447
    Clone ID Related Accession (Same CDS sequence) XM_015083651.1
    Accession Version XM_015083651.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2130bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-12-14
    Organism Acinonyx jubatus(cheetah)
    Product activating signal cointegrator 1 complex subunit 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_015131560.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Acinonyx jubatus Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GGTTATCTTC GATGAAACCC TGCAGAAGTG CCTGGACTCC
    TATCTGCGCT ATGTCCCCCG AAAGTTCGAC GAGTGGGTGG CCCCGGCCCC TGAGGTTGTT
    GACATGCAGA AACGGCTCCA TCGAAGTGTT TTCCTCACCT TCCTCCGCAT GTCCACTCAT
    AAGGAATCCA AAGATCACTT CATTTCCCCC TCTGCATTTG GAGAAATCCT CTACAATAAC
    TTCCTGTTTG ACATCCCAAA GATCCTGGAT CTCTGCGTGC TCTTTGGAAA AGGCAACTCG
    CCATTGCTCC AGAAGATGAT AGGGAACATC TTTATCCAGC AGCCAAGTTA CTATAATGAC
    CTGGATGAAA CCATGCCCAC CATCCTTCAG GTTTTTAGCA ATATCCTCCA GCACTGTGGT
    TTGCAAGGGG ATGGGGCCAG CGCCACACCC CAGAAGCTTG AGGAGAGGGG CCGGTTGACC
    CCCAGCGACA TGCCTCTCCT GGAATTAAAA GACATTGTTC TCTACCTTTG CGATACCTGC
    ACTACACTCT GGGCCTTTCT GGATATCTTC CCTTTGGCTT GCCAAACCTT CCAGAAACAT
    GACTTCTGTT ACAGACTAGC TTCCTTTTAT GAAATTGCAA TTCCCGAACT GGAGTCTGCA
    ATTAAGAAGA GGAGGCTTGA AGATAGCAAG CTGCTAGGTG ACCTGTGGCA GAGGCTGTCC
    CATTCCAGGA AGAAGCTACT GGAGATTTTT CACATCCTCA TGAACCATAT TTGCCTCCTC
    CCTGTCCTGG AAAACAGCTG TGACAACATT CAGGGCTTCA TCGAAGAGTT CCTGCAGATC
    TTCAGCTCCT TGCTGCAGGA GAAGAGGTTC CTCCGGGACT ACGACACACT CTTCCCTGTG
    GCCGATGATG TCAGCTTGCT ACAACAGGCC TCAGCAGTCT TGGACGAGAC TCGGACTGCC
    TACATCCTCC AGGCAGTCGA AAGTGCTTGG GAAGGGGTGG ACCGACGGAA AGCCAAAGAT
    GCTAAAGACC CACCGGTGGC TGAAGACCCT AATGGGGTCA TTGCGATGGT GGAACCAGTC
    AGTGGACCGT TCTCACATCT GGAAAACTCA GGGGAAGAGG AGTGTATGGG GGCAGCTGCT
    CCCTTGGGCC CCCCTGTGTG TGGCGTGGAG CTGGACTCAC TCATCTCCCA AGTGAAGGAC
    CTGCTGCCAG ATCTTGGTGA GGGCTTCATC CTGGCCTGCC TGGAGCATTA CAGCTACAAC
    CCGGAGCAGG TGATCAACAA CATCCTGGAG GAGCGGCTGG CCCCTGCCCT CAGCCAGCTG
    GACCGCAGCC TAGACAGACA GGTGAAACCA GACCCGACAC CCCTGCTCAC ATCTCGTCAC
    AACGTCTTCC AGAACGATGA GTTTGATGTG TTCAGCAGAG ATACAGTGGA CCTGAGCCGG
    GTGCATAAAG GCAGGAGAAA GAGAAAGAGA GAGAATACAA CTCGCCTGCT GACCGACAAG
    CGGGAGGTGG TGGCACAGCG GCAGCGCTAC GAGCAGTACA GCGTGGTGGT GGAGGAGGTG
    CCGCTGCAGC CAGGTGAGGG CCTGCCCTAT CGCGGGGATG ACTATGAGGA TGAGTACGAT
    GACACGTACG ATGGCAACCA GGTGGGCGCC AACGATGCTG ACTCGGATGA TGAGCTCATC
    AGCCGCAGGC CCTTCACCAT CCCTCAGGTG CTGAGAACCA AAGTGCCTGG AGAAGGGCAG
    GAAGAGGACG AAGATGAGGA GGAGGAGGAG GCTGAGGACG AGGCTCCCAA GATTTTTTTT
    CTCCCTTCCC CTCCACATCC CGACCATTTT GTGCAGGACC CAGCAGTGTT GCGGGAGAAA
    GCAGAAGCCA GGCGCATGGC CTTCCTTGCC AGGAAGGGGT ACCGGCACGA CAGCTCCACG
    GCAGTGGCCG GCAGCCCCCG GGGCCACGGG CAGAACCGTG AGACAACCCA GGAACGCAGG
    AAGAAGGAAG CCAACAAGGC GACGCGAGCC AACCATAACC GGAGAACCAT GGCTGACCGC
    AAAAGAAGCA AAGGCATGAT TCCATCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014939137.1
    CDS39..2168
    Translation

    Target ORF information:

    RefSeq Version XM_015083651.1
    Organism Acinonyx jubatus(cheetah)
    Definition Acinonyx jubatus activating signal cointegrator 1 complex subunit 2 (ASCC2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_015083651.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGCCATCTC TGCCCTTGGA CCAACTCCAG ATCACCCACA CGGACCTGAA GACAGGAAAA 
    CTGAGGACTT CACCAGCGCT GGTTATCTTC GATGAAACCC TGCAGAAGTG CCTGGACTCC
    TATCTGCGCT ATGTCCCCCG AAAGTTCGAC GAGTGGGTGG CCCCGGCCCC TGAGGTTGTT
    GACATGCAGA AACGGCTCCA TCGAAGTGTT TTCCTCACCT TCCTCCGCAT GTCCACTCAT
    AAGGAATCCA AAGATCACTT CATTTCCCCC TCTGCATTTG GAGAAATCCT CTACAATAAC
    TTCCTGTTTG ACATCCCAAA GATCCTGGAT CTCTGCGTGC TCTTTGGAAA AGGCAACTCG
    CCATTGCTCC AGAAGATGAT AGGGAACATC TTTATCCAGC AGCCAAGTTA CTATAATGAC
    CTGGATGAAA CCATGCCCAC CATCCTTCAG GTTTTTAGCA ATATCCTCCA GCACTGTGGT
    TTGCAAGGGG ATGGGGCCAG CGCCACACCC CAGAAGCTTG AGGAGAGGGG CCGGTTGACC
    CCCAGCGACA TGCCTCTCCT GGAATTAAAA GACATTGTTC TCTACCTTTG CGATACCTGC
    ACTACACTCT GGGCCTTTCT GGATATCTTC CCTTTGGCTT GCCAAACCTT CCAGAAACAT
    GACTTCTGTT ACAGACTAGC TTCCTTTTAT GAAATTGCAA TTCCCGAACT GGAGTCTGCA
    ATTAAGAAGA GGAGGCTTGA AGATAGCAAG CTGCTAGGTG ACCTGTGGCA GAGGCTGTCC
    CATTCCAGGA AGAAGCTACT GGAGATTTTT CACATCCTCA TGAACCATAT TTGCCTCCTC
    CCTGTCCTGG AAAACAGCTG TGACAACATT CAGGGCTTCA TCGAAGAGTT CCTGCAGATC
    TTCAGCTCCT TGCTGCAGGA GAAGAGGTTC CTCCGGGACT ACGACACACT CTTCCCTGTG
    GCCGATGATG TCAGCTTGCT ACAACAGGCC TCAGCAGTCT TGGACGAGAC TCGGACTGCC
    TACATCCTCC AGGCAGTCGA AAGTGCTTGG GAAGGGGTGG ACCGACGGAA AGCCAAAGAT
    GCTAAAGACC CACCGGTGGC TGAAGACCCT AATGGGGTCA TTGCGATGGT GGAACCAGTC
    AGTGGACCGT TCTCACATCT GGAAAACTCA GGGGAAGAGG AGTGTATGGG GGCAGCTGCT
    CCCTTGGGCC CCCCTGTGTG TGGCGTGGAG CTGGACTCAC TCATCTCCCA AGTGAAGGAC
    CTGCTGCCAG ATCTTGGTGA GGGCTTCATC CTGGCCTGCC TGGAGCATTA CAGCTACAAC
    CCGGAGCAGG TGATCAACAA CATCCTGGAG GAGCGGCTGG CCCCTGCCCT CAGCCAGCTG
    GACCGCAGCC TAGACAGACA GGTGAAACCA GACCCGACAC CCCTGCTCAC ATCTCGTCAC
    AACGTCTTCC AGAACGATGA GTTTGATGTG TTCAGCAGAG ATACAGTGGA CCTGAGCCGG
    GTGCATAAAG GCAGGAGAAA GAGAAAGAGA GAGAATACAA CTCGCCTGCT GACCGACAAG
    CGGGAGGTGG TGGCACAGCG GCAGCGCTAC GAGCAGTACA GCGTGGTGGT GGAGGAGGTG
    CCGCTGCAGC CAGGTGAGGG CCTGCCCTAT CGCGGGGATG ACTATGAGGA TGAGTACGAT
    GACACGTACG ATGGCAACCA GGTGGGCGCC AACGATGCTG ACTCGGATGA TGAGCTCATC
    AGCCGCAGGC CCTTCACCAT CCCTCAGGTG CTGAGAACCA AAGTGCCTGG AGAAGGGCAG
    GAAGAGGACG AAGATGAGGA GGAGGAGGAG GCTGAGGACG AGGCTCCCAA GATTTTTTTT
    CTCCCTTCCC CTCCACATCC CGACCATTTT GTGCAGGACC CAGCAGTGTT GCGGGAGAAA
    GCAGAAGCCA GGCGCATGGC CTTCCTTGCC AGGAAGGGGT ACCGGCACGA CAGCTCCACG
    GCAGTGGCCG GCAGCCCCCG GGGCCACGGG CAGAACCGTG AGACAACCCA GGAACGCAGG
    AAGAAGGAAG CCAACAAGGC GACGCGAGCC AACCATAACC GGAGAACCAT GGCTGACCGC
    AAAAGAAGCA AAGGCATGAT TCCATCCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.